-

MySQL下载失败通常由网络问题引起。解决方法:1.检查网络连接,重启路由器或联系网络服务商;2.选择可靠的下载源,例如官方网站或国内镜像;3.暂时关闭或将MySQL添加到防火墙和杀毒软件白名单;4.检查并修改DNS设置,尝试使用公共DNS;5.尝试不同的浏览器或下载工具,例如wget;6.耐心等待或使用支持断点续传的工具。通过以上步骤,即可有效解决MySQL下载网络错误问题。
-

提升MySQL查询性能的核心方法包括:一、合理使用索引,仅在主键、外键或常用查询条件字段上建立索引,避免低选择性和不常查询的字段加索引;二、优化SQL语句,避免SELECT*、不在WHERE中对字段进行函数操作,使用EXPLAIN分析执行计划,并合理分页;三、调整表结构和配置参数,设计规范化的表结构并根据硬件情况调整缓冲池等系统参数;四、定期执行ANALYZETABLE和OPTIMIZETABLE,结合慢查询日志持续监控与优化。
-

选择合适的MySQL数据类型能节省存储空间、提升查询性能并确保数据准确性。常见的数据类型分为数值型(如INT、DECIMAL)、字符串型(如CHAR、VARCHAR)和日期时间型(如DATE、DATETIME、TIMESTAMP)。选择时应遵循几个关键点:1.节省存储空间,如状态字段用TINYINT;2.提高查询效率,优先使用定长类型;3.避免精度丢失,金额字段用DECIMAL;4.注意默认行为差异,如TIMESTAMP自动处理时区。常见场景推荐:用户ID用INTUNSIGNED或BIGINT,用户名用V
-

慢查询日志分析是定位并优化执行效率低的SQL语句的过程。首先,开启慢查询日志并设置合理的long_query_time阈值,如配置slow_query_log=1、指定slow_query_log_file路径及设定long_query_time为2秒等,并通过重启MySQL或执行SETGLOBAL命令使配置生效。其次,使用工具如mysqldumpslow或更强大的pt-query-digest进行日志分析,统计慢查询频率与执行时间。接着,利用EXPLAIN命令查看SQL执行计划,关注id、select_
-

配置RedisSentinel高可用集群需要以下步骤:1.配置Sentinel节点,使用sentinelmonitor指令监控主节点;2.设置主从节点,确保从节点能自动接管;3.确保网络稳定性,避免误判;4.至少配置三个Sentinel节点保证高可用性;5.谨慎配置故障转移策略,设置超时时间;6.确保数据一致性,通过配置min-slaves-to-write和min-slaves-max-lag减少数据丢失风险;7.调整sentineldown-after-milliseconds参数减少不必要的故障转移
-
优化MySQL排序性能需从四方面入手。一、建立合适索引,如为常用排序字段建索引、使用联合索引并保持顺序一致,并注意索引方向与排序方向匹配;二、避免不必要的排序,检查是否业务真正需要,或通过数据写入时预排序、调整查询逻辑来规避;三、控制排序数据量,结合WHERE条件过滤、避免大偏移分页,改用游标分页方式;四、调整系统参数,如增大sort_buffer_size提升内存排序效率,合理设置max_length_for_sort_data影响排序方式,关注临时表空间配置。
-

要处理Redis慢查询日志,首先配置Redis服务器记录慢查询,然后分析日志并优化查询。1.设置slowlog-log-slower-than和slowlog-max-len参数。2.使用SLOWLOGGET命令查看慢查询记录。3.优化查询命令,如用SCAN替代KEYS。4.重新设计数据结构,如用有序集合替代普通集合。5.使用Pipeline批量执行命令。持续监控和分析慢查询日志以优化Redis性能。
-
--cluster-replicas必须加且数值需准确,它表示每个主节点配几个从节点;若节点总数不能被(replicas+1)整除,则报错ERRInvalidclusterconfiguration。
-

<p>MySQL数据库创建的完整流程包括规划、命名、创建数据库、创建表、权限管理和最佳实践。1.规划时需考虑数据类型、规模、访问频率和扩展性。2.命名应简洁明了并与项目一致,如"projectx_db"。3.使用SQL命令创建数据库并设置字符集和排序规则,如CREATEDATABASEprojectx_dbCHARACTERSETutf8mb4COLLATEutf8mb4_unicode_ci;。4.创建表时遵循规范化设计,避免数据冗余,如CREATETABLEusers(idINTAUTO_
-
Redis不内置BloomFilter,需借助Redisson等第三方实现;EXISTS和空值缓存无法有效防穿透,因前者不拦截非法ID、后者易致缓存污染;布隆过滤器以极小空间开销提供高效存在性否定判断。
-
ZREVRANGEBYSCORE不适用于超时任务检测,因其按score降序返回,而超时检测需升序查找score≤当前时间戳的任务;正确做法是用ZRANGEBYSCOREtasks-inf[current_timestamp]配合Lua原子执行扫描与删除,并确保score为高精度到期时间戳以避免排序混乱和堆积性能问题。
-
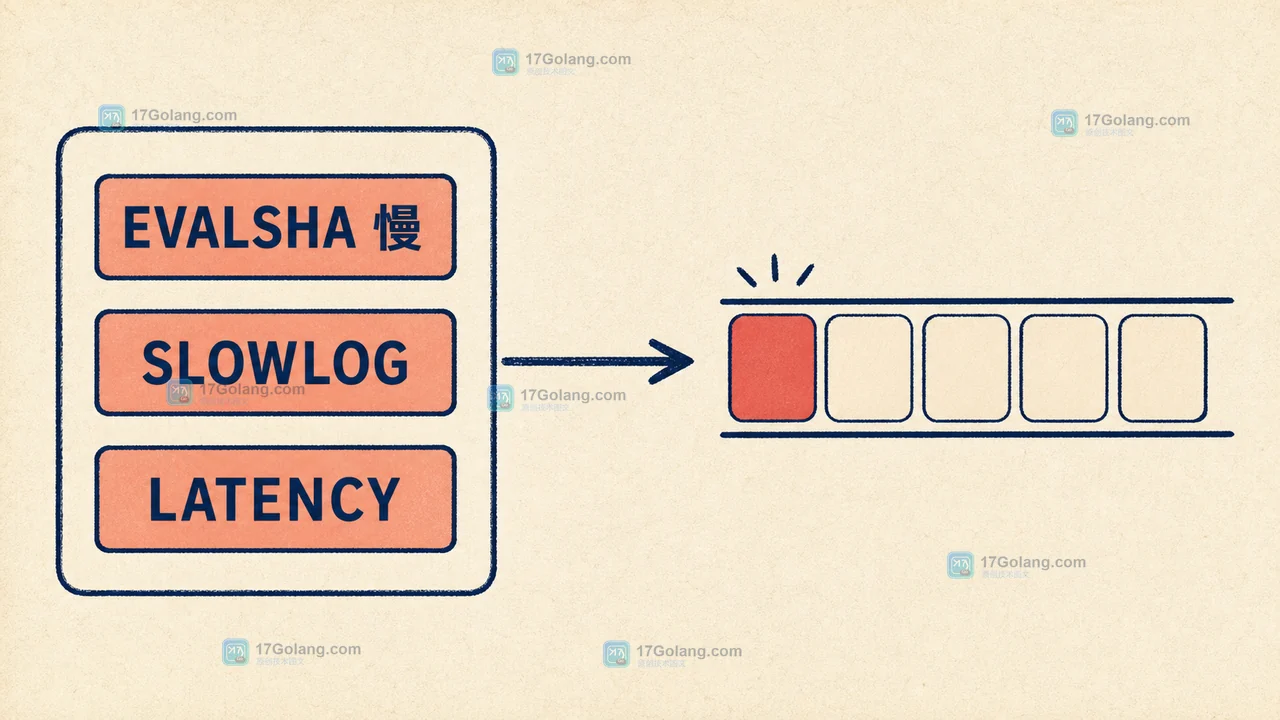
Redis Lua 脚本在单线程执行模型下可能让后续请求排队。本文从接口延迟突然升高的现象出发,用 SLOWLOG、LATENCY 和脚本耗时证据定位阻塞来源,说明超时边界、停止动作与恢复后的反向验证。
-
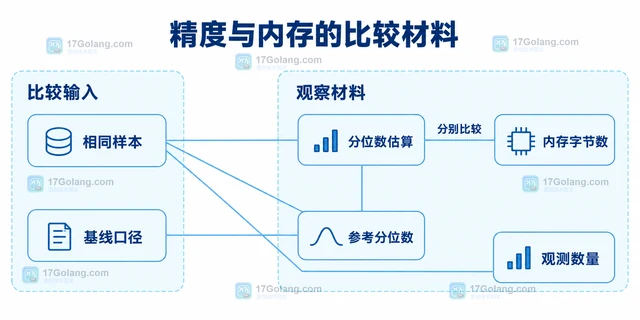
Redis t-digest的COMPRESSION用于权衡分位数估算精度与内存。本文通过两种配置的命令示例,说明相同样本、INFO内存记录、分位数基线及空摘要的处理边界,避免套用固定误差承诺。
-
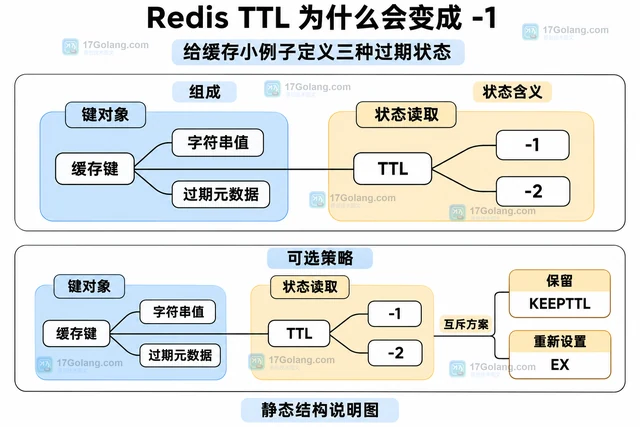
Redis TTL 返回 -1 表示键存在但没有过期时间。用小型缓存示例解释普通 SET、PERSIST 和遗漏 EXPIRE 的影响,并区分重新计时与 KEEPTTL 保留策略。
-
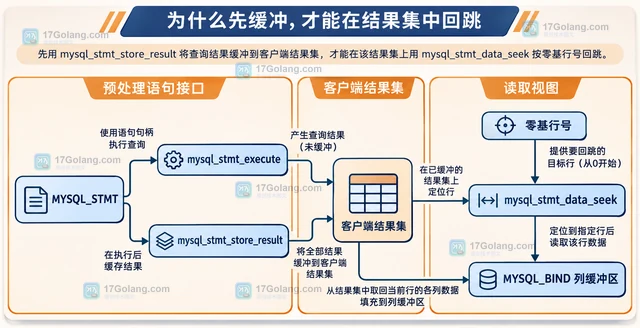
MySQL C API 的 mysql_stmt_data_seek 只能用于已经由 mysql_stmt_store_result 缓冲的预处理语句结果集。本文说明零基行号、边界判断、seek 后 fetch,以及完整缓冲带来的内存取舍。
