-

解决MySQL中文乱码问题的方法包括:1.设置数据库和表的字符集为utf8mb4;2.在应用程序连接数据库时指定字符集;3.注意数据导入导出、中间件和操作系统的字符集设置,确保与数据库一致。
-
通过调整Redis的配置参数可以显著提高其读写性能。1.内存管理:设置maxmemory为10GB,maxmemory-policy为allkeys-lru。2.网络通信:调整tcp-backlog为511,timeout为0。3.持久化:设置RDB快照频率为save9001、save30010、save6010000,AOF的appendfsync为everysec。
-
Redis和Kafka可以集成使用,发挥各自优势。1.用户行为数据先存储在Redis中,确保实时性。2.通过定时任务或触发器将数据推送到Kafka,保证数据的顺序和可靠性。3.后端系统从Kafka消费数据进行实时分析和处理,实现高效的消息队列系统。
-
Redis主从复制卡顿延迟飙升的典型表现是master_repl_offset与slave_repl_offset差值持续扩大、sync_full_ok频发,根本原因是fork子进程阻塞主线程,尤其内存大时fork耗时长导致repl-backlog溢出。
-
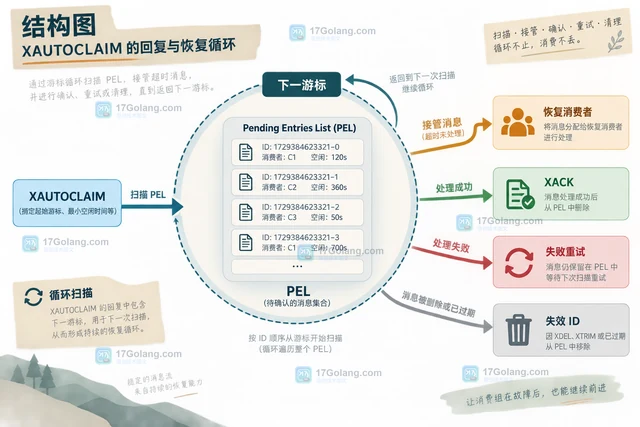
围绕 Redis Stream 消费组的 PEL,讲清 XAUTOCLAIM 的空闲阈值、批量 COUNT、返回游标、失效消息清理和 JUSTID 边界,并给出接管后幂等处理与 XACK 确认方案。
-

1、切换数据库
use information_schema;
2、查看所有数据库容量大小
select
table_schema as '数据库',
sum(table_rows) as '记录数',
sum(truncate(data_length/1024/1024, 2)) as '数据容量(MB)',
sum(truncate(index_length/1024/1024, 2))
-

子查询分类
按返回结果集分类
子查询按返回结果集的不同分为4种:表子查询,行子查询,列子查询和标量子查询。 表子查询:返回的结果集是一个行的集合,N行N列(N>=1)。表子查询经常
-

【SQL】SQL分页查询总结
开发过程中经常遇到分页的需求,今天在此总结一下吧。
简单说来方法有两种,一种在源上控制,一种在端上控制。源上控制把分页逻辑放在SQL层;端上控制一次性获取
-
Redis Big Key问题
数据量大的 key ,由于其数据大小远大于其他key,导致经过分片之后,某个具体存储这个 big key 的实例内存使用量远大于其他实例,造成内存不足,拖累整个集群的使用。big key
-
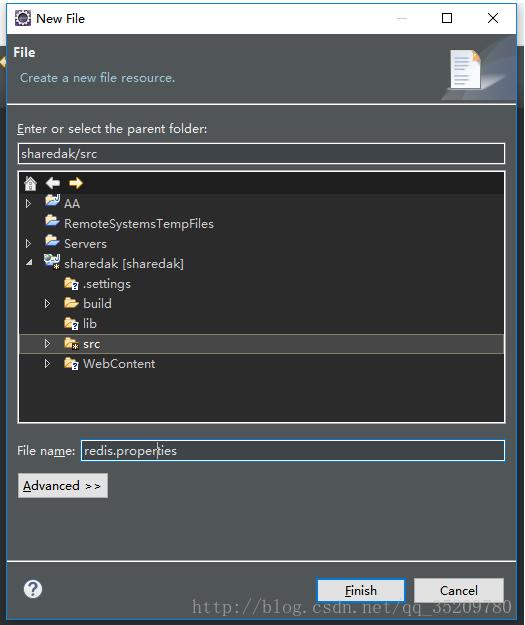
在使用到redis连接池时,需要进行一些redis相关配置,redis.properties文件是由编程者自己在项目classpath路径(如eclipse的src)下建立的,并非从redis安装包中获取的。
1.redis.properties文件的建立
在eclip
-
Redis 是目前 NoSQL 领域的当红炸子鸡,它象一把瑞士军刀,小巧、锋利、实用,特别适合解决一些使用传统关系数据库难以解决的问题。但是 Redis 不是银弹,有很多适合它解决的问题,但是也有
-

Xtrabackup备份及恢复一、主从数据库备份1、环境操作系统版本:linux-7.3-x86_64数据库版本:mysql-5.7.19-x86_64master主服务器: 172.22.23.14 slave从服务器: 172.22.23.15mysql 5.7以下版本,可以采用percona xtrab
-

2022年5月25日,阿里云开源 PolarDB-X 将升级发布新版本!PolarDB-X 从 2009 年开始服务于阿里巴巴电商核心系统, 2015 年开始对外提供商业化服务,并于 2021 年正式开源。本次发布会将重磅推出在稳
-

作者:杨奇龙网名“北在南方”,资深 DBA,主要负责数据库架构设计和运维平台开发工作,擅长数据库性能调优、故障诊断。本文来源:原创投稿*爱可生开源社区出品,原创内容未经授权不得
-

今天没有发技术文章,只是聊聊我今天让我有所感悟的关键字:模块化我们都知道在sql server里面,存储相应的功能让他变成模块化,这是为了让优秀的代码有更快的重复性,避免重构的麻烦。
