
Go语言技术文章
-
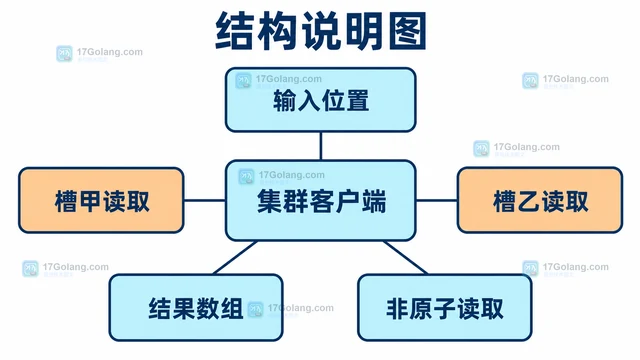 解释Cluster原生MGET的同槽限制,区分槽和节点、普通前缀与哈希标签,给出同槽命令和客户端非原子读取示例,并说明结果顺序、热点和失败语义。143 收藏
-
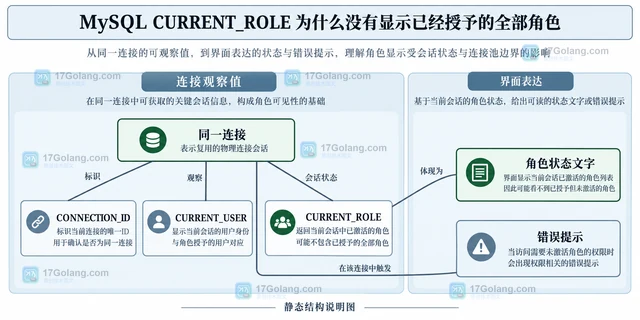 CURRENT_ROLE只显示当前会话激活的角色,不是全部授予清单。本文区分角色授予、默认策略与会话激活,给出同连接排查SQL,并说明连接池与状态提示容易混淆的地方。143 收藏
-
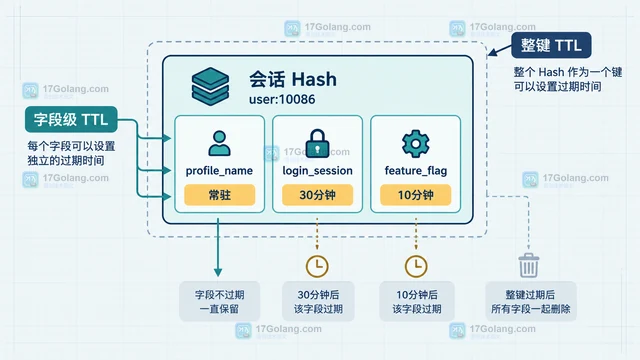 Redis 7.4 为 Hash 字段提供独立过期能力。本文用会话与属性缓存场景说明 HEXPIRE、HTTL、HPTTL 的使用边界,并比较字段级过期、整键 TTL 与拆分 key 的选择。142 收藏
-
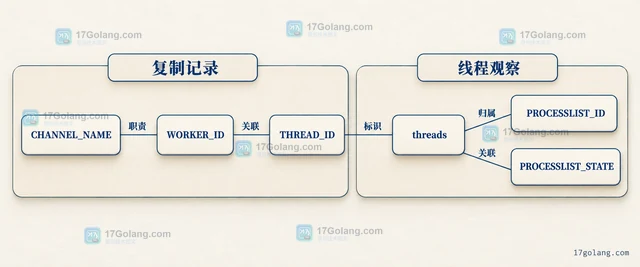 MySQL 复制延迟应按通道区分接收、协调与工作线程。本文组织只读状态报告,给出错误与事务进度查询、线程关联写法,说明 Seconds_Behind_Source 的限制及分层处理方向。141 收藏
-
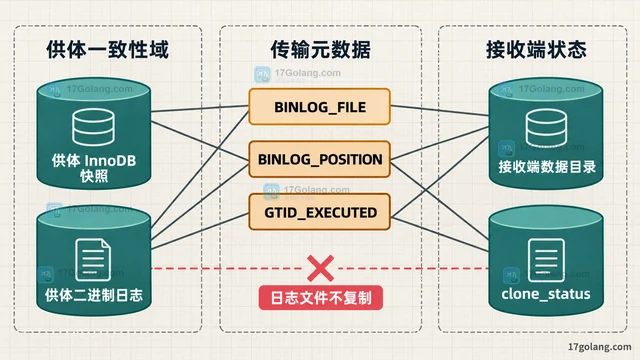 MySQL Clone 恢复后不需要重新猜复制起点。本文说明如何从 performance_schema.clone_status 读取一致性 GTID 或文件位点,分别衔接复制通道,并处理配置未克隆、日志已清理和多线程中继日志恢复失败等问题。139 收藏
-
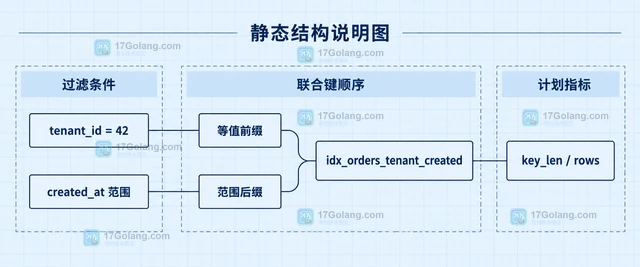 MySQL 时间范围查询没有用上索引,通常要从时间列是否被函数包裹、EXPLAIN 计划、复合索引顺序和优化器成本判断。本文用 DATETIME 半开区间给出排查与修复方法。139 收藏
-
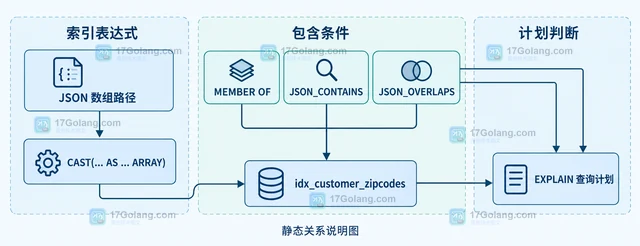 介绍 MySQL InnoDB 中用 CAST(... AS ... ARRAY) 为 JSON 数组建立 multi-valued index 的写法,说明 MEMBER OF、JSON_CONTAINS、JSON_OVERLAPS 的适用条件,以及空数组、排序、覆盖索引和在线创建等边界。139 收藏
-
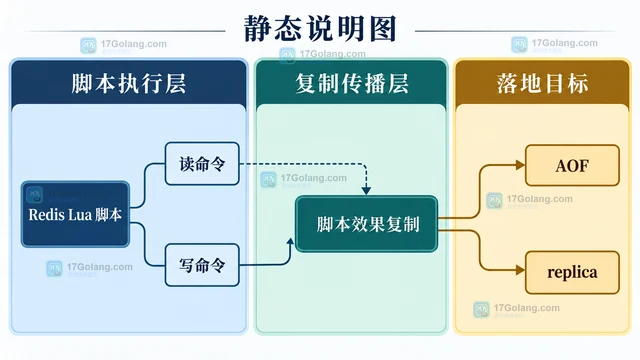 从脚本源码复制与脚本效果复制出发,解释 Redis Lua 写命令、AOF 和 replica 的传播边界,并给出可落地的确定性脚本写法。138 收藏
-
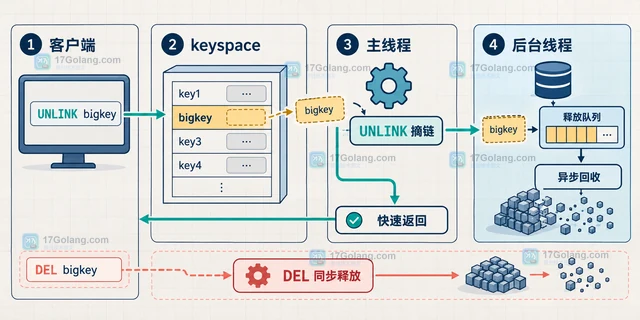 Redis 删除大键时,UNLINK 能让摘链动作快速返回,但内存回收会异步完成。本文说明 UNLINK、lazyfree 配置、回收时机和灰度排查方法。138 收藏
-
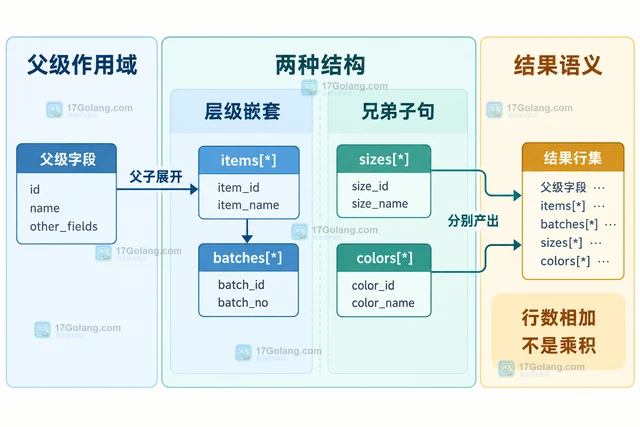 MySQL JSON_TABLE 展开多层数组的关键,是让每个 NESTED PATH 相对父级行源继续匹配,并把父级标量列定义在对应 COLUMNS 作用域中。本文用订单、商品、批次三级 JSON 给出完整 SQL,解释父级字段重复、序号列、空数组补 NULL 与兄弟子句非笛卡尔积等边界。137 收藏
-
数据库 · MySQL | 3星期前 | MySQL · 执行计划 · 查询优化 MySQL optimizer_trace 连接顺序 considered_execution_plans plan_prefix
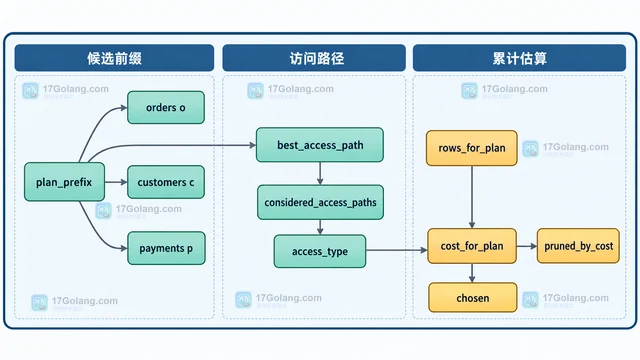 EXPLAIN 只显示最终连接顺序,optimizer_trace 则能保留候选前缀、访问路径、累计成本与剪枝原因。本文说明如何读取 considered_execution_plans、plan_prefix、best_access_path 和 chosen,并用统计信息复查优化器判断。137 收藏
-
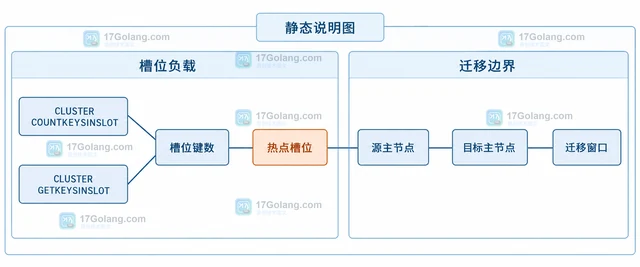 Redis Cluster 容量规划不能只看节点内存,还要同时看 16384 个槽位的覆盖情况、主节点槽位分布和热点槽位键数。本文用 redis-cli 与 Python 组织一套可复查的统计方法,说明哪些指标能帮助规划,哪些结论不能直接推出。137 收藏
-
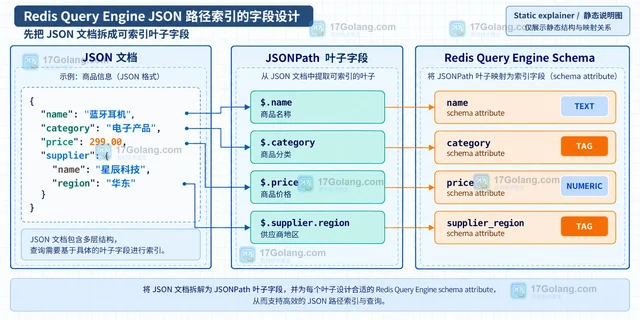 Redis Query Engine 为 JSON 建索引时,关键不是把整个对象塞进 schema,而是把 JSONPath 叶子值按查询任务映射为 TEXT、TAG 或 NUMERIC,并用别名稳定查询字段。本文给出字段设计、排序和排查方法。137 收藏
-
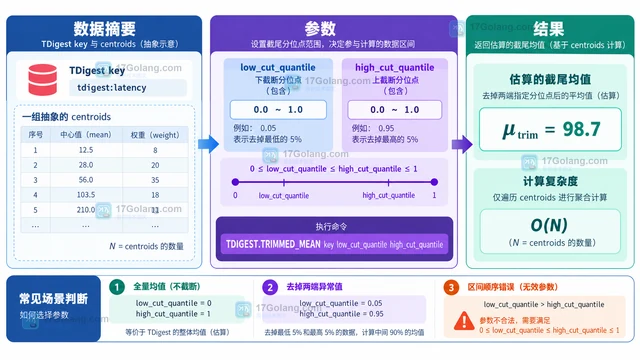 Redis TDIGEST.TRIMMED_MEAN 用两个分位点定义保留区间,排除两端观测值后,从 TDigest 摘要中估算区间内均值。本文用 0.05 到 0.95 的例子解释参数顺序、估算性质、O(N) 成本和常见错误。137 收藏
-
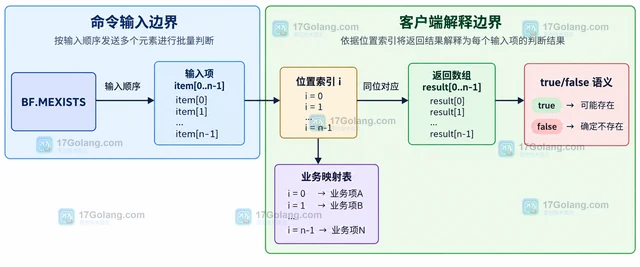 Redis BF.MEXISTS 返回的是按输入顺序排列的布尔数组。本文说明如何用位次把结果映射回原始项,并处理 Bloom Filter 的可能误判、重复值、空输入和批量异常。136 收藏