
Go语言技术文章
-
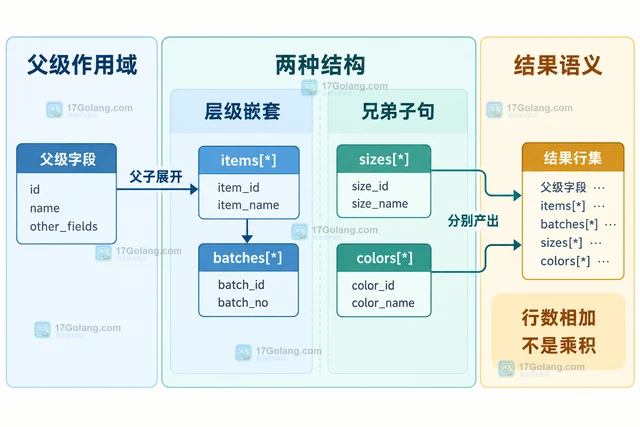 MySQL JSON_TABLE 展开多层数组的关键,是让每个 NESTED PATH 相对父级行源继续匹配,并把父级标量列定义在对应 COLUMNS 作用域中。本文用订单、商品、批次三级 JSON 给出完整 SQL,解释父级字段重复、序号列、空数组补 NULL 与兄弟子句非笛卡尔积等边界。137 收藏
-
数据库 · MySQL | 1个月前 | MySQL · 执行计划 · 查询优化 MySQL optimizer_trace 连接顺序 considered_execution_plans plan_prefix
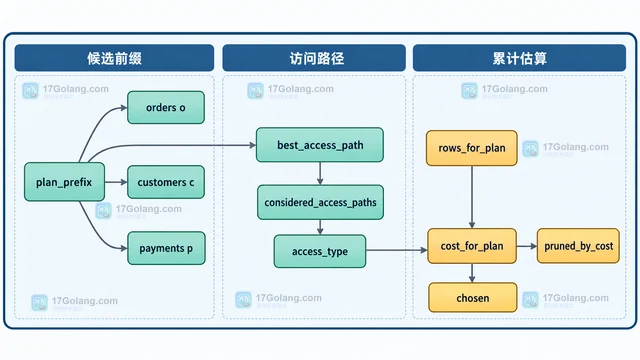 EXPLAIN 只显示最终连接顺序,optimizer_trace 则能保留候选前缀、访问路径、累计成本与剪枝原因。本文说明如何读取 considered_execution_plans、plan_prefix、best_access_path 和 chosen,并用统计信息复查优化器判断。137 收藏
-
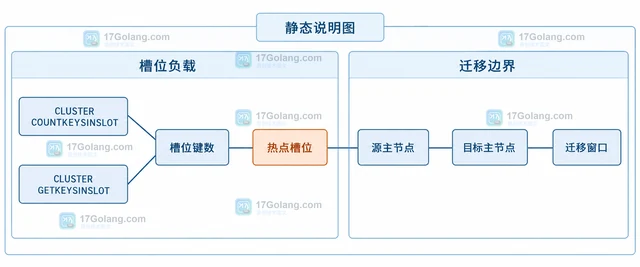 Redis Cluster 容量规划不能只看节点内存,还要同时看 16384 个槽位的覆盖情况、主节点槽位分布和热点槽位键数。本文用 redis-cli 与 Python 组织一套可复查的统计方法,说明哪些指标能帮助规划,哪些结论不能直接推出。137 收藏
-
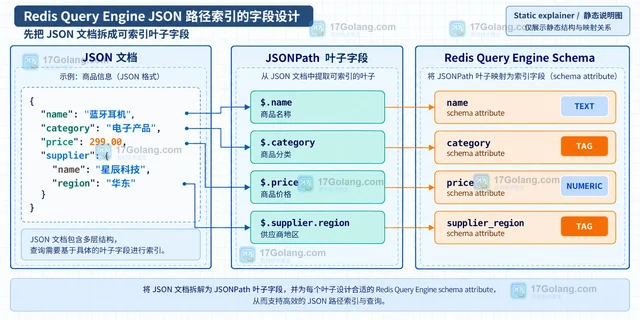 Redis Query Engine 为 JSON 建索引时,关键不是把整个对象塞进 schema,而是把 JSONPath 叶子值按查询任务映射为 TEXT、TAG 或 NUMERIC,并用别名稳定查询字段。本文给出字段设计、排序和排查方法。137 收藏
-
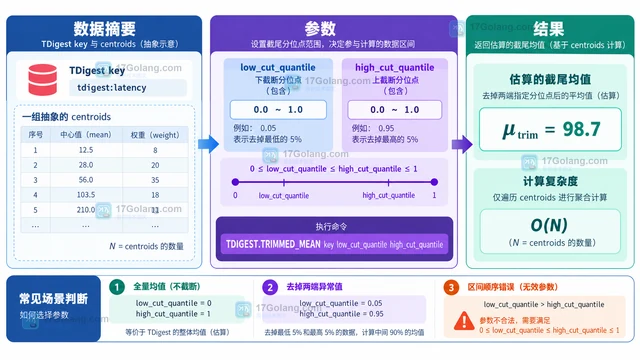 Redis TDIGEST.TRIMMED_MEAN 用两个分位点定义保留区间,排除两端观测值后,从 TDigest 摘要中估算区间内均值。本文用 0.05 到 0.95 的例子解释参数顺序、估算性质、O(N) 成本和常见错误。137 收藏
-
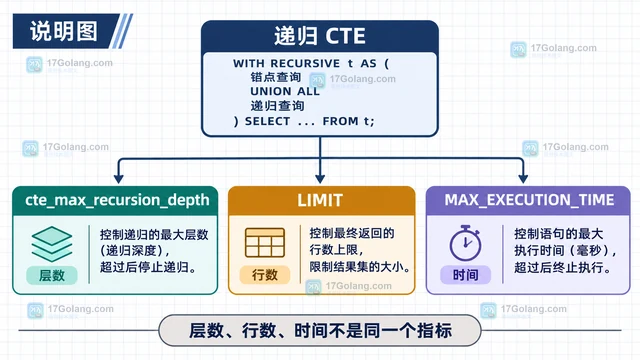 MySQL recursive CTE 的深度限制要分三层处理:递归成员用业务条件停止,SESSION cte_max_recursion_depth 控制迭代层数,再用 LIMIT 和 MAX_EXECUTION_TIME 做结果规模与耗时兜底。137 收藏
-
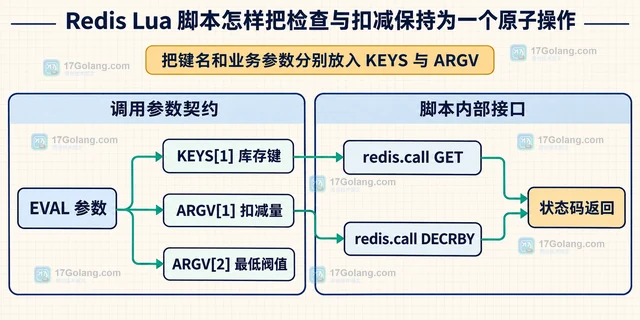 Redis Lua 脚本可以把库存读取、条件判断和扣减放进同一次原子执行。本文从 KEYS 与 ARGV 的参数边界出发,给出可返回明确状态码的检查扣减脚本,并说明 redis.call、脚本缓存和多键约束。137 收藏
-
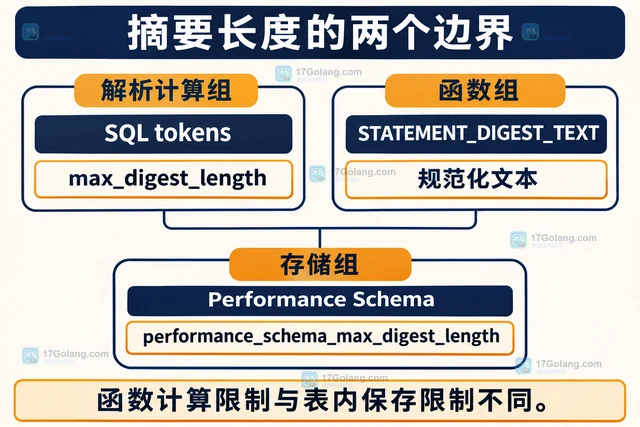 MySQL 摘要中的省略标记可能来自列表归约、长度截断或客户端显示。本文说明 max_digest_length 与 Performance Schema 保存限制,用长别名 SQL 示例帮助对比迁移前后配置和摘要变化。137 收藏
-
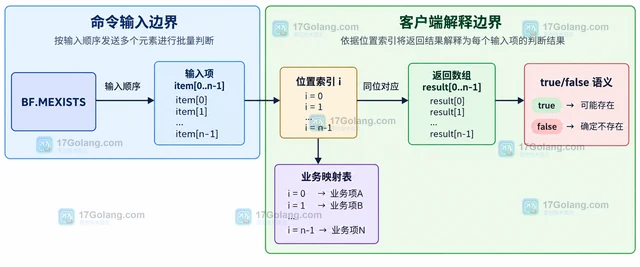 Redis BF.MEXISTS 返回的是按输入顺序排列的布尔数组。本文说明如何用位次把结果映射回原始项,并处理 Bloom Filter 的可能误判、重复值、空输入和批量异常。136 收藏
-
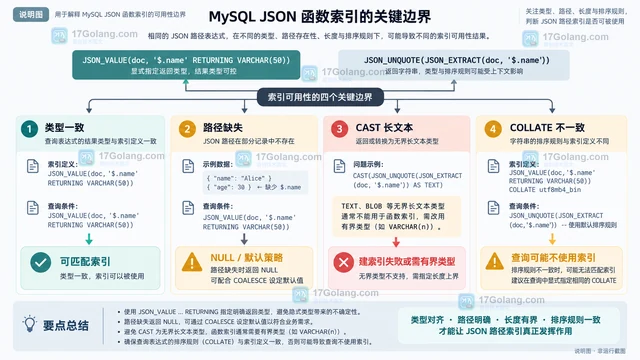 从 JSON 路径的返回类型、函数索引表达式和排序规则入手,说明怎样让 MySQL 查询真正匹配 JSON 函数索引,并给出 EXPLAIN 排查与生成列兼容方案。136 收藏
-
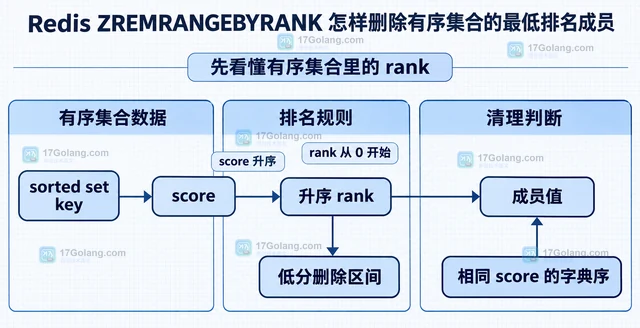 Redis ZREMRANGEBYRANK 按升序 rank 删除有序集合成员,rank 从 0 开始且 stop 包含。本文说明如何保留最高 N 名、读取删除数量,并区分按排名、分数和字典序清理。136 收藏
-
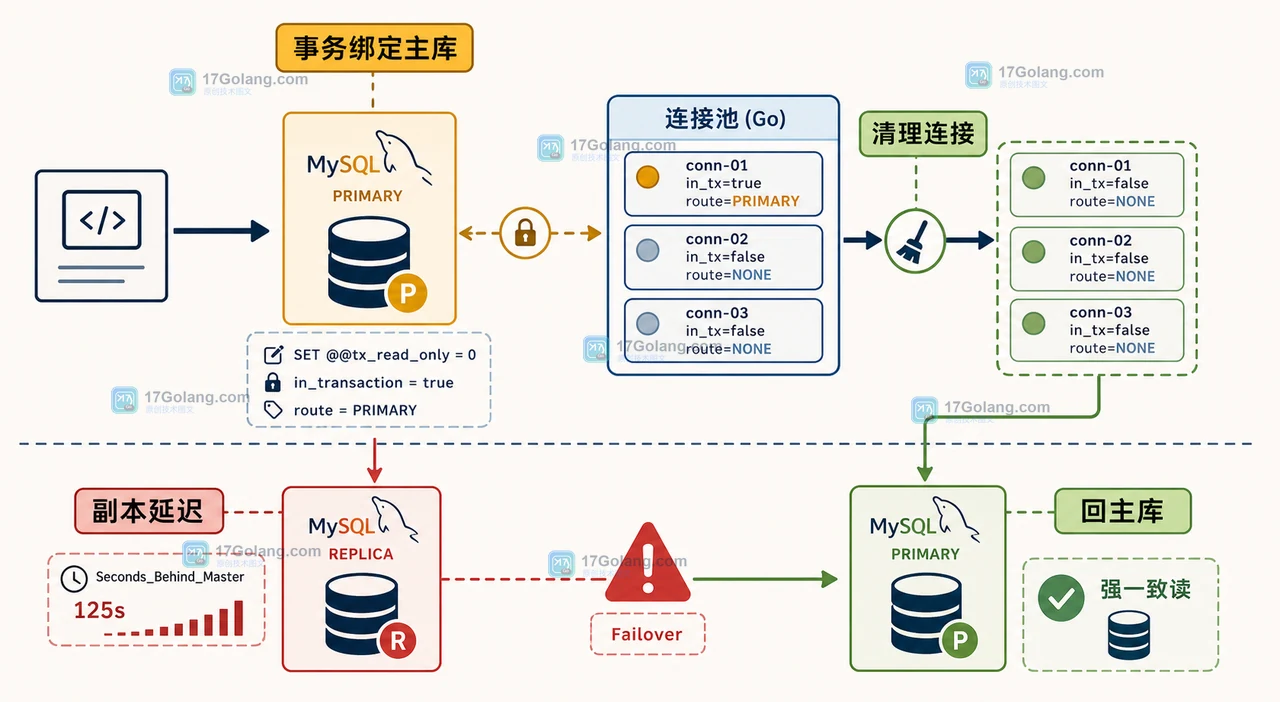 读写分离最容易出问题的地方不是把查询发到副本,而是写后读、事务边界和主副本切换时的会话状态。本文用 MySQL 8.4 的 GTID 等待与路由规则,搭一套可核对、可回切的处理方法。135 收藏
-
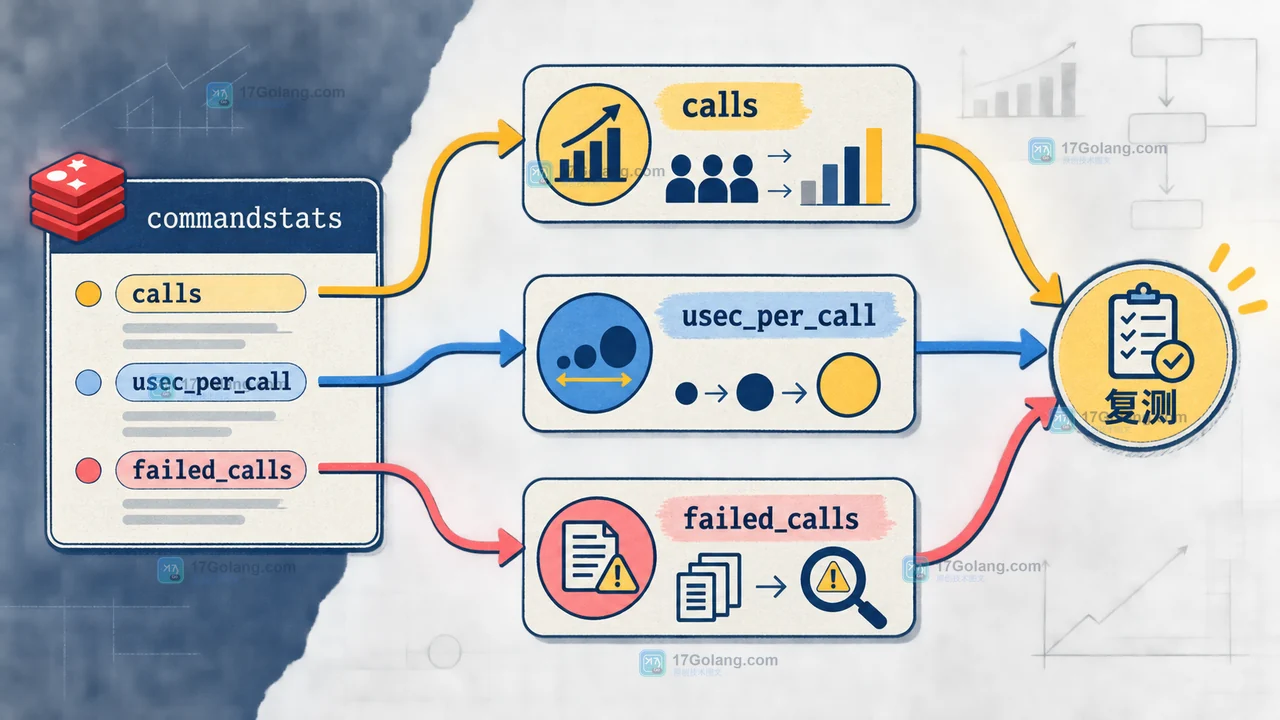 用 Redis INFO commandstats 拆解单命令 CPU 异常,理解 calls、usec、usec_per_call、failed_calls 与采样窗口的关系,并给出可复核的排查流程。135 收藏
-
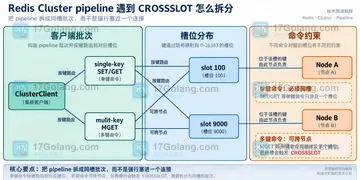 Redis Cluster 遇到 CROSSSLOT 时,先区分单键 pipeline 的跨节点分发和多键命令的跨槽约束。本文用 CLUSTER KEYSLOT、hash tag、同槽分组和 ClusterClient 示例说明如何拆分,并用批次、槽位、错误数和 P95 验证改造结果。135 收藏
-
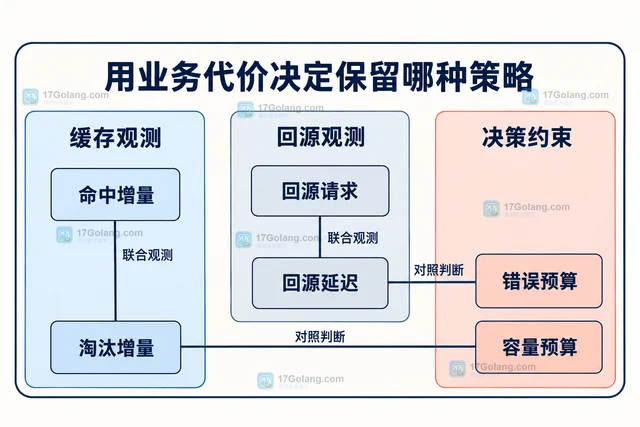 Redis 选择 LRU 或 LFU,应先确定可淘汰键范围,再根据热点稳定性建立对照。本文提供单变量切换、配置回退与同窗口观测方法,避免把命中率波动误当策略收益。135 收藏