
Go语言技术文章
-
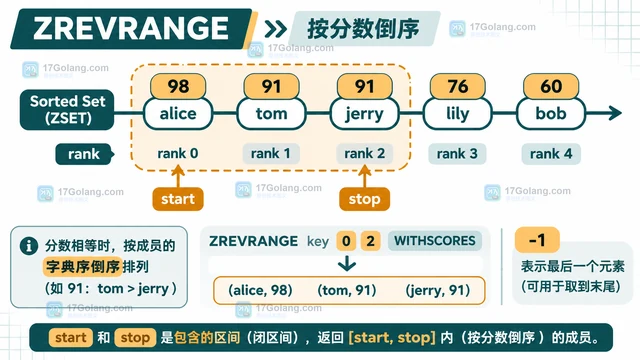 Redis ZREVRANGE 按有序集合的分数从高到低读取成员,start 和 stop 是从 0 开始且包含 stop 的排名范围,-1 表示末尾。本文用 redis-cli 说明 WITHSCORES、同分排序、空结果和 ZRANGE REV 的迁移写法。245 收藏
-
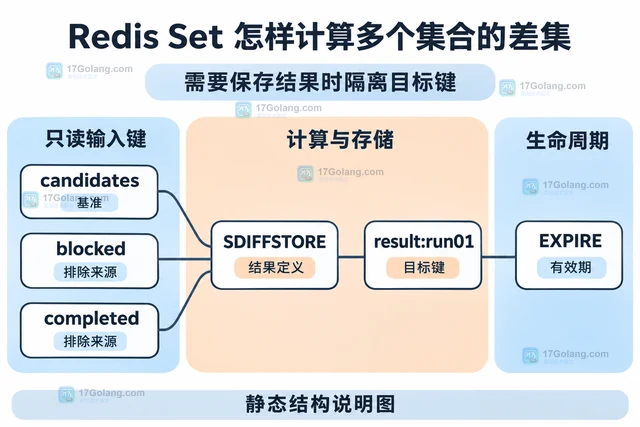 Redis SDIFF 以第一个集合为基准,排除后续所有集合的成员。通过原创名单示例说明参数顺序、缺失键、输入隔离、结果键覆盖与有效期边界。245 收藏
-
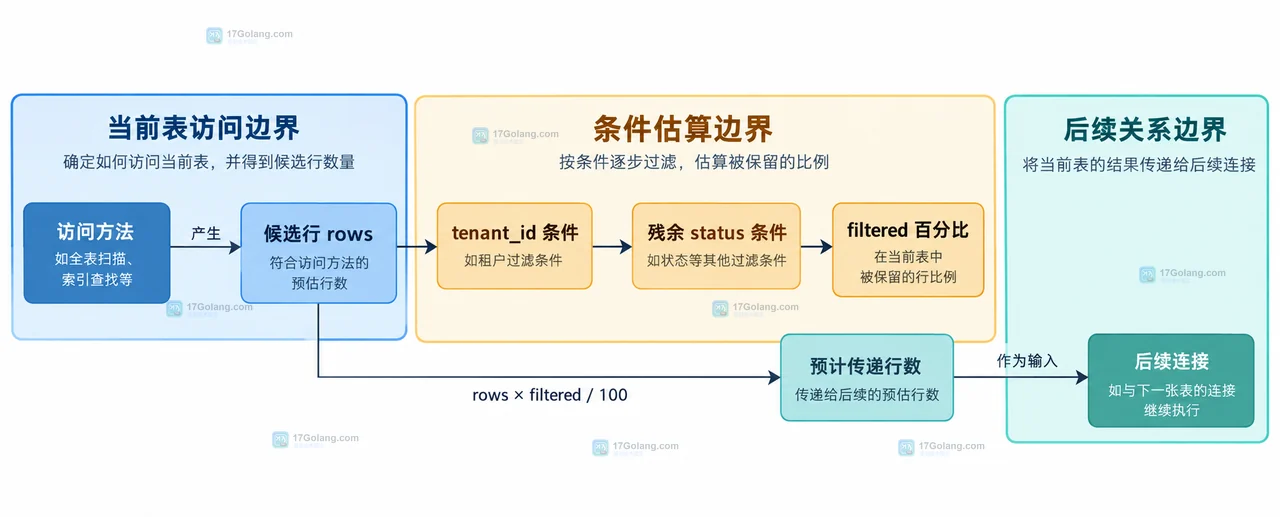 MySQL EXPLAIN 的 filtered 很低,不等于索引一定失效。本文从 rows 与 filtered 的乘积、残余条件、实际执行行数和统计信息入手,给出先查什么、何时 ANALYZE TABLE、何时再改索引的排查顺序。244 收藏
-
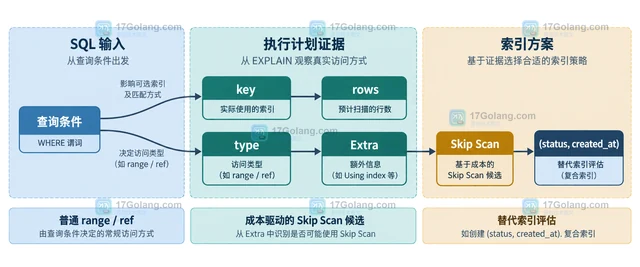 围绕 (tenant_id, status, created_at) 示例,说明跳过复合索引最左列后普通访问、Skip Scan、EXPLAIN 判断和索引调整方案。244 收藏
-
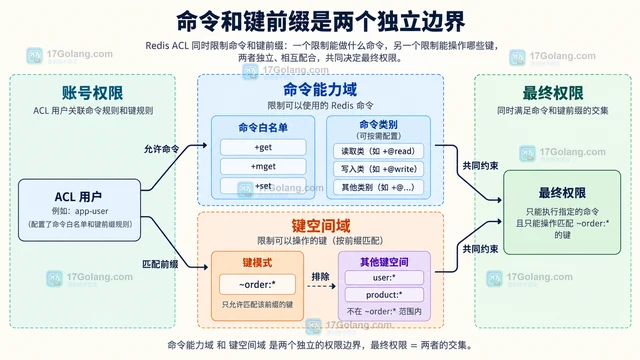 Redis ACL 需要同时配置命令白名单和键模式:命令规则决定能执行什么,~pattern 决定能访问哪些键。本文以业务账号为例,说明如何从 reset 开始定义最小权限,并用 ACL GETUSER、DRYRUN 和 LOG 检查结果。244 收藏
-
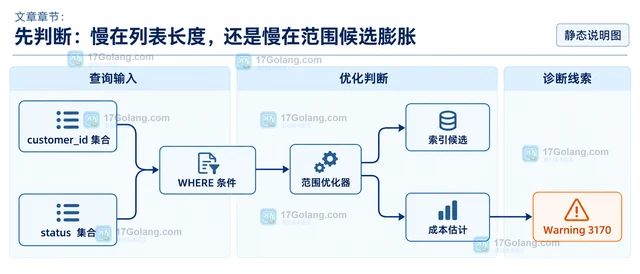 大 IN 列表的成本不只取决于参数数量,还取决于范围优化器要评估的组合规模。本文用 EXPLAIN、Warning 3170 和 optimizer trace 定位退化,并比较拆分查询与临时表 JOIN。244 收藏
-
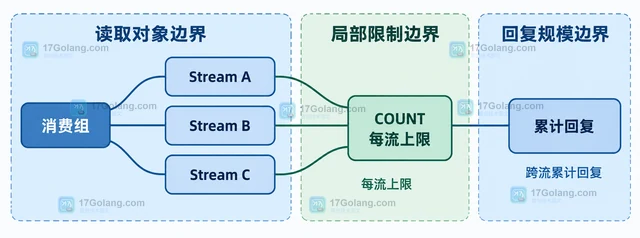 Redis XREADGROUP 的 COUNT 按每条 Stream 限制返回条数,多流读取时总量可能随流数增长;Redis 8.10 起可用 MAXCOUNT 设置跨所有流的累计条数上限,并用 MAXSIZE 控制回复体积。244 收藏
-
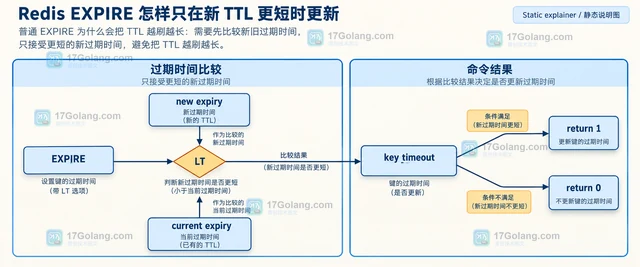 Redis EXPIRE 默认会覆盖已有 TTL。如果业务只允许新过期时间更短,可以使用 EXPIRE key seconds LT,让 Redis 在服务端比较过期时间并返回 1 或 0。本文结合 TTL、NX、XX 和 PEXPIRE 说明缓存刷新与并发场景的用法。244 收藏
-
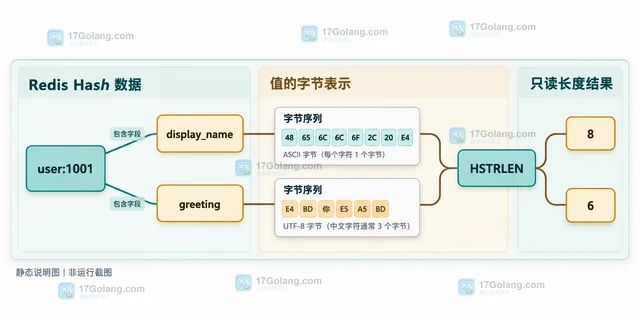 Redis HSTRLEN 用于读取 Hash 单个字段值的字节长度,本文通过英文、中文、空字符串示例区分 HSTRLEN、HLEN、字符数以及返回 0 时的缺失状态。244 收藏
-
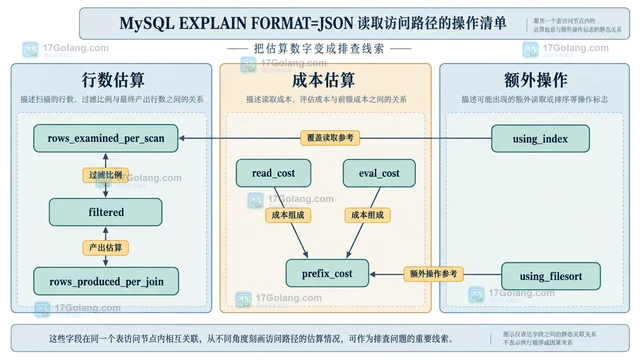 用一套固定清单读取 MySQL EXPLAIN FORMAT=JSON:先定位 query_block 和表节点,再联读访问类型、索引、估算行数、过滤条件、排序与成本,最后用真实执行证据验证优化结果。243 收藏
-
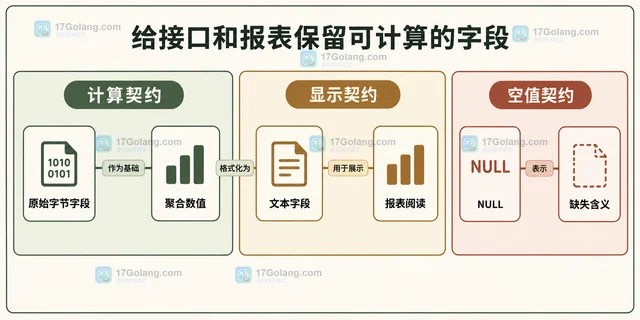 MySQL FORMAT_BYTES生成带单位的容量文本。通过原创只读SQL说明如何保留字节数排序、阈值筛选和合计,并约定NULL、接口精度与权限范围。243 收藏
-
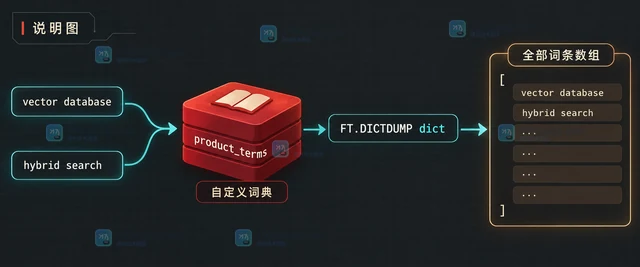 Redis FT.SYNUPDATE 默认会扫描已有文档并让新同义词参与旧文档索引;加入 SKIPINITIALSCAN 后跳过这次初始扫描,只影响更新后写入的文档。本文用最小命令示例拆开两种上线策略和迁移边界。243 收藏
-
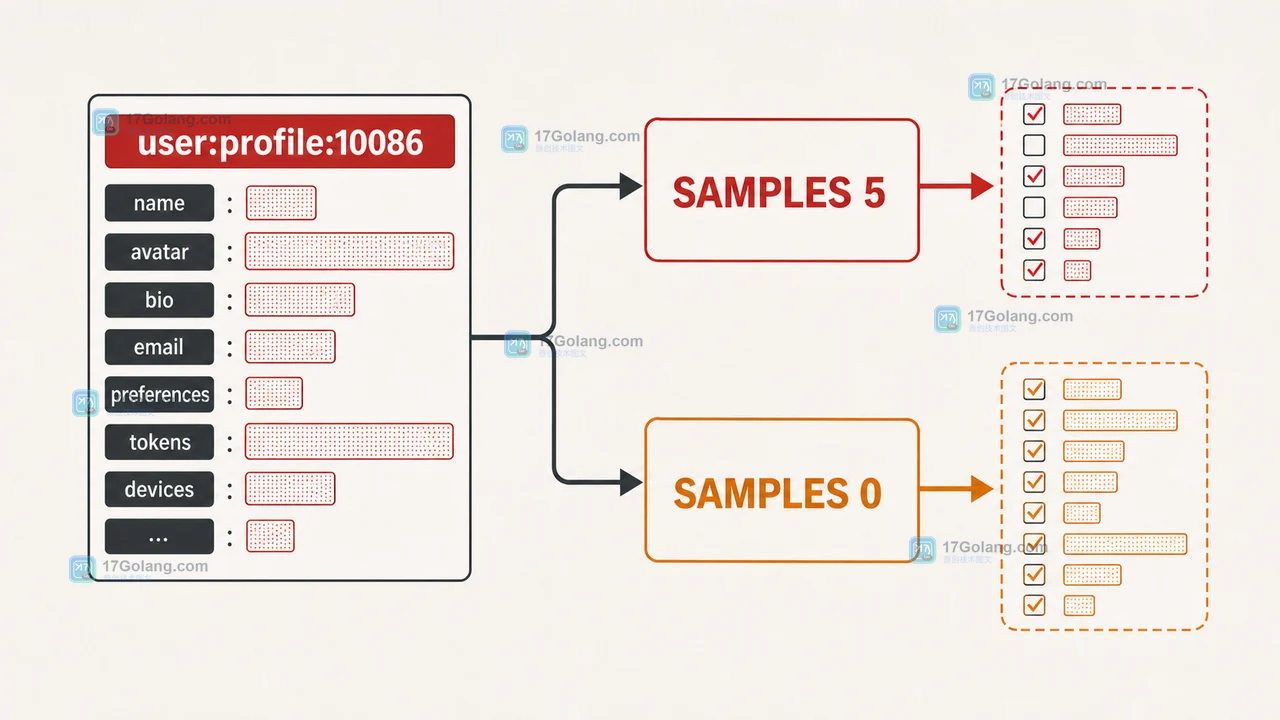 Redis MEMORY USAGE 返回的是单个键及其值的内存估算,不等于整个实例的 used_memory。理解默认 SAMPLES 5、SAMPLES 0 和 INFO memory 的边界,才能正确判断嵌套对象与容量问题。242 收藏
-
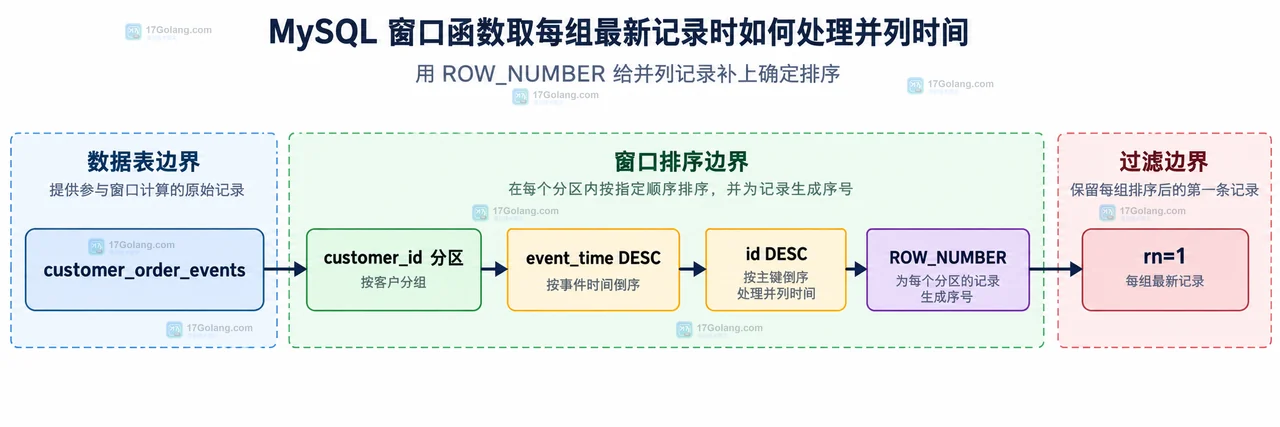 MySQL 用 ROW_NUMBER 取每组最新记录时,如果时间相同,必须补充唯一且符合业务的排序键;若要保留全部并列最新行,应改用 RANK。本文用订单状态示例说明两种写法和检查清单。242 收藏
-
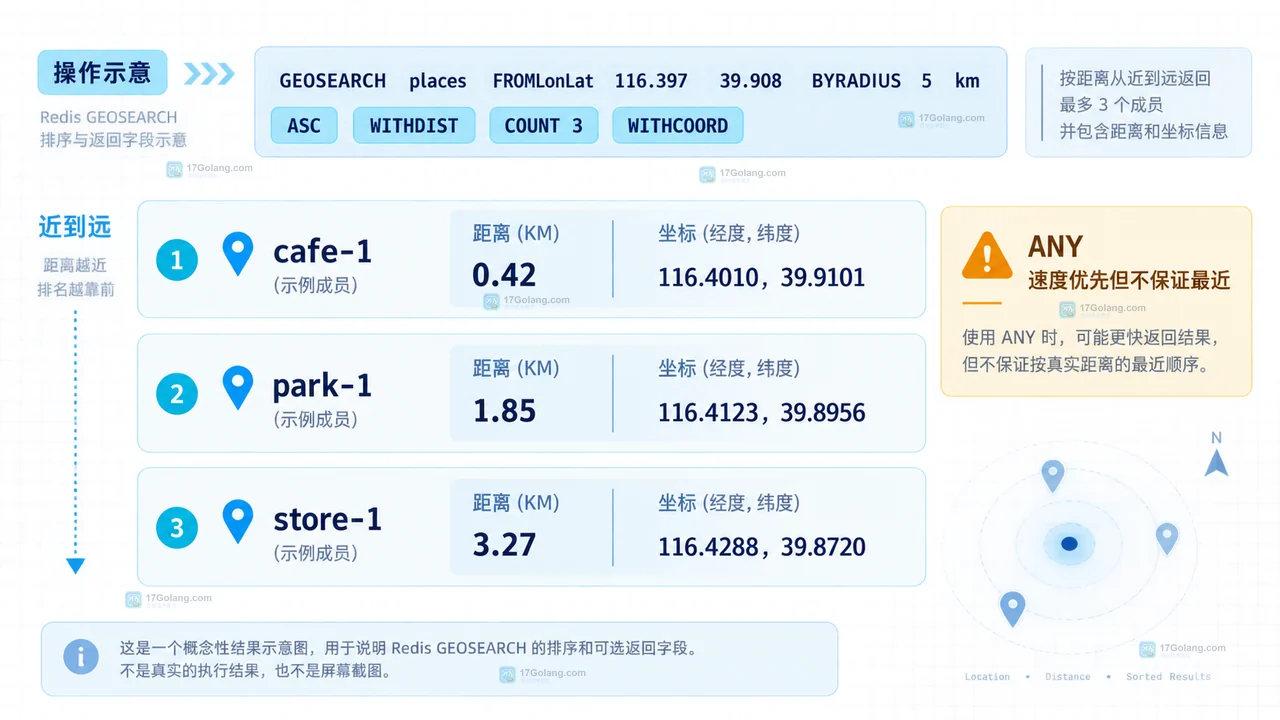 本文用 GEOSEARCH 演示 Redis 地理距离筛选,说明 FROMLONLAT、BYRADIUS、ASC、COUNT、WITHDIST 和 WITHCOORD 的组合方式,并排查空结果、单位误读、坐标顺序和 ANY 截断问题。242 收藏