-
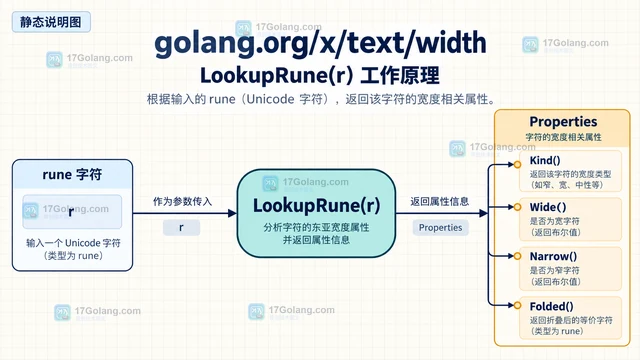
Go x/text/width 的 LookupRune 接收一个 rune 并返回 Properties。本文用一个字符检查器演示如何读取 Kind、Wide、Narrow 与 Folded,并说明它与终端显示列宽的区别。
-
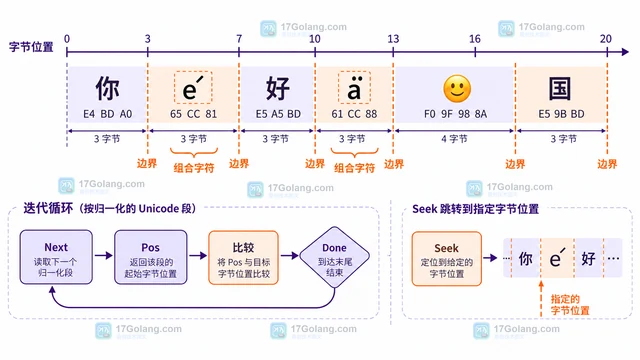
Go x/text/unicode/norm.Iter 会把输入按目标 Unicode Form 规范化,并按可独立处理的边界返回片段。本文用 Go 示例说明 InitString、Done、Next、Pos 和 Seek 的配合,以及组合字符和字节偏移的注意事项。
-
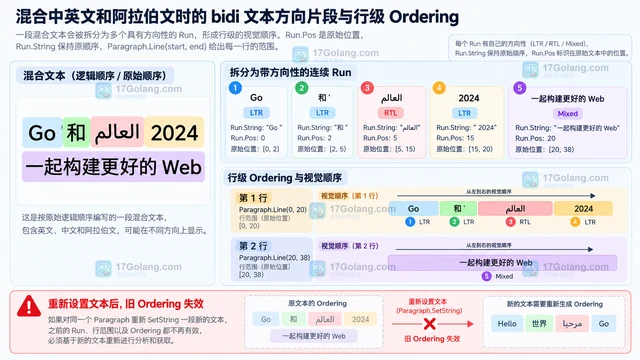
Go x/text/unicode/bidi 的 Ordering 用于保存段落的视觉顺序。本文从 Paragraph.Order 出发,演示怎样遍历 NumRuns 和 Run(i),读取每段方向、原始位置与文本,并说明行级排序、UTF-8 字节位置和重新设置段落后的失效边界。
-
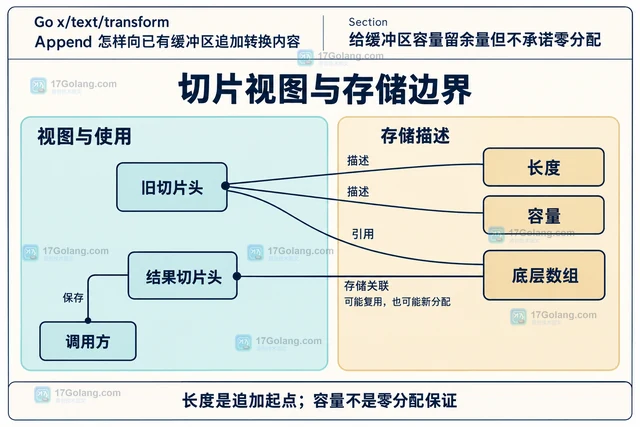
Go transform.Append 可将转换内容追加到已有字节缓冲区。本文说明 result、n、err 的含义,给出保留前缀的实现,并解释容量复用、状态重置和部分输出边界。
-
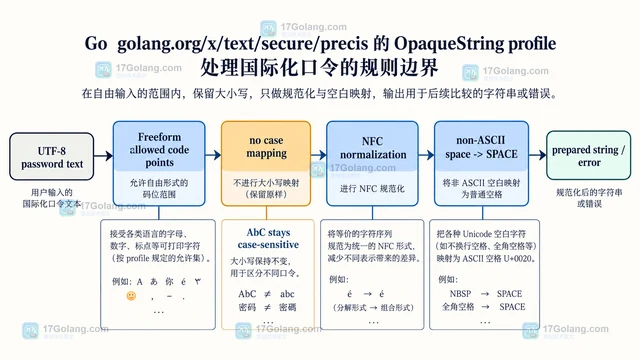
Go x/text/secure/precis OpaqueString 可以在保留大小写的前提下准备国际化口令文本。本文说明 String 的使用、NFC 规范化、空结果处理,以及准备后再哈希的落地顺序。
-
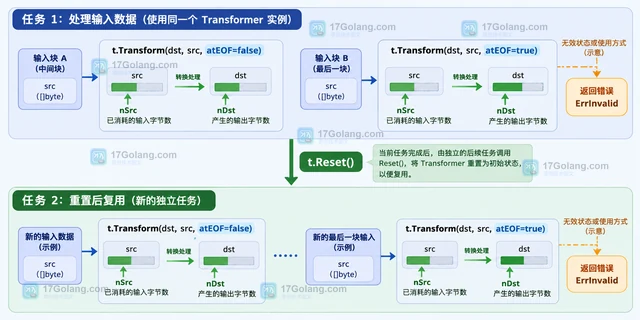
Go x/text/secure/bidirule 的 New 返回一个实现 transform.Transformer 的双向规则校验器。本文从字符串调用、分块 Transform、ErrInvalid 与 Reset 复用四个方面说明如何正确接入。
-
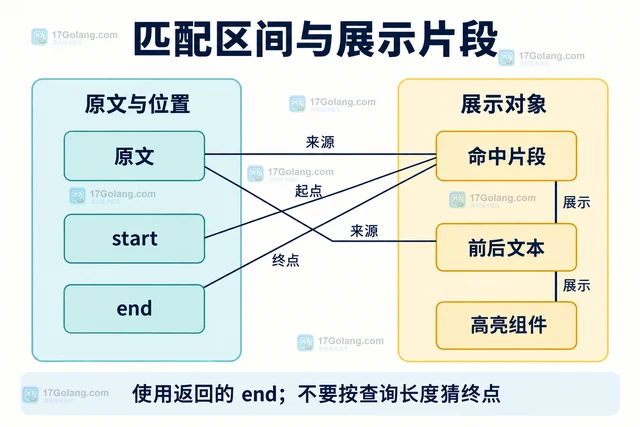
Go search.IgnoreDiacritics 可按语言规则匹配带重音文本。本文给出 IndexString 写法,说明忽略选项、未命中分支、原文区间高亮及编译 Pattern 的使用边界。
-
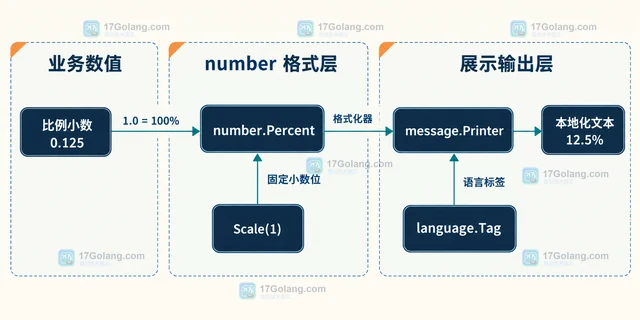
Go 的 x/text/number.Percent 适合把 0 到 1 的比例值格式化为带百分号的本地化文本。本文从输入尺度开始,说明 message.Printer、Scale、Precision 和舍入边界怎样配合,并给出可复用的封装。
-
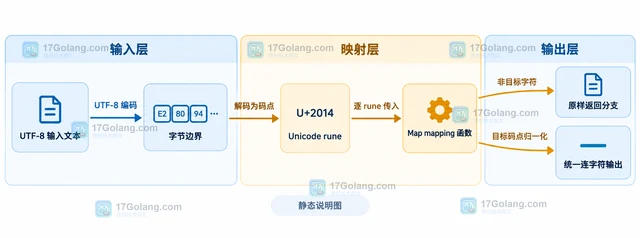
使用 Go x/text/runes.Map 按 Unicode 码点替换指定字符,掌握 transform.String、非法 UTF-8 边界以及 Map、Remove 的选择。
-
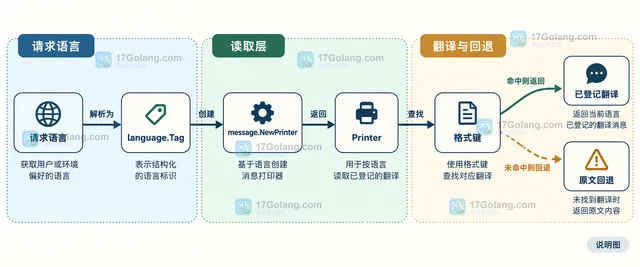
用 Go x/text/message SetString 登记不同语言的消息,再交给 Printer 按语言读取。本文从消息键、默认 catalog、语言标签和原文回退四个边界讲清写法,并整理全局登记与请求读取的工程取舍。
-
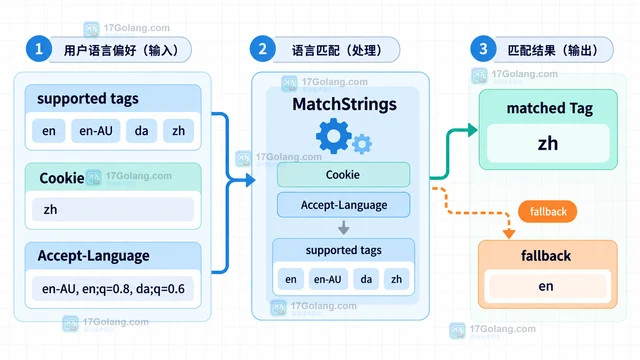
Go x/text/language Matcher 可以把用户偏好的 BCP 47 语言标签匹配到站点支持列表。本文从支持语言与回退项开始,演示 MatchStrings、返回索引和 PreferSameScript 的使用边界。
-
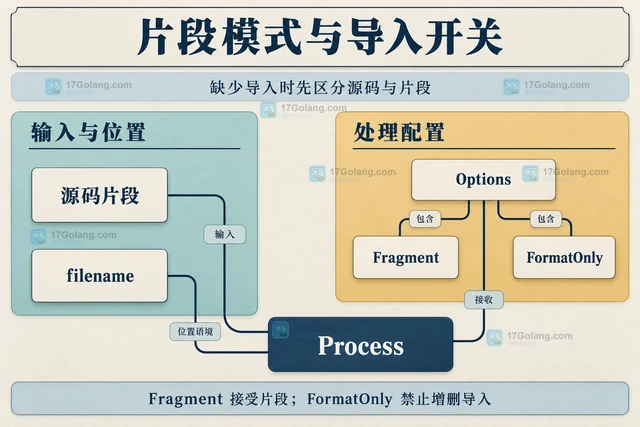
Go imports.Process 可为源码片段整理和补全导入。本文给出 Fragment 模式的声明片段处理函数,说明 FormatOnly、filename 位置语境,以及失败时保留原文的方式。
-
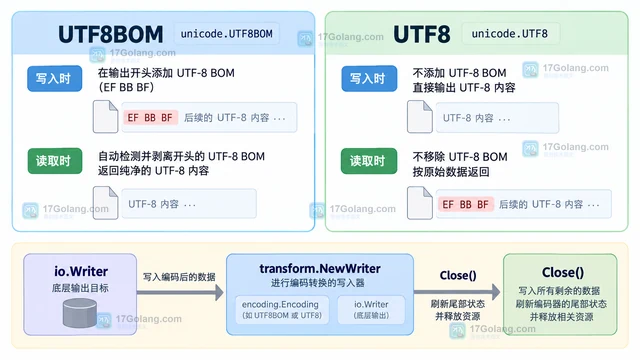
Go 的 x/text/encoding/unicode.UTF8BOM 会在编码输出开头加入 UTF-8 BOM,并在解码时剥离开头 BOM。本文比较一次性 Bytes 转换与 transform.NewWriter 流式写入,说明 EF BB BF、Close 和 UTF8 选择边界。
-
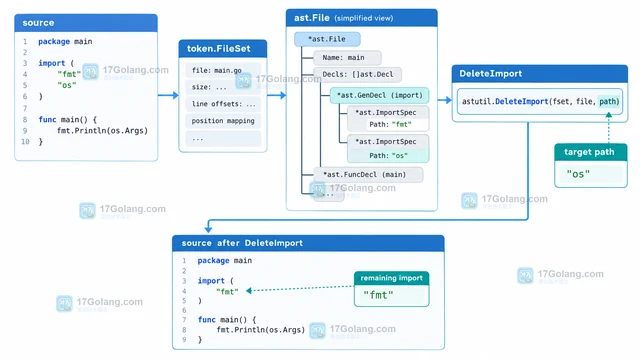
使用 Go AST 重写源码时,astutil.DeleteImport 可以按导入路径删除 import 声明。本文说明 parser.ParseFile、token.FileSet、format.Node 的配合方式,以及返回值、别名和重复导入边界。
-
Go astutil.AddImport 可以向已经解析的 ast.File 幂等加入导入路径;本文从源码解析、AST 修改、格式化写回和别名边界说明完整做法。
