-
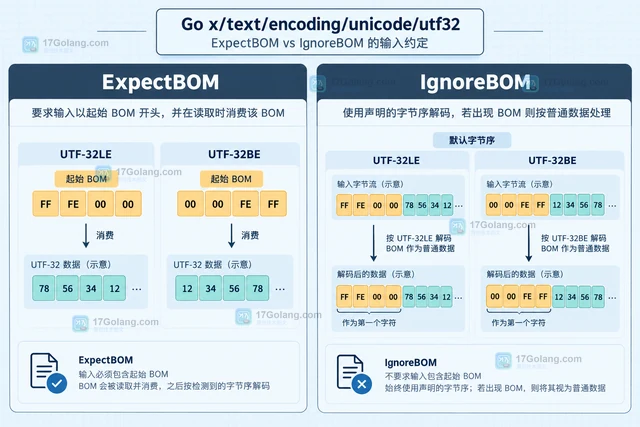
解释 Go x/text/encoding/unicode/utf32 中 ExpectBOM 与 IgnoreBOM 的解码、编码差异,给出缺失 BOM、字节序和 U+FEFF 输出的处理方法。
-
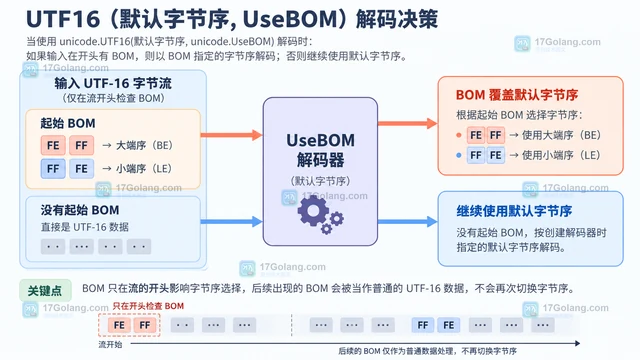
Go x/text/encoding/unicode 的 UseBOM 会在 UTF-16 输入带起始 BOM 时覆盖默认字节序,无 BOM 时再回退到默认值。本文用示例区分 UseBOM、ExpectBOM 和 IgnoreBOM。
-
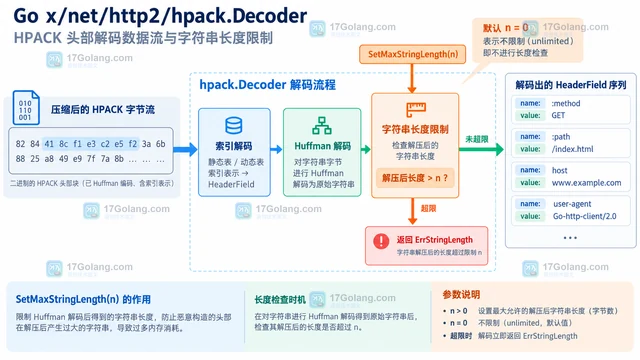
Go x/net/http2/hpack.Decoder 的输入是压缩后的 HPACK 头部块,解压后的名称和值可能更长。本文说明 SetMaxStringLength 的限制对象、ErrStringLength 的处理方式,以及增量 Write 与 Close 的生命周期边界。
-
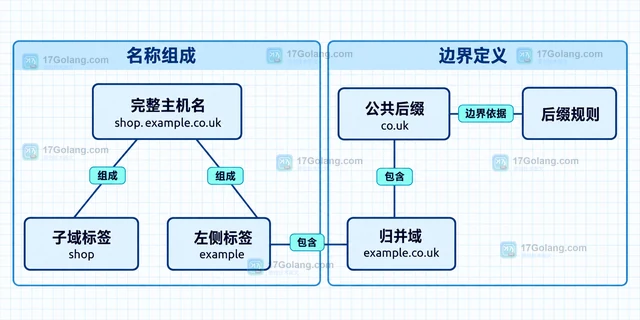
Go EffectiveTLDPlusOne 需要公共后缀左侧再有一个标签。本文解释后缀本身被拒绝的原因,给出区分结果与错误的代码,并说明归并记录与规则快照的保存方式。
-
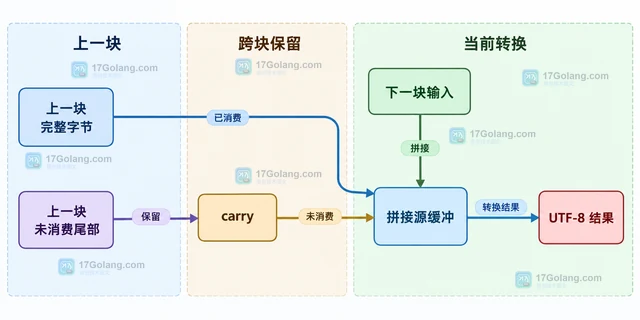
Go 使用 x/text/encoding/korean 解码 EUC-KR 分块数据时,Transform 返回的 nSrc 与 ErrShortSrc 决定了哪些字节必须带到下一块。本文结合 Decoder.Reader 和手动分块处理说明如何避免字符被截断。
-
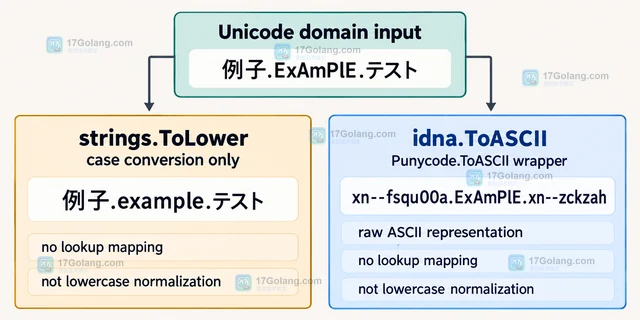
Go x/net/idna.ToASCII 不是简单的字符串转小写,而是原始 Punycode 编码入口。本文区分 ToASCII、Lookup.ToASCII 与 Registration.ToASCII 的用途,说明域名查找映射和注册校验应该怎样选择。
-
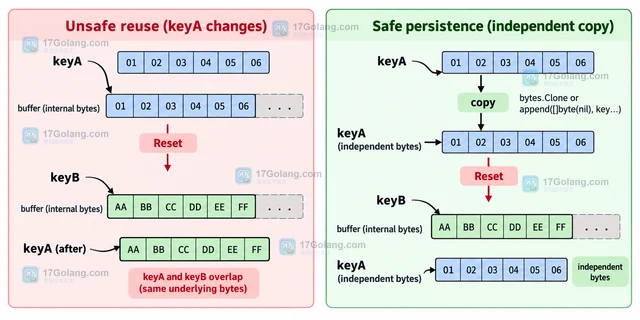
Go x/text/collate 的 KeyFromString 返回切片指向可复用 Buffer。本文说明 Reset 后旧排序键为什么不能继续依赖,以及批量排序、长期缓存和直接比较时的正确取舍。
-
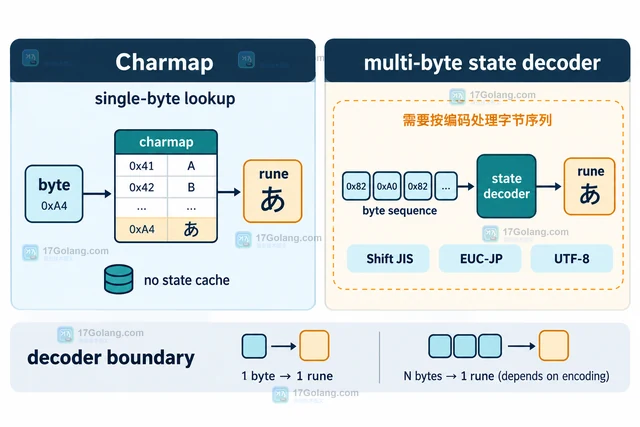
Go charmap 的 DecodeByte 面向 8-bit 单字节字符集,逐个 byte 查表即可;本文说明它与 NewDecoder、多字节编码和 UTF-8 处理的边界。
-
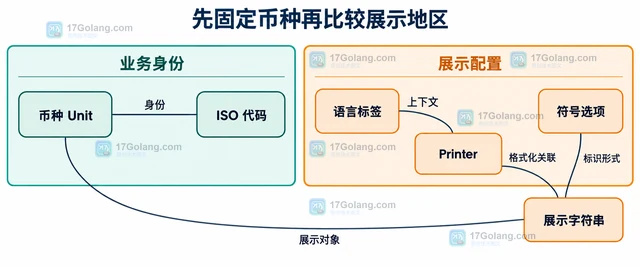
Go x/text/currency 的货币展示受币种、语言地区和符号选项影响。本文给出固定币种的对照代码,区分 Default 与 FromTag,并说明存储和缓存应如何保留币种身份。
-
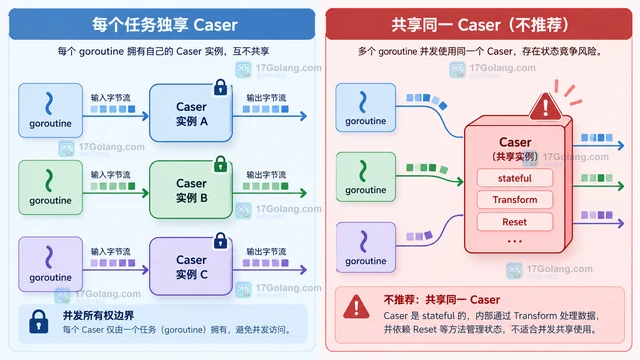
Go x/text/cases 的 Caser 可能带状态,不能因为它是值类型就直接在 goroutine 间共享。本文说明 Lower、Upper、Title、Fold 的并发边界,以及 String、Bytes、Transform 的选择。
-
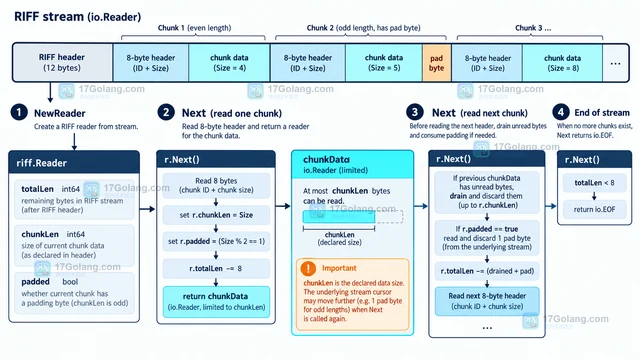
Go x/image/riff 的 chunkLen 只表示块数据长度;当数据长度为奇数时,RIFF 还会补一个 padding byte。因此下一个块偏移要同时考虑 8 字节头部、数据区和对齐字节。
-
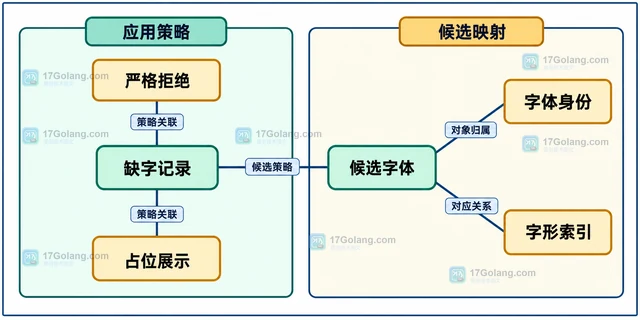
Go sfnt.GlyphIndex 返回零且无错误通常表示缺字。本文区分解析与查询错误,给出字符映射检查函数,并比较拒绝、占位和候选字体三种处理方案。
-
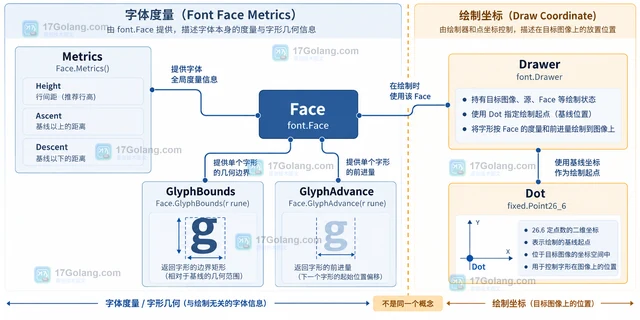
Go x/image/font/opentype 中 Size 是点值,DPI 是输出分辨率;两者共同决定 Face 的缩放比例。本文用源码关系、Metrics、GlyphBounds 和绘制坐标说明为什么字号不变时修改 DPI 会让字形变大,并给出参数选择策略。
-
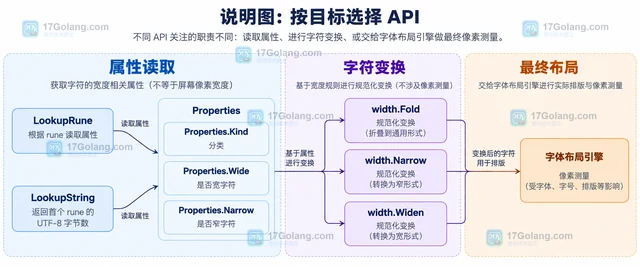
Go x/text/width 提供的是 Unicode 宽度属性分类,不是字体渲染后的屏幕像素测量。本文区分 width.Kind、rune、UTF-8 字节数和布局引擎,并给出按目标选择 API 的排查方法。
-
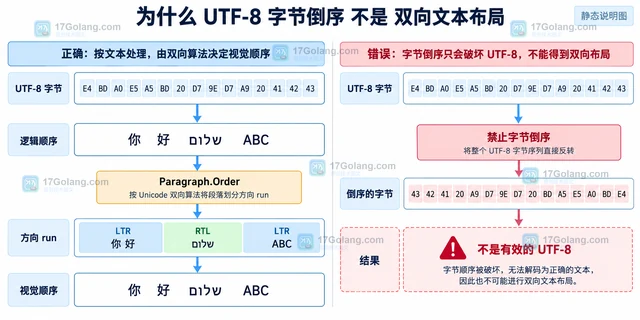
Go x/text/unicode/bidi 处理的是逻辑顺序到视觉顺序的双向文本布局,不是把 UTF-8 字节倒序。本文说明 Paragraph.Order、Ordering、Run 与 ReverseString 的职责边界,并给出混合方向文本的处理方式。
