-
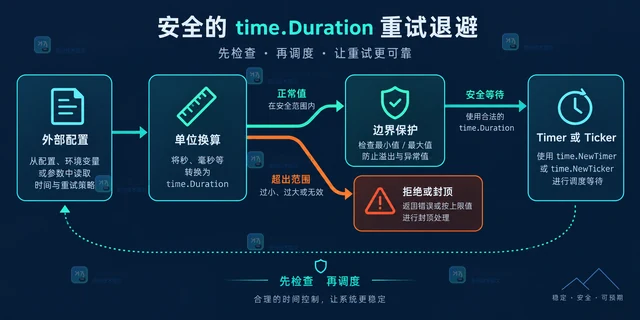
time.Duration 本质是 int64 纳秒计数,乘法、单位换算或退避累加一旦超出约 290 年范围就可能回绕成负数或异常的小值。本文从定时任务故障场景出发,给出边界判断、饱和乘法和定时器接入的 Go 实现。
-
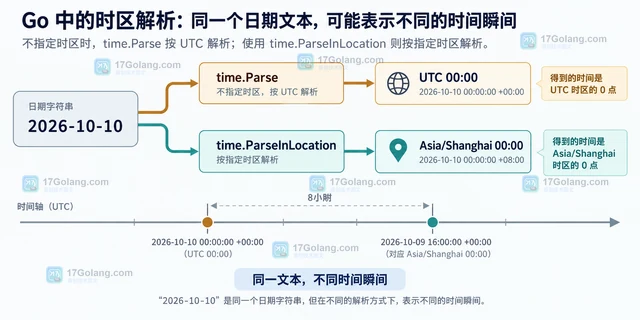
同一个无时区日期在不同机器上出现一天偏移,通常不是日期字符串变了,而是解析位置没有明确。本文从 time.Parse 的 UTC 默认行为出发,说明 time.ParseInLocation 如何绑定 Location,并处理显式偏移、时区缩写、IANA 时区加载和夏令时边界。
-
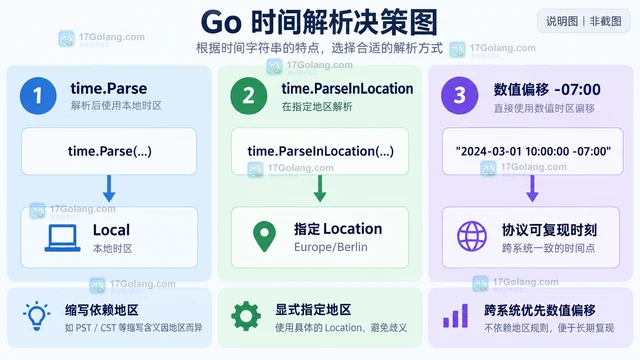
time.Parse 遇到 MST、CST、PST 等时区缩写时,会受 Local 和缩写是否已知影响。本文用 Zone、Location 和 ParseInLocation 拆开定位方法,并给出更稳定的数值偏移解析方案。
-
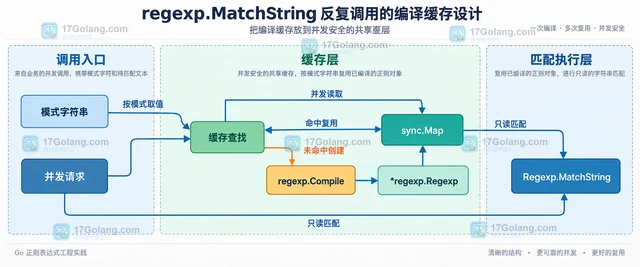
反复调用 regexp.MatchString 时,包级函数会把正则编译带进热路径。本文拆开调用链,给出固定模式与动态模式两种缓存设计,并处理并发、编译失败和容量边界。
-
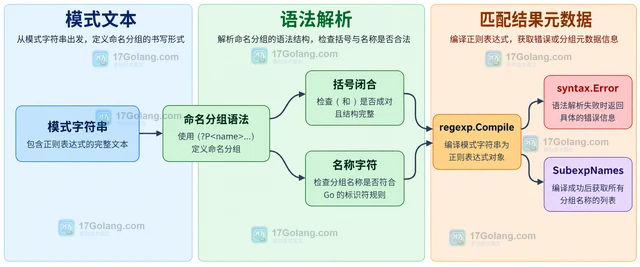
Go regexp 允许多个捕获分组使用同一个名称,真正的编译错误通常来自命名语法、括号闭合、转义或不支持的 Perl 扩展。本文用最小模式、syntax.Error 和 SubexpIndex 拆开排查路径,并给出生产代码中的命名策略。
-
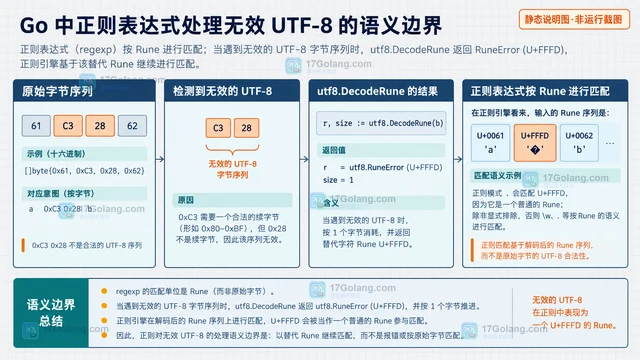
Go regexp 会把无效 UTF-8 输入中的异常字节按 utf8.RuneError 处理,而不是保留原始字节。本文对比先拒绝、规范化后匹配和改用 bytes 做字节级查找三种方案,帮助你按数据边界选对实现。
-
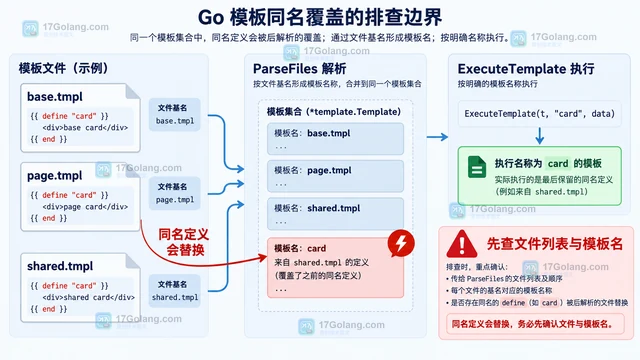
Go text/template 遇到嵌套 define 同名覆盖时,按关联模板、Parse 顺序、文件基名和 ExecuteTemplate 入口逐项定位,避免执行到错误定义。
-
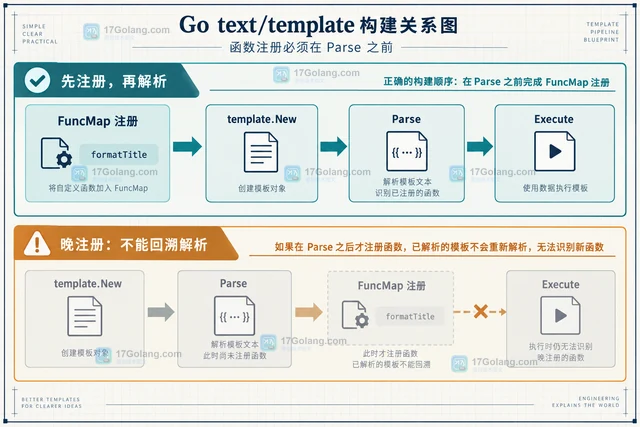
Go 的 text/template 报 function not defined 时,优先检查 FuncMap 是否在 Parse 前注册。本文用最小示例说明正确注册链、集中构造方式,以及解析后替换函数的边界。
-
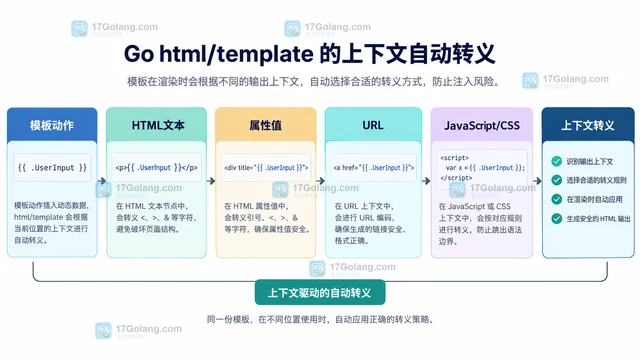
html/template 并不是简单地把所有字符串统一转义,而是根据插值所在的 HTML、属性、URL、JavaScript 或 CSS 上下文选择处理方式。本文用最小示例排查转义异常、ZgotmplZ 和安全类型误用。
-
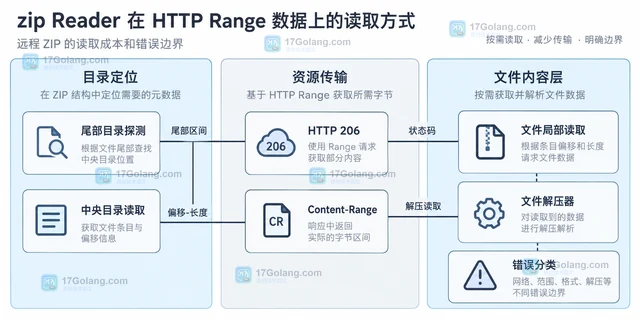
zip.NewReader 需要 io.ReaderAt 和压缩包总大小,HTTP 响应体却通常只能顺序读取。本文用 RangeReaderAt 把 HTTP Range 适配成随机读取,并说明 206、Content-Range、目录定位和错误边界。
-
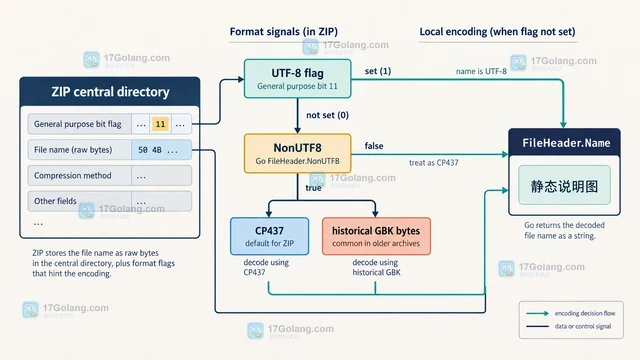
Go 使用 archive/zip 读取中文文件名异常时,先区分 UTF-8、CP437 和历史本地编码,再用显式解码与路径安全策略处理,避免把乱码或不可信路径直接落盘。
-
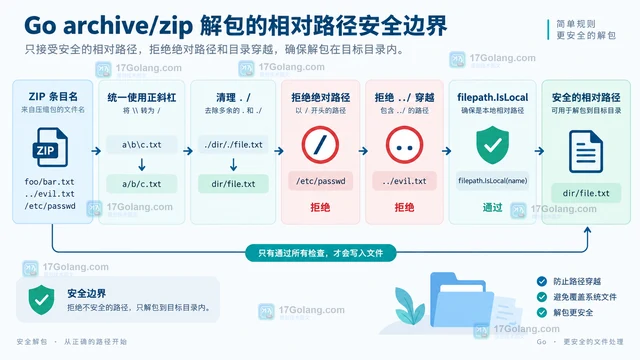
Go 使用 archive/zip 解包时,不能把 ZIP 条目名直接拼到目标目录。本文用相对路径校验、安全根目录映射和先校验后写盘的代码,处理绝对路径、../、反斜杠及 ErrInsecurePath,并说明符号链接和共享目录的额外边界。
-
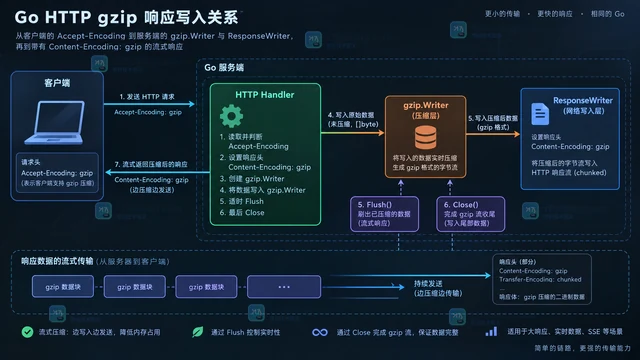
Go 的 gzip 压缩级别是在 CPU 消耗、响应体大小和端到端延迟之间做取舍。本文用 NewWriterLevel 比较级别,并给出 HTTP Handler 中的配置、Close、Flush 与 Writer 复用注意事项。
-
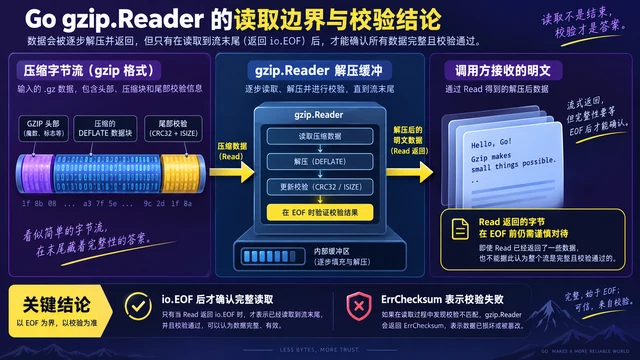
复用 gzip.Reader 时看到旧数据,通常不是 Reset 失效,而是把 Reader 内部状态、输入源位置和调用方输出缓冲混在了一起。本文用 Reset、EOF、ErrChecksum 与 Multistream 说明正确的复用边界。
-
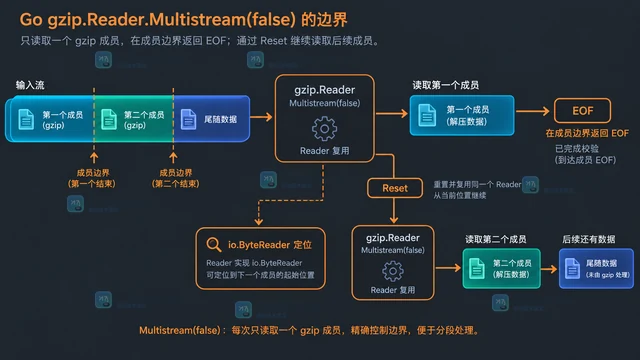
Go 的 gzip.Reader 默认会连续读取拼接的 gzip 成员。本文用原创示例拆开 Multistream、Reset、io.ByteReader、EOF 与尾随数据的边界,帮助你选择整体解压或按成员处理。
