-
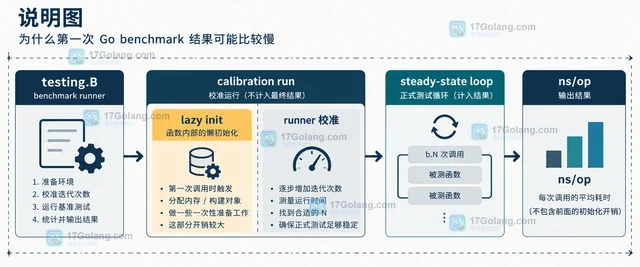
Go benchmark 第一次结果偏慢时,先区分测试框架的首轮校准、被测函数的 lazy init 和环境噪声,再决定是否预热。本文用 b.Loop、StopTimer、ResetTimer 以及 -benchtime、-count 组合,建立可解释的 cold path 与 warm path 测量方式。
-
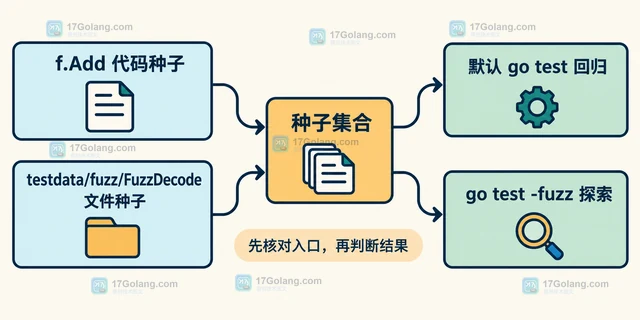
Go fuzz 语料没有复现时,先核对 FuzzXxx 入口、目标包目录以及 testdata/fuzz/FuzzXxx 的大小写匹配,再用 go test 和精确的 -run 子测试名定位问题。
-
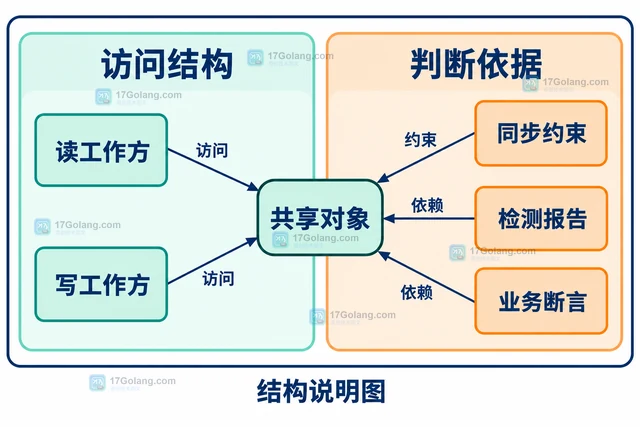
Go race 无报告不能证明全程序并发正确。本文从包范围、实际路径和共享对象排查覆盖盲区,给出并发用例结构与测试参数,并区分数据竞争检测和业务断言。
-
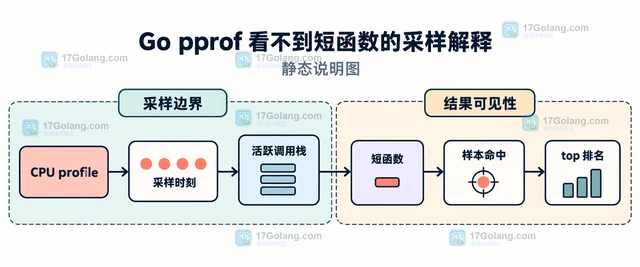
Go pprof 里找不到一个很短的函数,不一定代表它没有执行。CPU profile 记录的是离散采样时刻的活跃调用栈,短函数可能因命中次数少而没有独立排名。本文从 flat、cum、采样窗口、源码定位和 profile 类型五个角度给出排查流程。
-
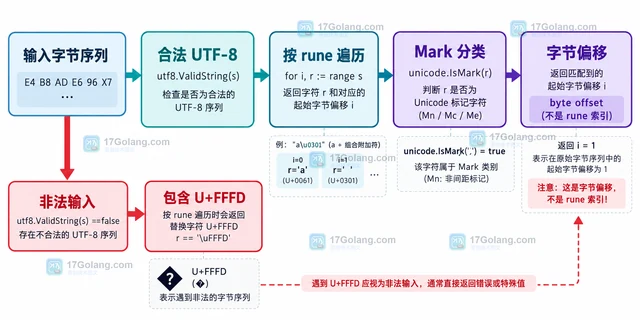
Go unicode.IsMark 判断的是单个 rune 是否属于 Unicode 的 Mark 类别 M,包含非间距、间距组合和包围标记。本文用具体字符串拆开预组字符与组合序列,说明如何按 rune 分类、如何解释字节偏移,以及为什么 IsMark 不能代替正规化或用户感知字符切分。
-
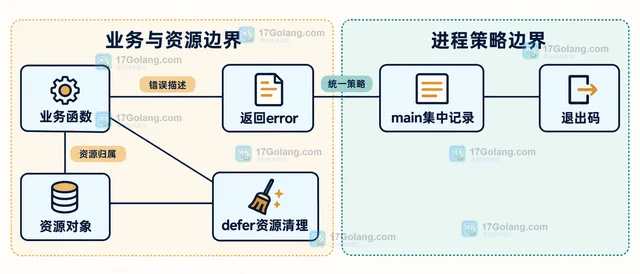
Go 的 log.Fatal 写出日志后会调用 os.Exit(1),不会等待当前函数或其他 goroutine 的 defer 展开。本文从函数返回、panic 与进程级退出的边界出发,说明资源清理、错误返回和 main 集中退出的组合方式。
-
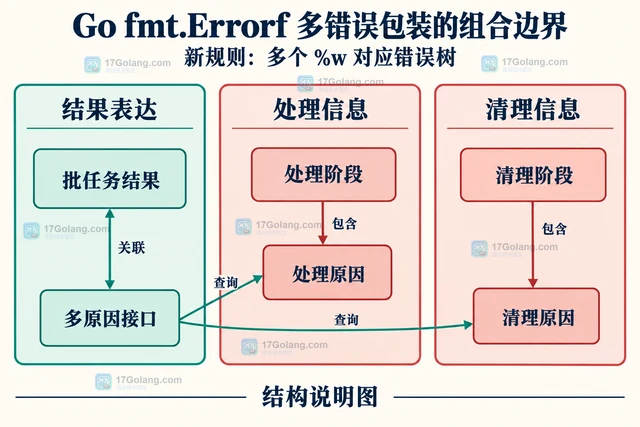
Go fmt.Errorf 多个 %w 可保留多个错误原因。结合处理与清理失败场景说明 nil 组合、错误树、errors.Unwrap 的限制,以及分类与兼容性取舍。
-
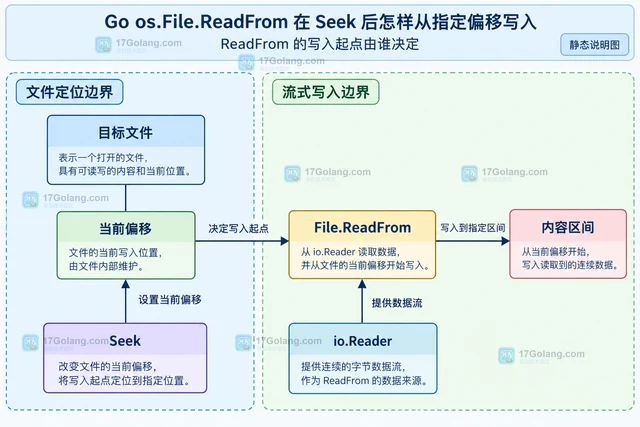
Go os.File.ReadFrom 没有 offset 参数,需要先用 Seek 设置目标文件当前偏移,再从 io.Reader 流式写入;本文说明 n、err、覆盖范围和 O_APPEND 的边界。
-
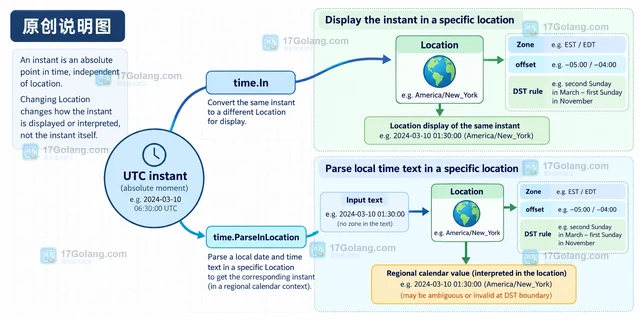
Go 程序在本地、容器和精简系统中出现时区差异时,不要直接依赖 time.Local。本文用 time.LoadLocation、ZONEINFO、time/tzdata 和启动自检建立一套可排查的部署处理方案。
-
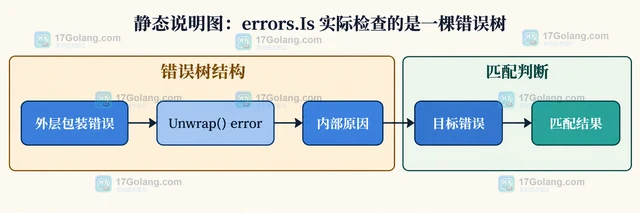
errors.Is 匹配不到自定义包装错误,通常不是错误消息不一致,而是包装类型没有通过 Unwrap 暴露内部原因,或创建包装时使用了 %v。本文用错误树、单错误 Unwrap、多错误 Unwrap 和自定义 Is 方法梳理排查与设计边界。
-
Go 的 base64.Encoding.DecodedLen 返回的是解码数据的最大字节数,Decode 再返回实际写入长度。本文用 StdEncoding、RawStdEncoding 和 AppendDecode 说明怎样分配缓冲区、截取有效数据并处理部分解码错误。
-
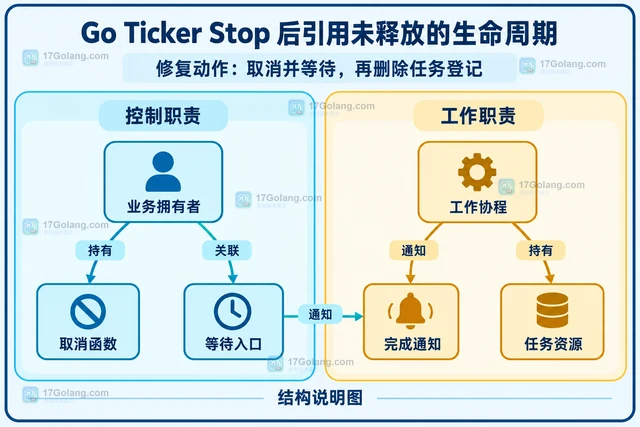
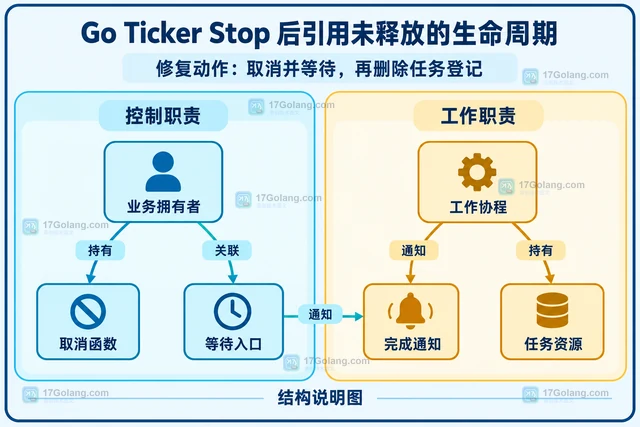
Go Ticker.Stop 不会关闭通道或结束工作协程。通过周期任务示例区分停止节拍、请求取消、等待完成与移除引用,并说明 Go 1.23 回收行为的适用范围。
-
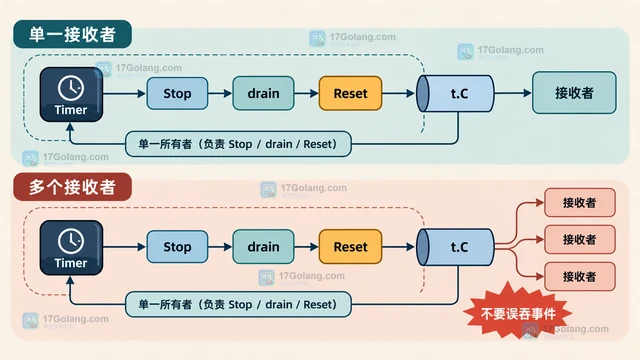
Go Timer Stop 后仍收到事件,先看 Stop 返回值、Go 版本和 C 通道的接收者。本文说明旧版本的非阻塞排空、Go 1.23 之后的同步语义,以及 Reset、多个接收者和 AfterFunc 的处理边界。
-
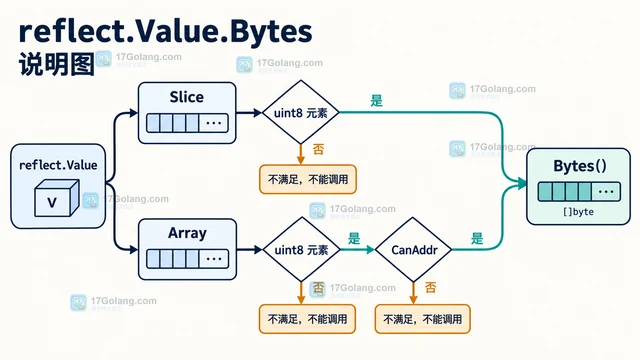
reflect.Value.Bytes 可以读取字节切片,也可以读取可寻址的字节数组;命名切片按元素 Kind 判断,普通数组值则要先取得可寻址 Value。本文用判断表和原创示意图拆开 Bytes、SetBytes 与常见 panic 的边界。
-
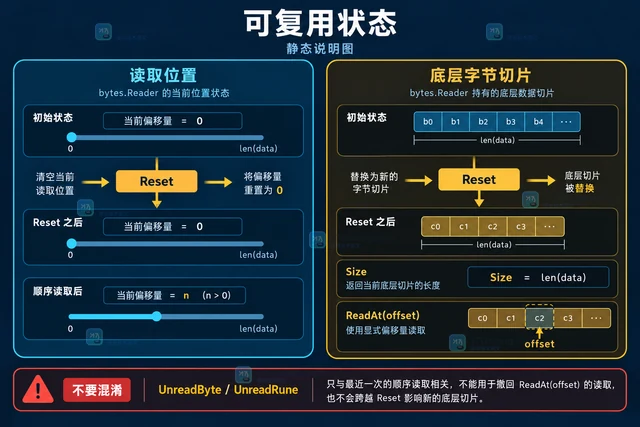
bytes.Reader.Reset 会把读取器切换到新的字节切片,并把顺序读取位置带回新数据开头。本文用复用场景拆开 Reset、Read、Len、Size、ReadAt 与 UnreadByte 的边界,避免把读取位置和底层数据混在一起。
