-
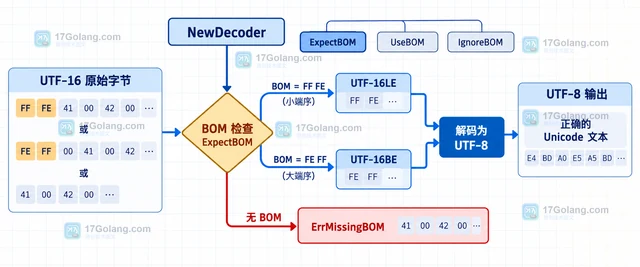
Go x/text/encoding/unicode 的 ExpectBOM 会要求 UTF-16 输入以 BOM 开始,没有签名的字节流会返回 ErrMissingBOM。本文对比三种 BOMPolicy,演示解码、编码和 transform.Reader 的正确使用边界。
-
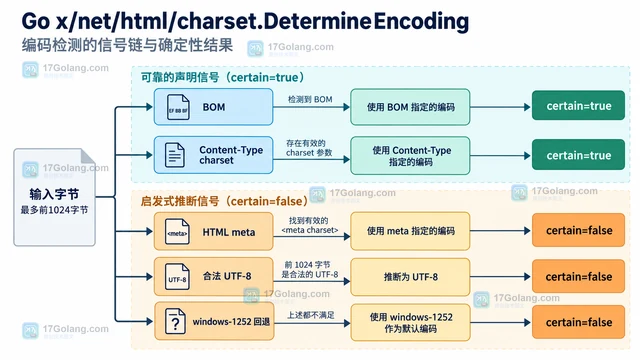
Go x/net/html/charset.DetermineEncoding 返回的 certain 不是“有没有识别出编码”,而是“结果是否来自可靠声明”。本文拆解 BOM、Content-Type、meta 扫描、UTF-8 推断与 windows-1252 回退的顺序,给出网页乱码排查时的使用方式。
-
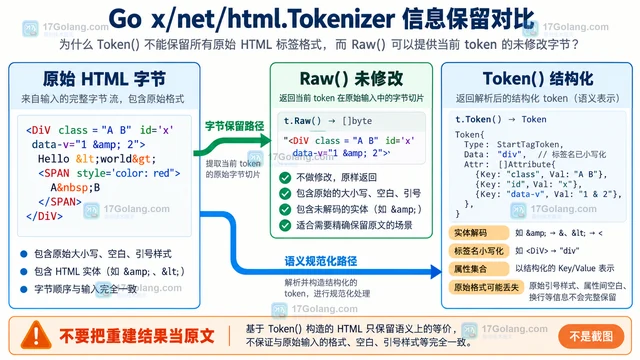
Go x/net/html.Tokenizer 的 Token 会把实体、标签名和属性转成结构化数据,因此不能当作原始 HTML 的无损副本。本文用 Raw、Token 和低级 API 对比保留边界,给出按 token 复制原始字节的写法。
-
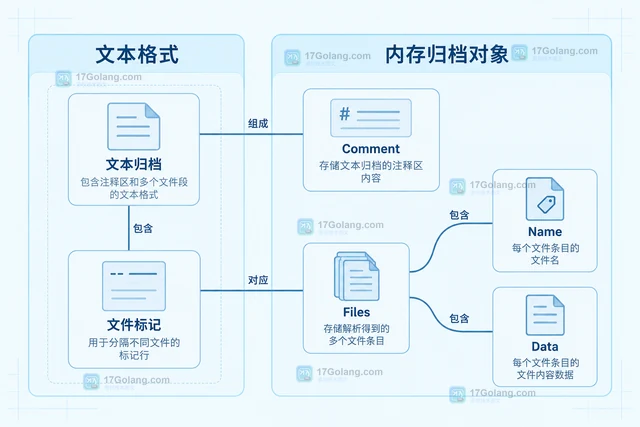
Go txtar.Parse 将注释区和文件段拆成 Archive。本文说明标记行、Files 顺序、末尾换行与输入切片引用,并给出保留独立存储的内存解析示例。
-
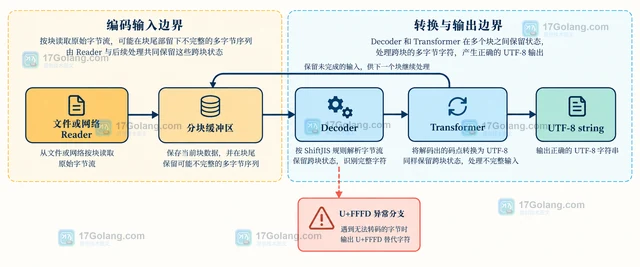
ShiftJIS 的字节边界不一定等于字符边界,逐字节调用 Go 解码器会让日文字符失去配对关系。本文说明 japanese.ShiftJIS 的 Decoder、transform.Bytes 和 Reader 应如何选择,并给出分块乱码与 U+FFFD 的排查方法。
-
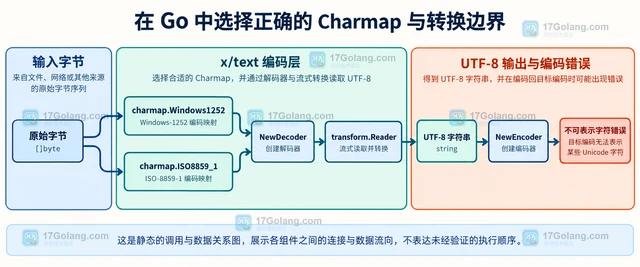
Windows1252 与 ISO8859_1 都是单字节编码,但 0x80–0x9F 区域的字符定义不同。本文用 Go x/text/encoding/charmap 对比解码、流式转换和反向编码,说明为什么不能只看字节宽度来选择编码。
-
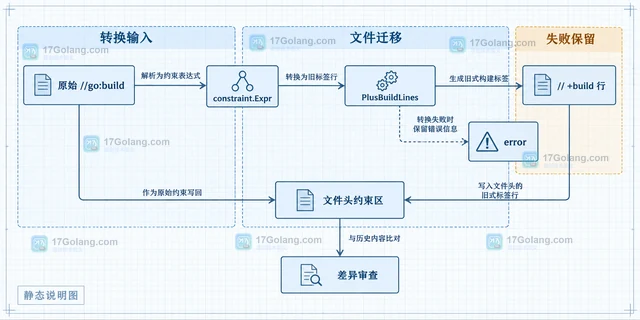
Go constraint.PlusBuildLines 可以把 constraint.Expr 转成一组等价的 // +build 旧标签行。本文说明 Parse、转换错误、复杂表达式边界以及写回源文件时的新旧约束同步方法。
-
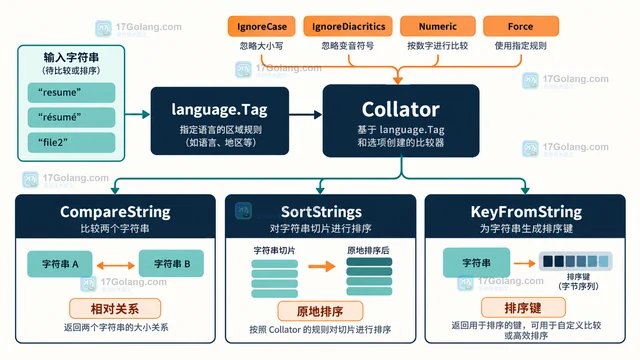
Go x/text/collate 的 CompareString 比较的是指定语言环境下的 Unicode 排序关系,不是字符串的 UTF-8 字节序。本文用最小示例说明 locale、返回值、比较选项和排序接入方式。
-
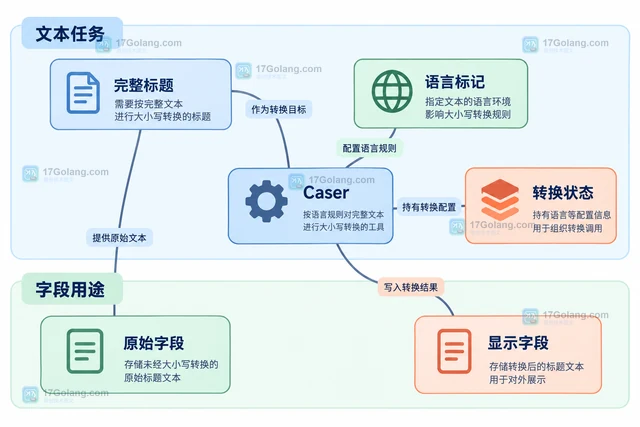
Go cases.Title 实现标题式大小写,不会将每个单词全部转成大写。本文比较 Title、NoLower 与 Upper,说明语言标记、单词边界、分块状态和显示字段的处理。
-
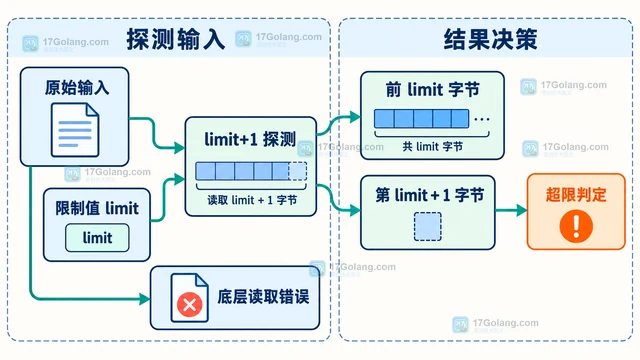
io.LimitReader 读到上限后返回 EOF 是设计出来的正常结束信号,不是超限报错。本文从 Reader 契约出发,说明如何用 limit+1 的策略识别输入是否真的超过上限,并比较 LimitReader、ReadFull 与 ReadAtLeast 的适用边界。
-
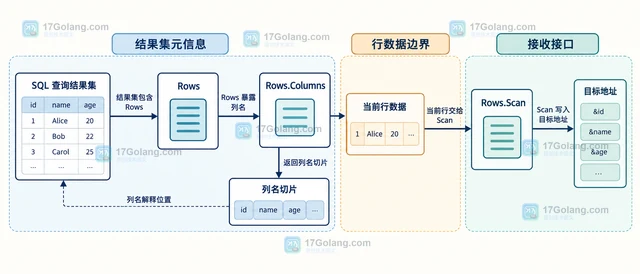
Rows.Columns 返回列名顺序,Rows.Scan 按位置写入目标地址。本文解释固定列与动态列的对应规则,并处理 NULL、Close 和 Err 的常见边界。
-
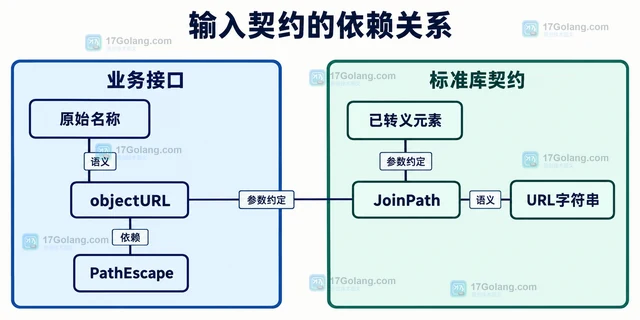
Go url.JoinPath 接收已转义路径元素,保留百分号编码并不异常。通过 Path、RawPath、EscapedPath 的区别和原始名称构造示例,说明斜杠、点段与重复转义的处理方法。
-
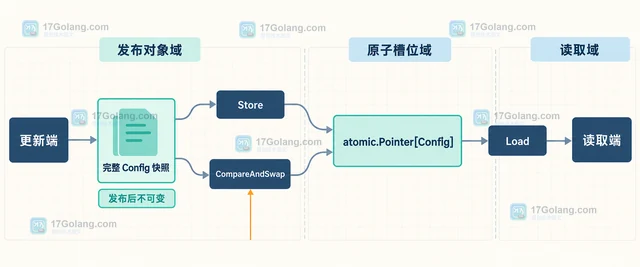
atomic.Pointer[T] 中的 T 决定了它保存的指针类型以及 Store、Load、Swap 和 CompareAndSwap 的参数与返回值。本文解释 Go 为什么要求指针类型一致,并给出共享配置对象的安全用法与复制、可变性边界。
-
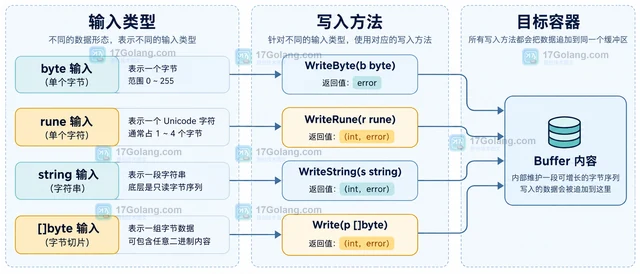
bytes.Buffer.WriteByte 的 error 固定为 nil 并不是漏掉了错误处理,而是为了匹配 bufio.Writer 的接口形状。本文说明单字节写入、字符写入与容量边界的区别。
-
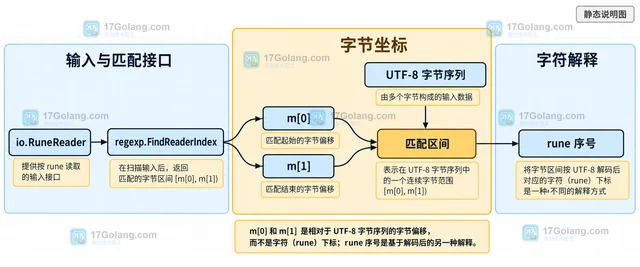
regexp.FindReaderIndex 返回的是 UTF-8 字节偏移,不是字符序号。本文解释中文文本中的位置差异,并给出保留原文后把字节区间换算为 rune 位置的方法。
