-
摘要:墨天轮数据库周刊第19期发布啦,每周1次推送本周数据库相关热门资讯、精选文章、干货文档。本周分享GBASE适配鲲鹏; 疫情激活COBOL语言;TiDB数据库的未来;Oracle与double write;MySQL8.0 窗
-
下载MariaDB数据库测试: 当前虚拟机是否可以正确的链接外网.命令:[root@localhost src]# yum install mariadb-server 安装mariadb数据库
[root@localhost src]# yum clean all 清空已安装文件 如果下载失败之
-
参考:Specifying limit and offset in Django QuerySet wont work-StackOverflowdjango官方文档Use a subset of Python’s array-slicing syntax to limit your QuerySet to a certain number of results. This is the equivalent of SQL’s LIMIT and OFFSET clau
-
mysql 静默恢复备份文件步骤如下:1、新建一个 mysql -uroot -proot -hlocalhost --database=db1 < db1.sql2、回到终端执行:nohup sh mysqlimport.sh &脚本便会切换到后台执行导入,此时可以使用 tail -f nohup.log
-
在InnoDB内存结构中,对每个含有自增长的表都有一个自增长计数器,当进行插入操作时,这个计数器会被初始化,执行如下语句得到计数器的值:select max(auto_inc_col) from t for update插入操作会依据
-
全文索引全文索引可以用来查找正文中的中文,只有在mysql 5.7.6之后,才能使用到检索功能,因为在mysql5.7.6之后,加入了中文分词器,比如“今天天气真好!”会被切割为“今天”,“天气”很
-
前言:
在日常使用数据库的过程中,难免会遇到需要修改账号密码的情景,比如密码太简单需要修改、密码过期需要修改、忘记密码需要修改等。本篇文章将会介绍需要修改密码的场景及修改
-
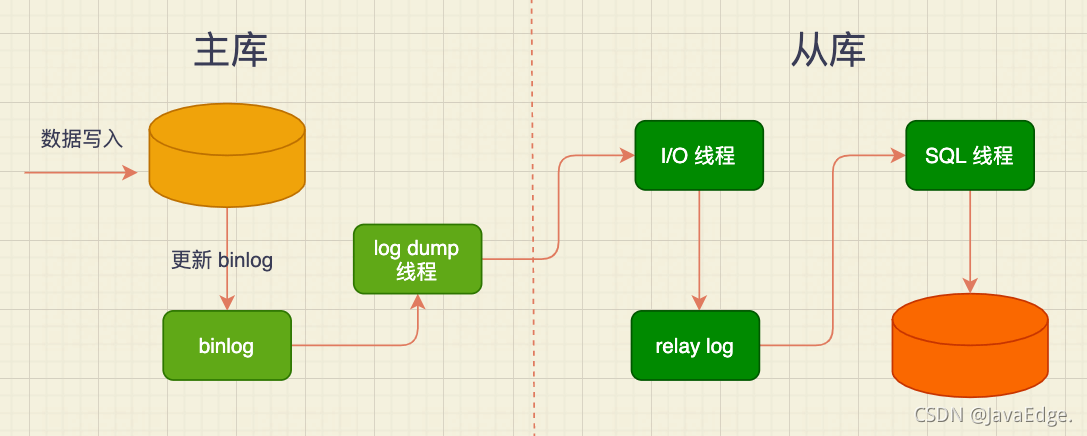
1 主从读写分离
大部分互联网业务都是读多写少,因此优先考虑DB如何支撑更高查询数,首先就需要区分读、写流量,这才方便针对读流量单独扩展,即主从读写分离。
若前端流量突增导致从库
-
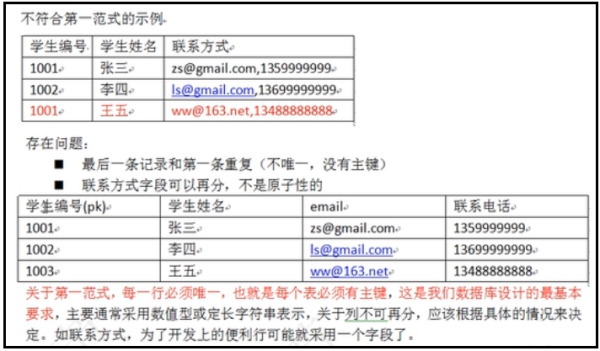
一、数据库设计三范式相关知识说明
1、什么是设计范式?
设计表的依据,按照这三个范式设计出来的表,不会出现数据的冗余。
2、为什么要学习数据库的三个范式?
数据库的设计范式是数据
-
MySQL中如何表示当前时间?
其实,表达方式还是蛮多的,汇总如下:
Data Type
“Zero” Value
DATE
'0000-00-00'
-
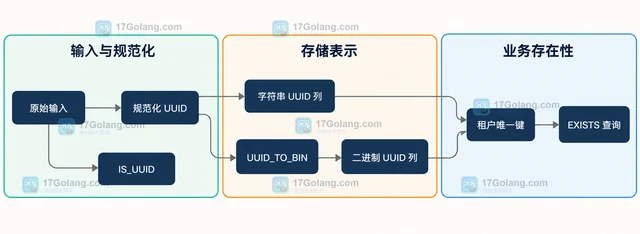
MySQL IS_UUID 返回 1 只说明输入符合可解析的 UUID 字符串格式,不代表业务表中存在对应记录。本文从故障影响、触发条件和根因出发,拆开格式校验、规范化、UUID_TO_BIN 与业务存在性查询的边界。
-
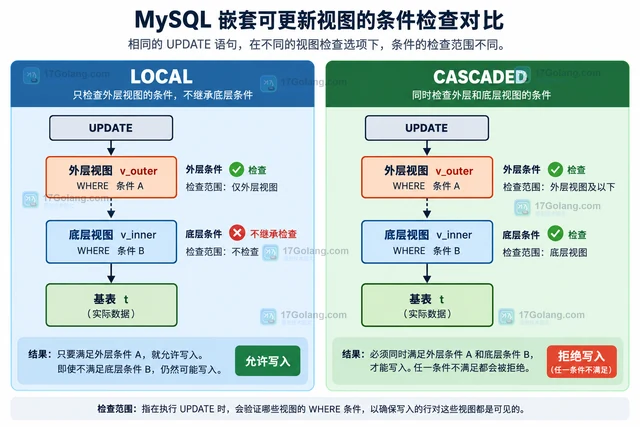
MySQL 嵌套可更新视图中的 LOCAL 与 CASCADED 决定写入检查范围。本文用订单视图对比两者在内层无约束、内层已有约束和 UPDATE 场景下的差异,帮助你选择合适的视图写入边界。
-

数据分片的核心目的是提升数据库读写性能和存储扩展能力。其通过将大表数据分散到多个物理节点实现,常见方式包括应用层逻辑分片、使用中间件做透明分片或数据库引擎的分区功能(注意分区不是分片)。一、水平分片是按行分开放置在不同实例中,例如根据用户ID奇偶划分;优点是简单易懂,缺点是扩容麻烦且易数据倾斜,建议选好分片键避免跨库查询。二、常见分片方案有三种:1.应用层逻辑分片由代码控制路由,灵活但维护成本高;2.使用分片中间件如MyCAT、ShardingSphere实现透明分片,适合中大型项目但增加运维复杂度;3.
-

HAVING和WHERE的区别在于作用时机和场景:1.WHERE在分组前筛选行,用于过滤原始数据,如筛选工资>5000的员工;2.HAVING在分组后筛选结果,用于过滤聚合结果,如保留员工数>5的部门;3.两者可同时使用,如先筛选工资>5000的员工,再保留平均工资>8000的部门;4.不能在WHERE中使用聚合函数,因为其逐行判断,而聚合计算需基于一组行。
-

优化MySQL排序性能需从四方面入手。一、建立合适索引,如为常用排序字段建索引、使用联合索引并保持顺序一致,并注意索引方向与排序方向匹配;二、避免不必要的排序,检查是否业务真正需要,或通过数据写入时预排序、调整查询逻辑来规避;三、控制排序数据量,结合WHERE条件过滤、避免大偏移分页,改用游标分页方式;四、调整系统参数,如增大sort_buffer_size提升内存排序效率,合理设置max_length_for_sort_data影响排序方式,关注临时表空间配置。
