-

现在有一张会员表,表的结构如下:可以看到,platform_id 一列是存在索引的。现在分析以下SQL语句:从第五列type字段可以看到,这次分析的结果是走了全表扫描。在第一时间,我还没反应过来
-

索引是帮助数据库高效获取数据的数据结构索引的数据结构1.hash表a.利用hash存储的话需要将所有的数据文件添加到内存,比较耗费内存空间b.hash表存储的是无序数据,范围查找的时候需要挨个进
-

最近有个新项目刚过完需求,正式进入数据库表结构设计阶段,公司规定统一用数据建模工具 PowerDesigner。但我并不是太爱用这个工具,因为它的功能实在是太多了,显得很臃肿,而平时设计表
-

简介在某些情况下在服务器是不能连接网络的,这时就无法通过yum安装MySQL数据库,但好在国内国内的很多镜像站提供了包下载功能,可以把包下载到本地后通过U盘或者光驱进行安装。在些日子
-

Thresh概述索引可以提升查询速度,会影响where查询,以及order by排序。MySQL索引类型如下:从索引存储结构划分:B Tree索引、Hash索引、FULLTEXT全文索引、R Tree索引
从应用层次划分:普通索引、唯
-

简介:阿里云开发者学堂出品了近千门课程,在数据库领域中哪几门课程最受开发者们的青睐呢?小助手来揭秘!阿里云开发者学堂为了方便开发者,推出了近千门的免费课程供开发者们学习,
-

@[toc]为什么要两阶段提交?一阶段提交不行吗?小伙伴们知道,MySQL 中的事务是两阶段提交,我们见到的很多分布式事务也都是两阶段提交的,例如 Seata,那么为什么要两阶段提交呢?一次直接
-

文章不易,请关注公众号 毛毛虫的小小蜡笔,多多支持,谢谢问题在使用mysqldump的时候,报错了,具体报错信息如下所示:mysqldump: Error 2013: Lost connection to MySQL server during query when dumping table xxx a
-

select count(*) from user where MONTH(create_time) = 5虽然可能查到正确的结果,但通过explain我们会发现没走索引。因此我们为了能确保使用索引,我们可能会改成select count(*) from user where create_time BETWEEN '202
-

在数据库表里,我们有时候会保存了很多重复的数据,这些重复的数据浪费资源,我们要将其删除掉,应该怎么处理呢?下面来看一下。
先看下我们的表数据,有一些数据是重复的。
要查找重
-

前言
最近,有一位朋友突然微信联系我,说MySQL出现了数据丢失的情况;毫无疑问,对于一个DBA而言,这无疑是最令人紧张的一件事情,没有之一;听到这个消息后,我也就立刻投入到问题排
-

READ UNCOMMITTED:读未提交。READ COMMITTED:读已提交。REPEATABLE READ:可重复读。SERIALIZABLE:序列化。
1.四种事务隔离级别
1.1 READ UNCOMMITTED
读未提交,也叫未提交读,该隔离级别的事务可以看到其他
-
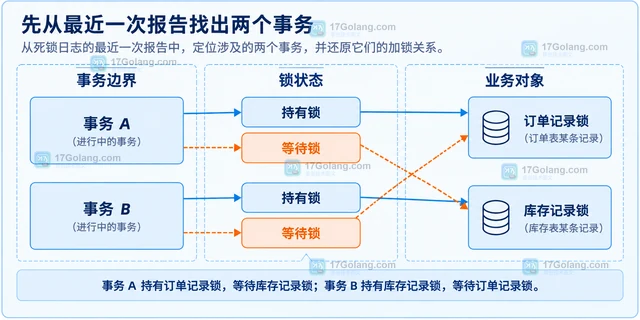
从 SHOW ENGINE INNODB STATUS 读懂持锁与等待锁,定位 MySQL 事务交叉加锁的闭环,并给出访问顺序、索引和重试的处理方案。
-
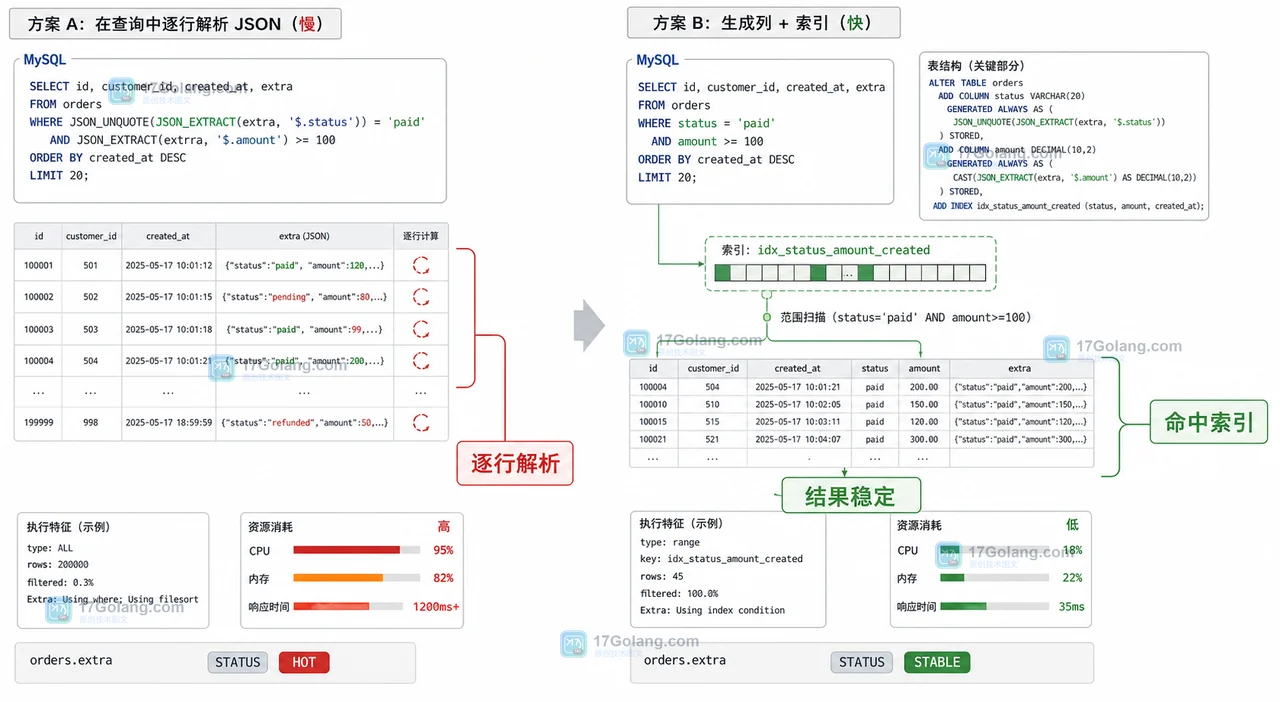
订单列表把渠道、会员等级放进 JSON 后,筛选条件容易变成逐行计算。本文用 MySQL 生成列和索引把 JSON 路径变成可核对的查询字段,同时处理缺失键、空字符串、类型转换和写入成本。
-
MySQL中常见的Join类型包括INNERJOIN、LEFTJOIN、RIGHTJOIN和CROSSJOIN,INNERJOIN性能最佳。INNERJOIN返回两表匹配行,LEFTJOIN返回左表全部记录,RIGHTJOIN返回右表全部记录,CROSSJOIN返回笛卡尔积。Join查询慢的原因主要有:缺少索引导致全表扫描、字段类型不一致无法使用索引、表数据量过大、Join层级或字段过多、驱动表选择不合理。优化方法包括:1.为Join字段加索引,尤其是主键和外键;2.控制Join规模,提前过滤减少数据量;
