
linux技术文章
-
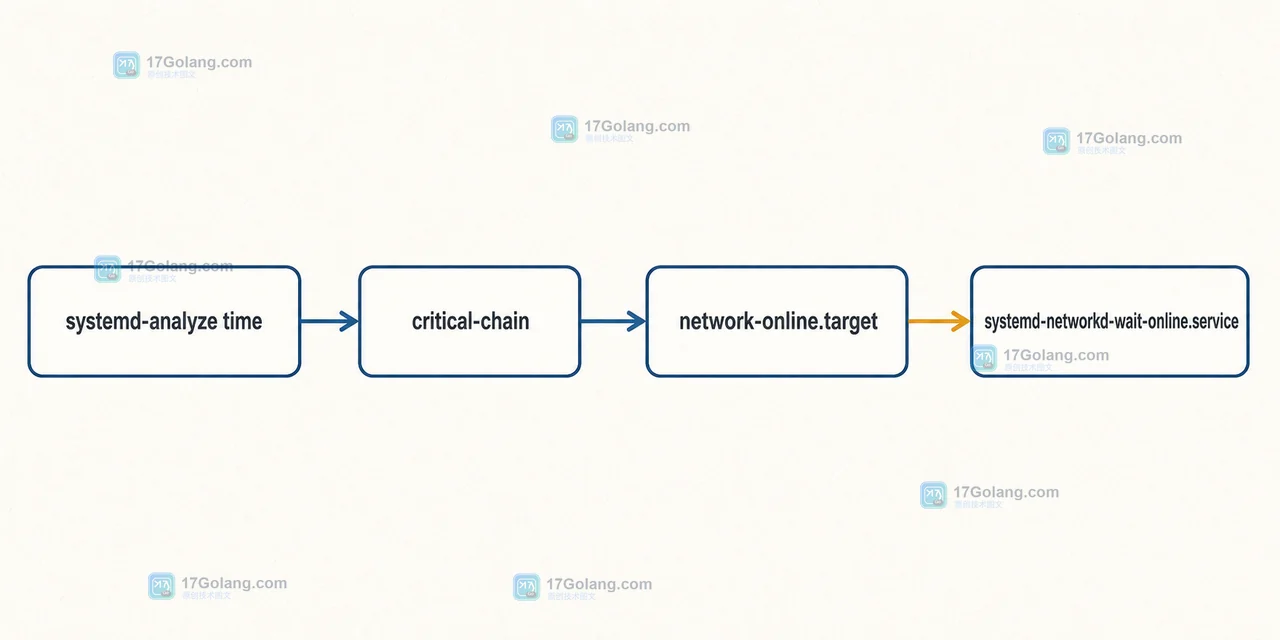 服务开机后迟迟不可用时,用启动分析器的 time、blame 和 critical-chain 分开确认总耗时、单元耗时与真正阻塞链,避免只凭 blame 排错。118 收藏
-
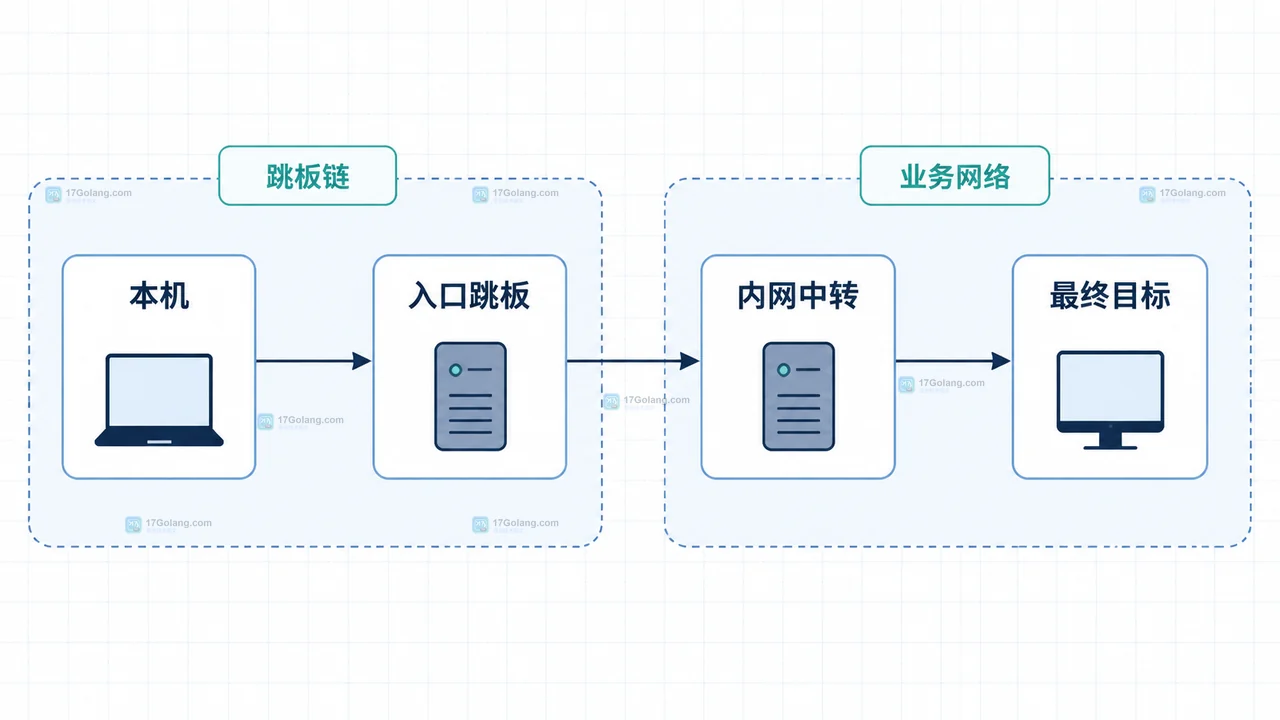 用 OpenSSH 的 ProxyJump 和 ~/.ssh/config 配置两级跳板,讲清主机别名、每一跳密钥、临时 -J 验证,以及 ssh -G 和 -vvv 的排错方法。118 收藏
-
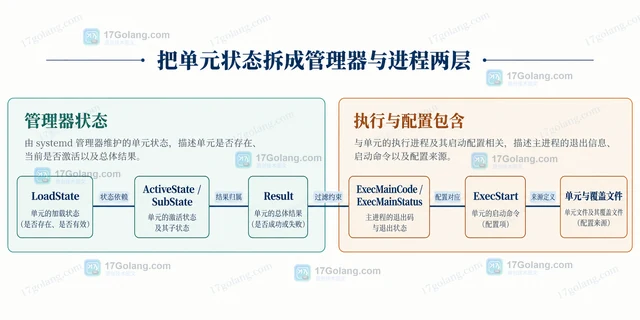 Linux systemd 服务失败时,结合状态属性与 journal 日志,按单元、启动批次和时间定位原因,区分执行错误、应用退出和重试限制,并保留排障现场。117 收藏
-
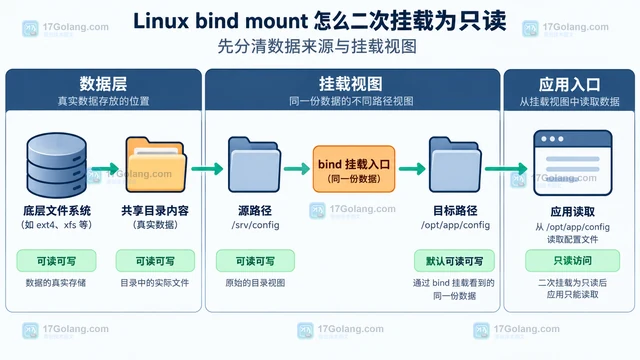 Linux bind mount 不会自动让目标只读。本文说明经典两步挂载、remount,bind,ro 的作用范围、findmnt 核对方法,以及子挂载和撤销时的注意点。116 收藏
-
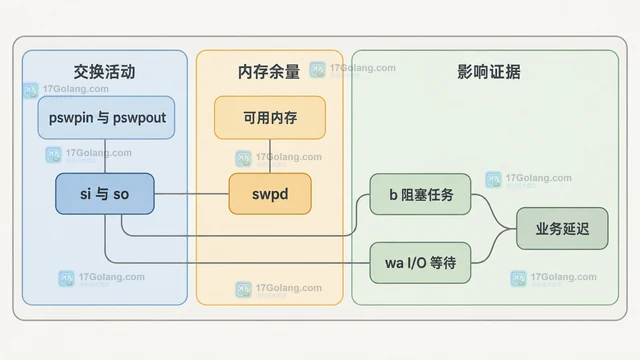 判断 Linux 交换抖动不能只看 swpd 是否非零,应连续观察 vmstat 的 si、so,并结合 b、wa、可用内存与 memory PSI。本文给出 60 秒采样方法、四种典型形态和安全处置顺序。116 收藏
-
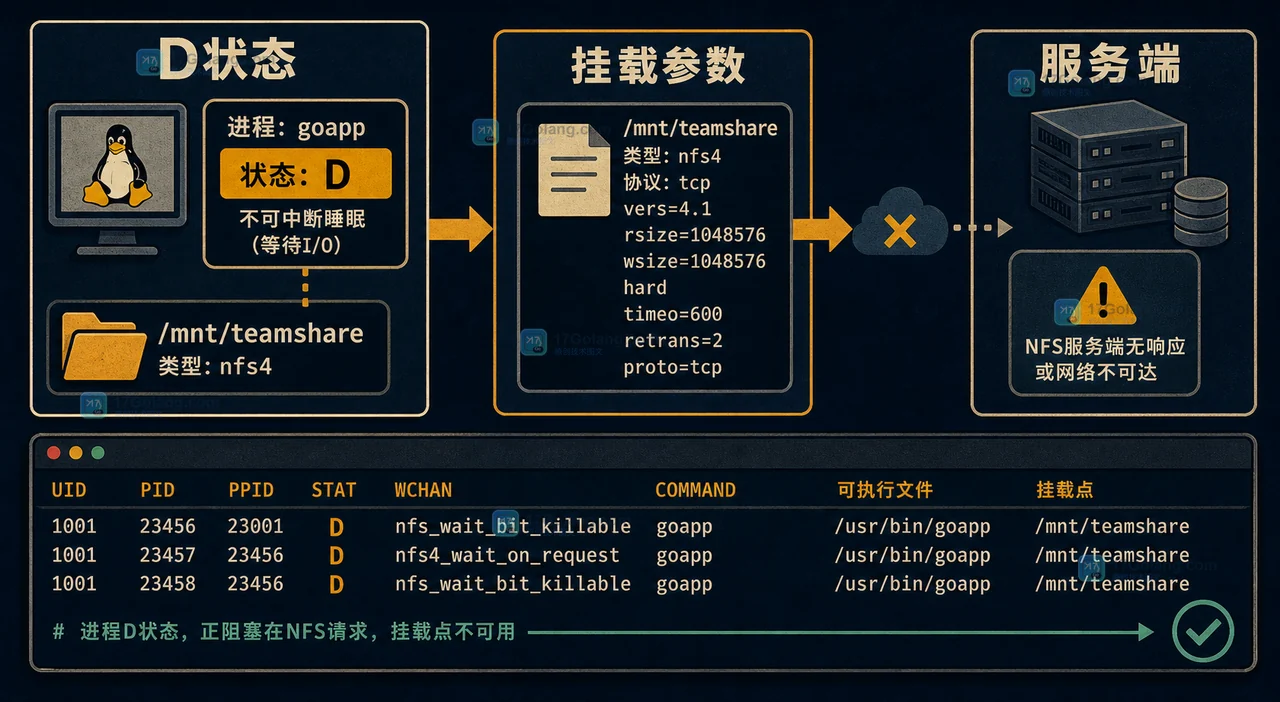 NFS 挂载目录突然卡住时,先用进程状态、挂载参数和服务端可达性判断阻塞位置,再区分 hard 与 soft 的风险边界,最后用小范围读写和恢复测试验收。115 收藏
-
 Linux 中用 curl 上传文件时,不要只看命令是否结束。通过 -o 保存响应体、-w 输出状态码与退出码,再配合 --fail-with-body,脚本就能同时保留错误详情并可靠判断上传结果。115 收藏
-
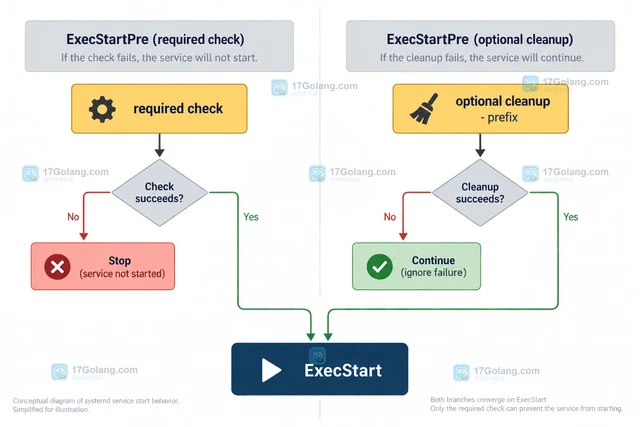 从 systemctl status 和 journalctl 日志识别 ExecStartPre 失败,理解它为何阻止 ExecStart,并用严格检查与可容错清理的边界配置稳定 Linux 服务启动。114 收藏
-
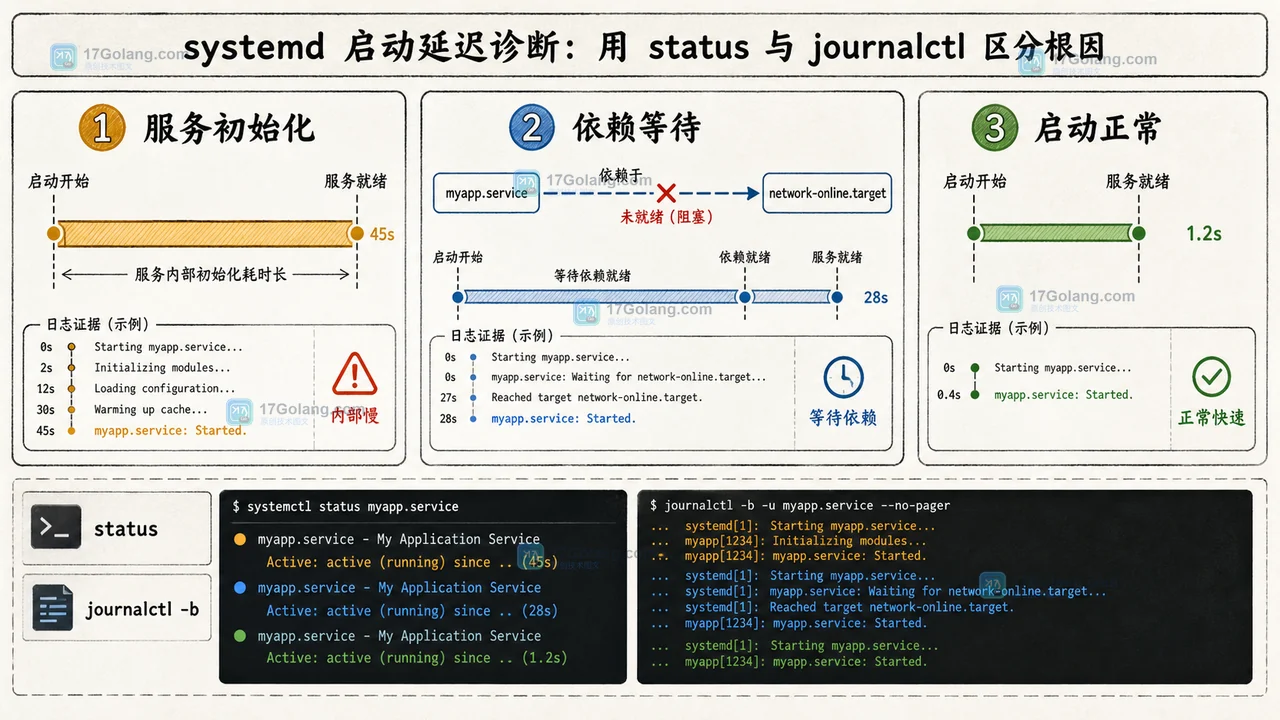 Linux 机器重启后服务迟迟不能用,先别盯着单个进程猜原因。本文用关键依赖链命令拆出启动耗时和真正的等待点,再结合服务状态与 journalctl 验证是服务本身慢、依赖未就绪,还是启动顺序配置造成的延迟。113 收藏
-
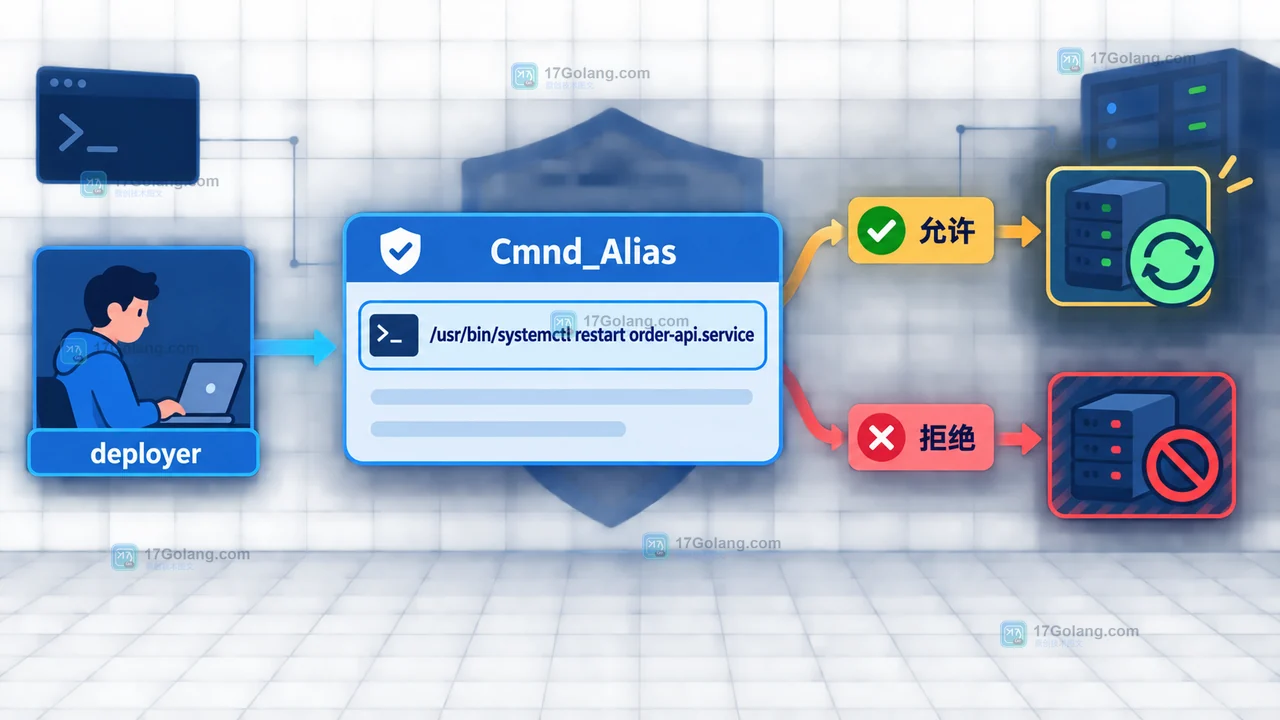 用 sudoers 的命令白名单、绝对路径和 visudo 校验,为部署账号收紧 Linux 权限,并通过 sudo -l 与日志完成回归验收。113 收藏
-
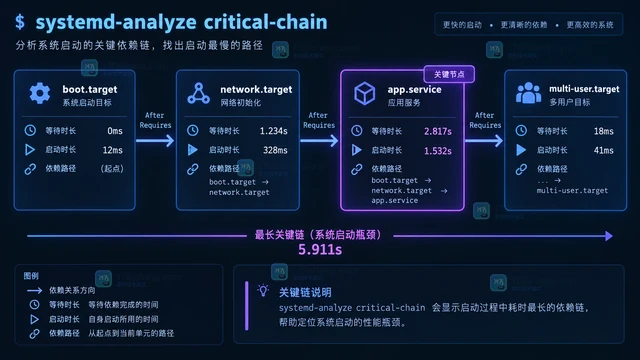 Linux 启动变慢时,systemd-analyze critical-chain 可以沿着目标单元的关键依赖链找出等待位置。本文按启动总览、关键链、blame、status 和 journalctl 的顺序排查,区分依赖等待与服务自身初始化耗时,并保留回滚路径。113 收藏
-
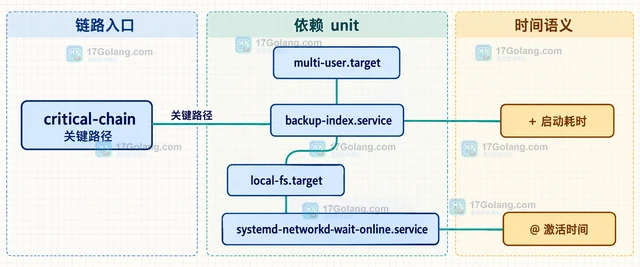 systemd-analyze blame 可以按 unit 初始化耗时排序,帮助快速找出启动排查线索,但耗时靠前不等于服务就是根因。本文结合 systemd-analyze time、blame 和 critical-chain,说明怎样定位慢服务、核对依赖并识别统计边界。112 收藏
-
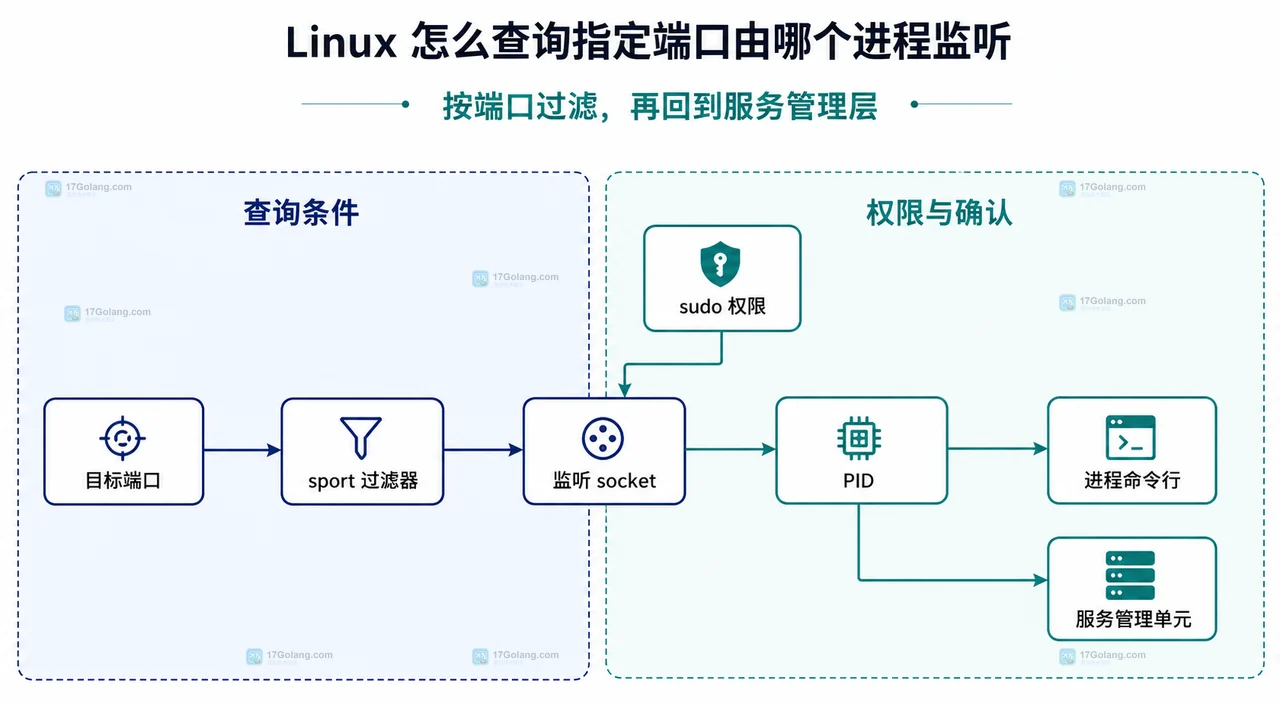 Linux 上查询指定端口由哪个进程监听,首选 ss -ltnp;本文说明 TCP、UDP、IPv4、IPv6、权限和 PID 归属的排查方法。111 收藏
-
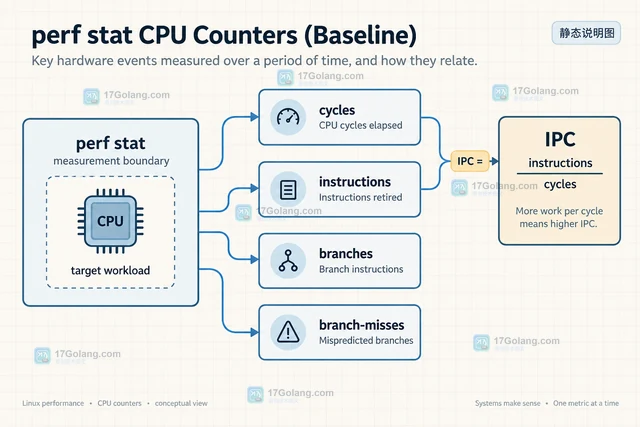 Linux perf stat 适合先用 cycles、instructions、分支和缓存指标建立 CPU 性能基线。本文说明怎样选择第一组事件、理解 IPC 与 cache-misses、识别事件不可用和计数器复用,并用重复测量把指标连接到下一步排查动作。110 收藏
-
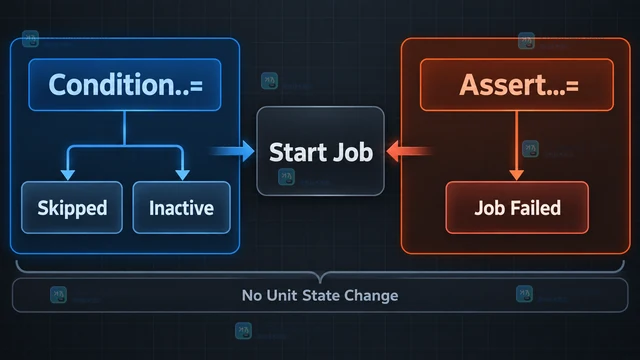 讲清 systemd Condition 与 Assert 的真实差异:前者不满足时跳过启动,后者让启动作业失败,但二者都不会直接把单元切到 failed,并给出配置示例与排查方法。108 收藏