-
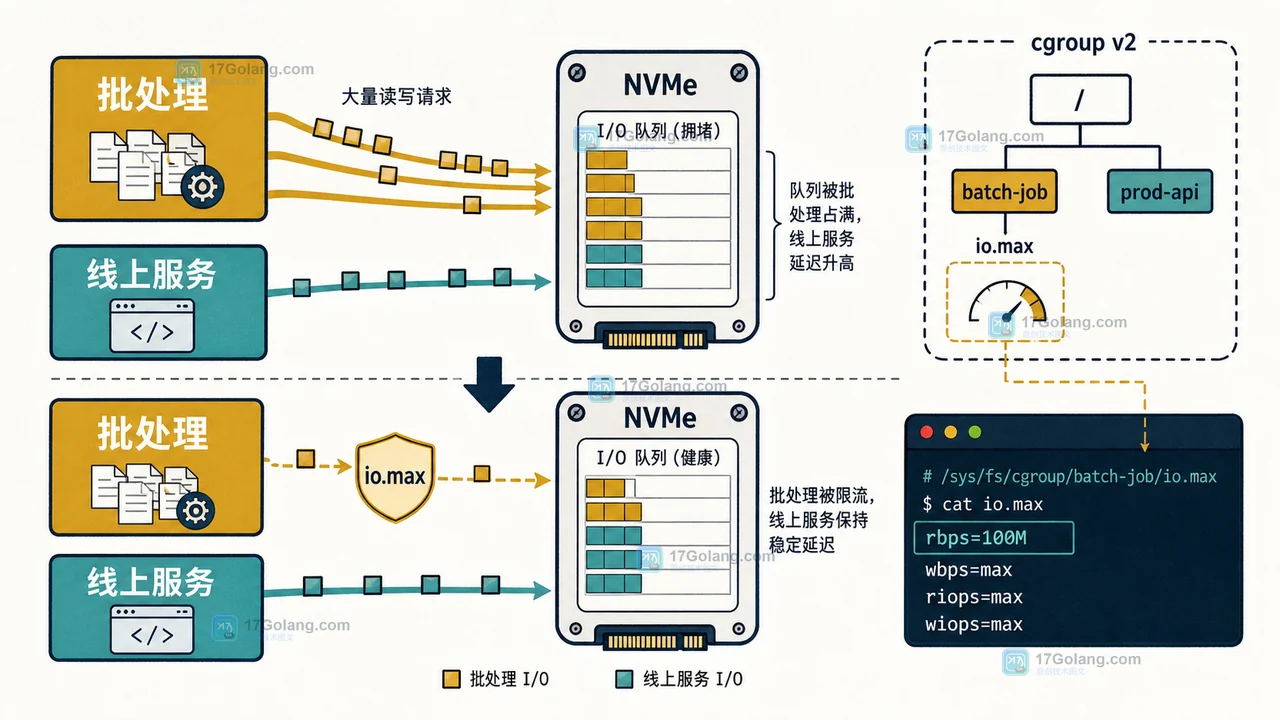
Linux 批处理拖慢线上服务时,可以用 cgroup v2 的 io.max 对指定块设备做读写字节或 IOPS 限流,再用 io.stat 对比限流前后的服务时延。本文给出设备映射、配置、观测和安全回滚步骤。
-

Linux 服务被 cgroup v2 限制后,先用 memory.high 做可恢复的内存限流,再用 memory.max 兜底,最后结合 memory.events 区分回收、节流和 OOM。本文用一个 worker 服务场景给出配置、观测和回滚步骤。
-

Linux 机器重启后服务迟迟不能用,先别盯着单个进程猜原因。本文用关键依赖链命令拆出启动耗时和真正的等待点,再结合服务状态与 journalctl 验证是服务本身慢、依赖未就绪,还是启动顺序配置造成的延迟。
-

Linux 机器重启后服务迟迟不能用,先别盯着单个进程猜原因。本文用关键依赖链命令拆出启动耗时和真正的等待点,再结合服务状态与 journalctl 验证是服务本身慢、依赖未就绪,还是启动顺序配置造成的延迟。
-

容器或 unshare 环境里的挂载偶尔会出现在宿主机,根因常是 mount propagation 而不是命名空间失效。本文用 findmnt、/proc/self/mountinfo 和三种传播类型复现 shared、slave、private 的差异,给出安全验证与回滚顺序。
-

Linux cgroup v2 出现内存告警时,不要只盯着 memory.current。本文用 memory.events、memory.events.local、memory.high 和 memory.max 组成证据链,区分回收压力、硬限额命中与 OOM,并给出可复查的命令顺序。
-

Linux load 高并不一定能说明业务正在等待什么资源。本文用 PSI(Pressure Stall Information)读取 /proc/pressure/cpu、memory、io,解释 some 与 full、avg10/avg60/avg300 的含义,并给出从判断压力类型到设置 poll 阈值的排查和告警方法。
-

Linux 服务管理器的 RuntimeMaxSec 可以给服务设置最长运行时间,但它不是普通的请求超时。本文用一次性数据同步服务说明如何配置运行时限、从服务状态命令和 journalctl 判断超时结果,并区分正常退出、失败重启与限时后的恢复边界。
-

Linux 服务管理器的 RuntimeMaxSec 可以给服务设置最长运行时间,但它不是普通的请求超时。本文用一次性数据同步服务说明如何配置运行时限、从服务状态命令和 journalctl 判断超时结果,并区分正常退出、失败重启与限时后的恢复边界。
-

Linux 网关或容器节点出现新连接失败时,先用 nf_conntrack_count、nf_conntrack_max 和内核日志确认是否为连接跟踪表逼近上限,再区分短连接洪峰、超时过长和异常流量,最后用可回滚的 sysctl 调整与复测闭环。
-

服务开启 PrivateTmp=yes 后,宿主机和服务进程看到的 /tmp 不再是同一个目录。本文用一个临时文件消失的现场,解释配置生效值、主进程和挂载信息的核对顺序,并给出共享临时文件与安全隔离的取舍。
-

ext4 默认会保留一部分数据块给特权进程使用,普通业务写入可能先遇到保留块边界。本文用 df、tune2fs -l 和保留块数量换算出真实余量,再说明何时可以用 tune2fs -m 调整、如何复测以及为什么不建议直接改成 0。
-

Linux 服务出现连接超时,不要先盲目调大内核参数。本文用 ss 区分 LISTEN、SYN-RECV、TIME-WAIT 三类状态,再结合 somaxconn、tcp_max_syn_backlog 和应用 accept 速率定位监听队列瓶颈,给出可复查的调参与回滚步骤。
-

服务 unit 里写了 LimitNOFILE,进程却仍然拿到旧限制,通常不是参数拼错,而是改错了 unit 层级、管理器没有重新读取,或服务仍在使用旧 PID。本文用服务管理器命令、配置校验和 /proc/
/limits 做一套可回滚的验收流程。
-

服务 unit 里写了 LimitNOFILE,进程却仍然拿到旧限制,通常不是参数拼错,而是改错了 unit 层级、管理器没有重新读取,或服务仍在使用旧 PID。本文用服务管理器命令、配置校验和 /proc/
/limits 做一套可回滚的验收流程。
