当前位置:首页 >专题 >Ollama 本地模型工程实践专题
Ollama 本地模型
Ollama 本地模型工程实践专题
从模型拉取、API 接入到生产安全
Ollama 把开源模型的下载、运行和 API 调用压缩成一套易上手的本地工作流,但真正用于开发和团队环境时,还要处理模型版本、上下文、流式响应、硬件约束、端口鉴权和服务健康检查。本专题以 Ollama 官方资料为基线,精选 17Golang 真实文章,串起从第一次运行到可维护本地模型服务的工程路径。
Ollama 官方入口
先对齐安装、模型、API 和自定义模型契约

本地模型工程实战路径
从安装与模型选择走到 API、Embedding 和安全治理




文章
本地运行性能超越 OpenAI Text-Embedding-Ada-002 的 Embedding 服务,太方便了!
介绍基于 Ollama 的本地 Embedding 服务及其在语义检索场景中的使用。

文章
使用 Quarkus、Ollama 和 Testcontainers 构建本地 LLM AI 支持的应用程序
将 Quarkus、Ollama 和 Testcontainers 组合起来,构建可测试的本地 LLM 应用。
Ollama 上线前验收
用资源、API 和安全边界判断本地模型是否可用
Ollama 应该先选大模型还是小模型?
先按任务质量、上下文长度、内存/显存和可接受延迟做小规模基准。开发验证优先选择能稳定加载的量化模型,再根据真实提示、并发和首 token 延迟决定是否升级模型,而不是只看参数规模。
Ollama API 默认地址可以直接暴露到公网吗?
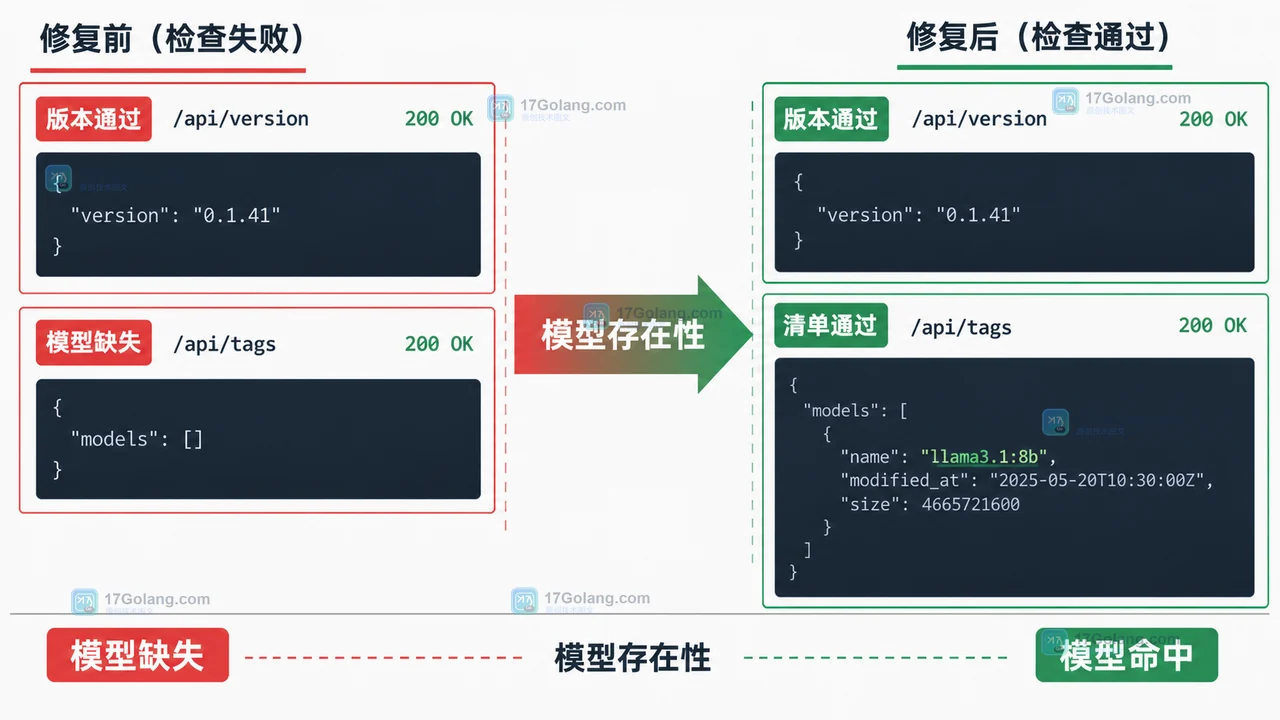
不建议。默认 API 更适合本机或受控内网调用,公网场景应增加鉴权、反向代理、访问控制、限流和审计,并限制可拉取与可运行的模型;先用健康检查和最小权限验证服务边界。
为什么 Ollama 第一次请求很慢,后面又变快?
常见原因是模型首次拉取、加载到内存或显存以及冷启动。应分别记录模型下载、加载、首 token、持续生成和卸载时间,并用 keep_alive、模型大小和并发策略控制冷启动成本。
Modelfile 能不能替代微调?
Modelfile 主要用于指定基础模型、系统提示、模板和推理参数,也可引用适配器;它不等同于训练或微调。需要改变模型知识或能力时,应评估 RAG、LoRA/Adapter 或重新训练,并保留可复现的模型版本记录。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- 用反射实现插件注册时限制允许的方法签名
- 2分钟前 296浏览
-
- 本地模型处理隐私资料时仍要防哪些数据泄露路径
- 7分钟前 127浏览
-
- 反射拿到零值后怎样区分无效值、nil 指针和类型零值
- 12分钟前 208浏览
-
- GitHub Actions 抽取可复用工作流并传递最小权限
- 17分钟前 161浏览
-
- 安全地为可设置字段赋值并处理指针层级
- 25分钟前 177浏览
-
- 内存淘汰策略怎么选:先区分缓存库与持久数据
- 26分钟前 309浏览
-
- reflect.Value 为什么会 panic,CanSet 与可寻址性如何理解
- 33分钟前 300浏览
-
- utf8mb4 排序规则怎么选:大小写、重音与唯一键影响
- 40分钟前 337浏览