当前位置:首页 >专题 >WebGPU 与本地 AI 推理工程实践专题
WebGPU 与本地 AI 推理
WebGPU 与本地 AI 推理工程实践专题
从浏览器 GPU 能力探测、算子契约到性能基准与可靠回退
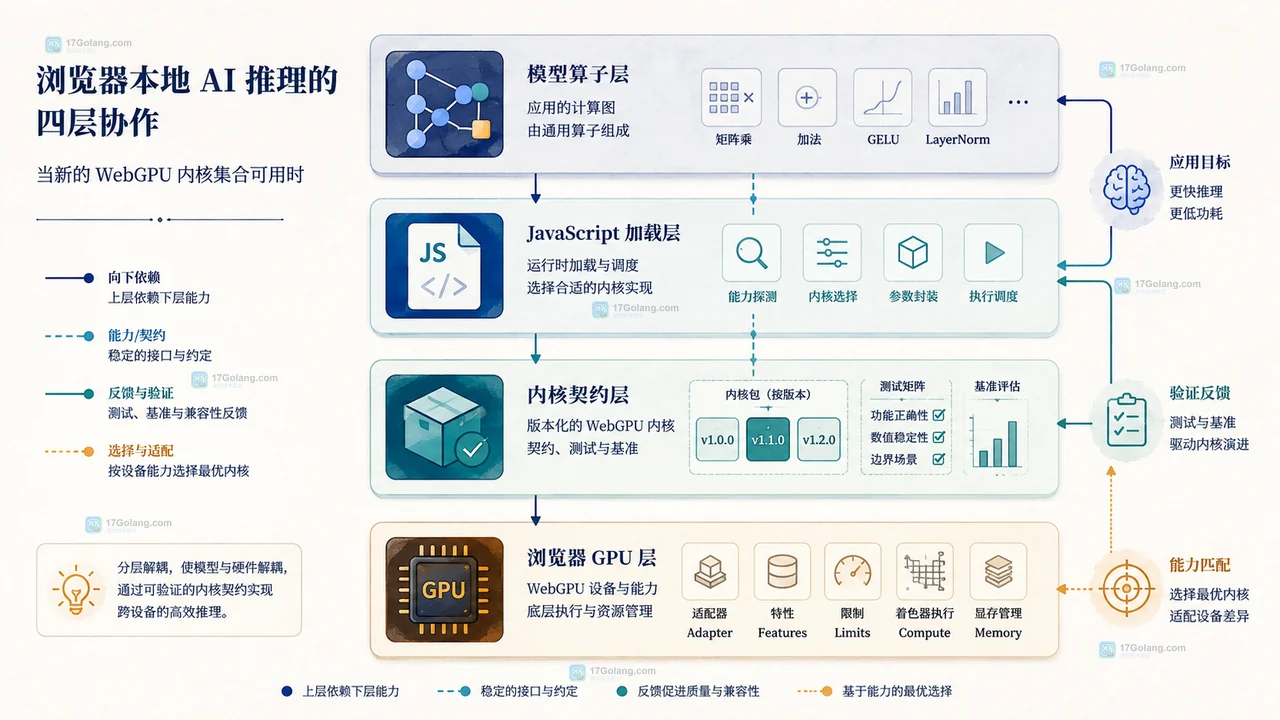
2026 年 9 月 Hugging Face 发布了包含 207 个算子的 WebGPU kernels,并把接口、正确性用例、基准用例和 WGSL 模板一起版本化;W3C WebGPU 候选标准也在持续更新。真正把本地 AI 放进浏览器,难点不只是打开 navigator.gpu,而是要把设备能力、模型算子、初始化成本、显存与上下文、隐私边界和 CPU/WASM 回退做成可测量的工程闭环。本专题从官方标准和运行时文档出发,精选站内本地推理与 AI 性能文章,帮助开发者把演示推进到可验证的浏览器产品能力。
官方标准、API 与 WebGPU 推理入口
先确认浏览器 GPU 能力、运行时契约和可验证的性能边界
官方
W3C WebGPU 候选标准
WebGPU 的标准 API、GPUAdapter、GPUDevice、队列和安全语义入口。
官方
MDN WebGPU API
面向 Web 开发者的 WebGPU API、基础计算示例、安全上下文和兼容性说明。
官方
Hugging Face WebGPU kernels 发布说明
介绍 207 个版本化 WebGPU kernels、正确性与基准用例以及 Fleet。
官方
WebGPU 官方编辑草案与 GPUWeb 仓库
WebGPU 与 WGSL 的最新编辑草案、接口讨论和测试实现入口。
官方
Transformers.js WebGPU 指南
官方演示如何在浏览器中用 device: webgpu 运行文本、视觉和嵌入模型。
官方
Transformers.js 官方仓库
浏览器、Node.js、Bun 和 Deno 中运行模型的官方开源实现。
官方
WebGPU Samples 官方示例
覆盖基础计算、纹理、缓冲区、渲染和设备能力的可运行示例集合。
本地推理性能与可靠回退实践
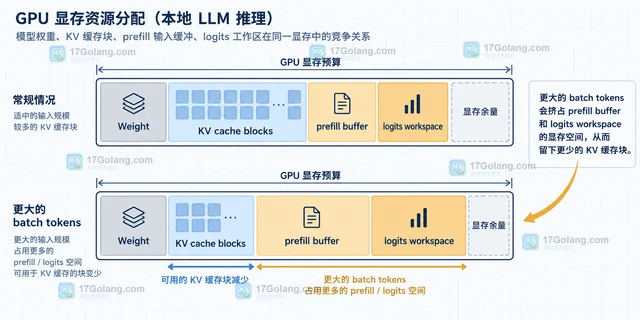
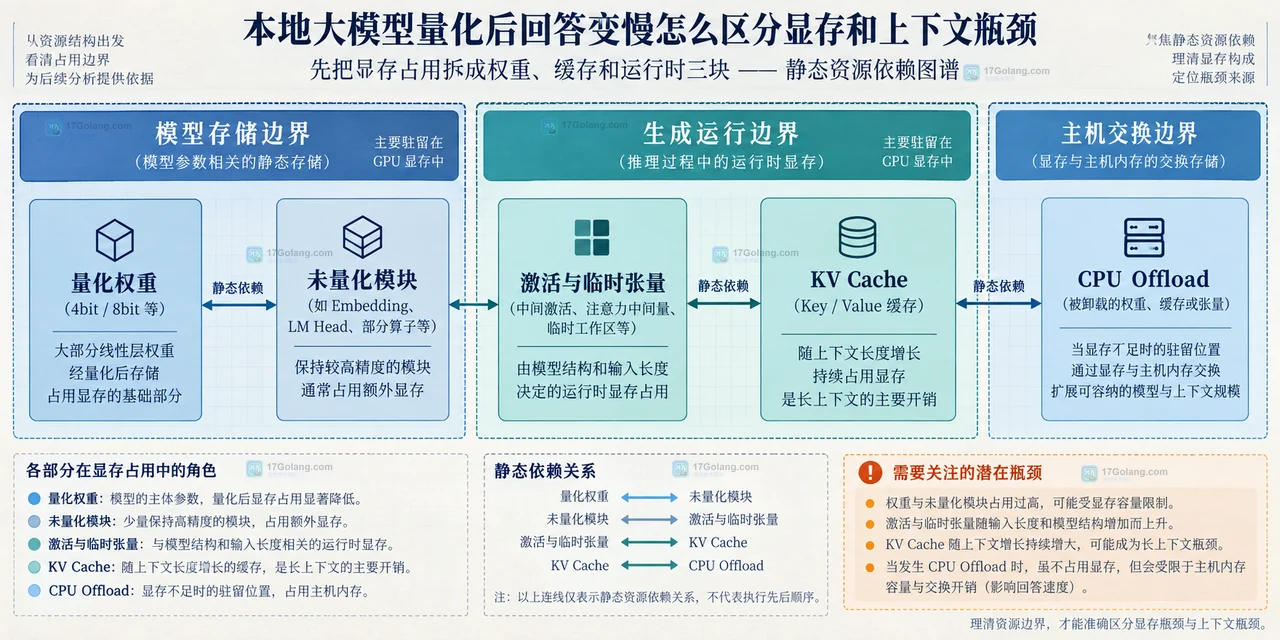
从算子和设备到显存、队列、状态与上线验收

WebGPU 本地 AI 推理常见问题
把兼容性、性能、隐私和回退判断讲清楚
浏览器支持 WebGPU 就一定能运行本地模型吗?
不一定。还要确认安全上下文、adapter/device 初始化、显存、模型算子和数据类型是否满足,并保留 WASM 或 CPU 回退。
单个 WebGPU kernel 变快为什么不代表模型整体变快?
模型整体还包括下载、初始化、shader 编译、数据上传、算子同步、输出读回和 UI 更新,必须记录首次和稳定运行的端到端指标。
WebGPU 不可用时应该降级到 WASM 还是服务端?
按模型大小、设备能力、隐私要求和延迟目标选择;通常先尝试 WASM/CPU,资源不足或模型不适配时再走服务端,并记录失败原因。
本地推理如何避免把用户数据和设备信息无意上传?
模型和输入尽量留在本地,基准遥测必须显式征得同意;只上传脱敏的失败类别和聚合指标,并为服务端回退明确告知数据边界。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- CompletableFuture 组合独立任务:allOf 结果汇总与失败归属
- 11分钟前 482浏览
-
- 把请求截止时间完整传递到数据库与下游 HTTP 调用
- 14分钟前 336浏览
-
- 用 Fiber 封装可暂停任务:启动、挂起与异常恢复
- 19分钟前 246浏览
-
- select 的 default 分支为何容易制造忙等,应该怎样改
- 24分钟前 465浏览
-
- Redis 把向量集合纳入核心数据类型意味着什么
- 27分钟前 306浏览
-
- 借助 select 同时处理结果、超时与取消信号
- 33分钟前 250浏览
-
- 工具调用型智能体如何避免重复执行同一个动作
- 42分钟前 262浏览
-
- 无缓冲和有缓冲 Channel 的选择应看吞吐还是同步语义
- 43分钟前 421浏览