
用 Go 的 database/sql 查询一条记录时,最容易写错的地方是把 QueryRow 当成了会立即返回错误的函数。它实际上总会返回一个非 nil 的 *sql.Row,没有匹配行、驱动错误和扫描错误,通常都要等到 Scan 才能看到。
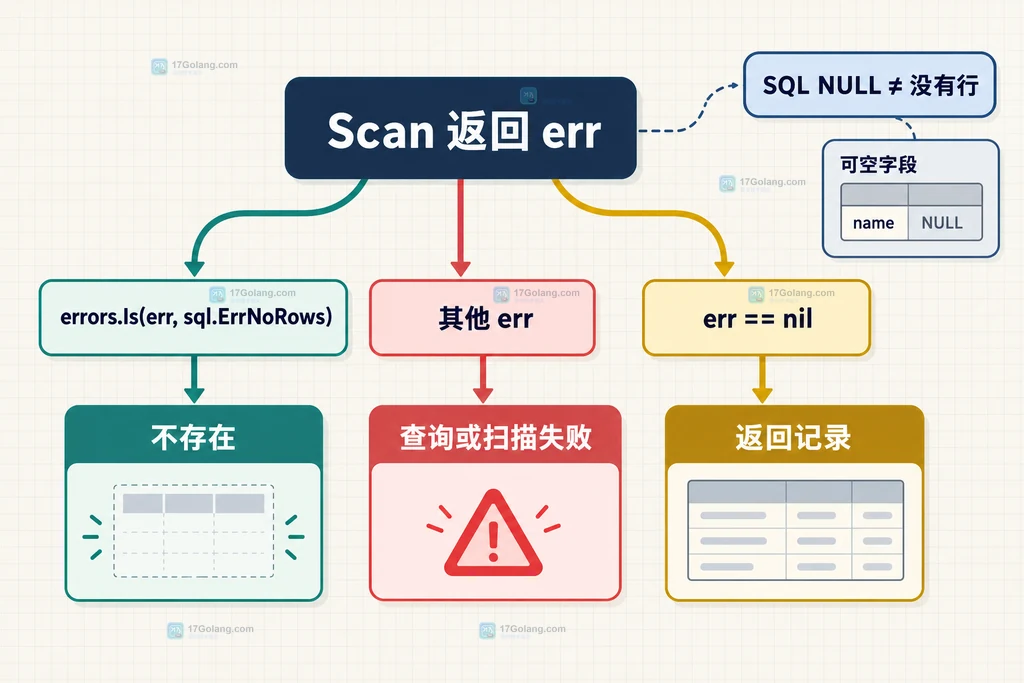
因此,判断“没有结果”的标准不是检查 QueryRow,而是检查 Scan 返回的错误是否为 sql.ErrNoRows。业务层可以把它转换成“资源不存在”,其他错误则继续作为真正的查询失败处理。
先理解 QueryRow 的完整工作流
单行查询可以拆成三个阶段:构造查询、延迟执行结果、把列扫描到变量。QueryRow 负责返回一个占位的 Row,错误会暂存在这个对象里;调用 Scan 时,数据库结果才被映射到目标变量,错误也在这里统一返回。
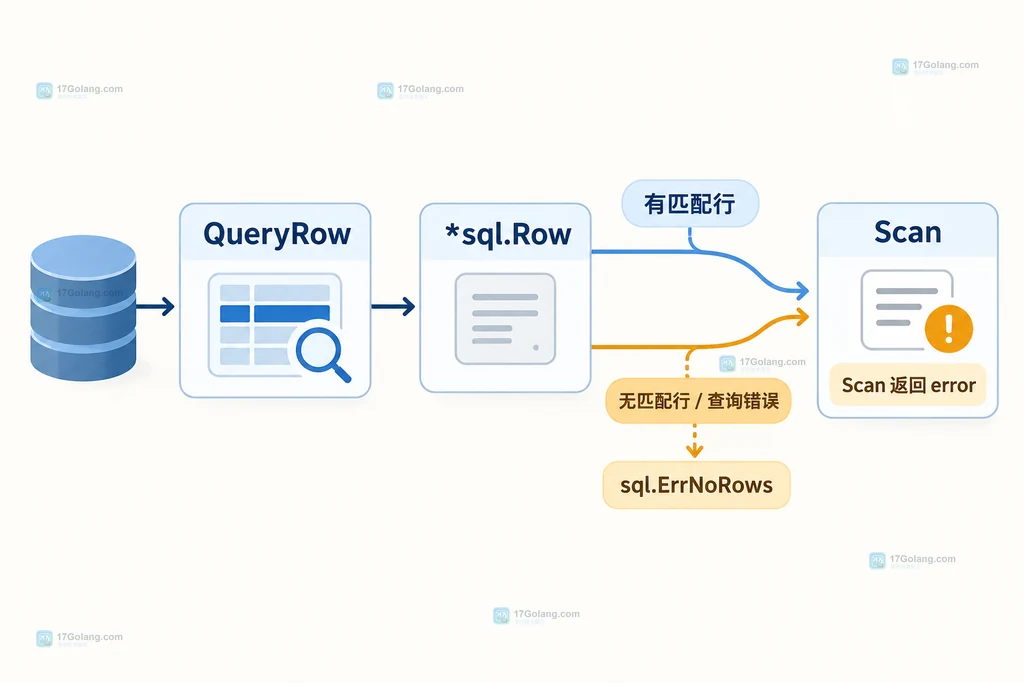
这也解释了为什么下面的写法没有意义:row := db.QueryRow(...) 之后不能从 row 本身判断是否存在记录,必须把它扫描出来。
用 sql.ErrNoRows 识别空结果
推荐在 Scan 返回后使用 errors.Is 判断。它表达的是“这个错误链中包含没有行”的语义,比只比较错误字符串可靠,也能兼容驱动或中间层对错误的包装。
package repository

import (
	"context"
	"database/sql"
	"errors"
)

type User struct {
	ID   int64
	Name string
}

// FindUser 只把“没有匹配行”转换成明确的 found=false,其他错误原样返回。
func FindUser(ctx context.Context, db *sql.DB, id int64) (User, bool, error) {
	var user User
	err := db.QueryRowContext(ctx,
		"SELECT id, name FROM users WHERE id = ?",
		id, // 参数通过占位符传递,避免把输入拼进 SQL 文本。
	).Scan(&user.ID, &user.Name)

	switch {
	case errors.Is(err, sql.ErrNoRows):
		// 空结果是正常的业务分支,不应伪装成数据库故障。
		return User{}, false, nil
	case err != nil:
		// 超时、连接、权限或扫描错误仍需交给上层处理。
		return User{}, false, err
	default:
		// Scan 成功后,user 已经填充了第一条匹配记录。
		return user, true, nil
	}
}
上层调用时可以把 found=false 映射成 HTTP 404、命令行提示或其他领域结果;不要把空结果和数据库故障混成同一个“查询失败”。
把空结果与其他错误分流
实际工程中,Scan 返回非 nil 并不只代表空结果。SQL 语法错误、连接中断、上下文超时、列类型不能转换,都会走错误分支。处理顺序应当是先识别 sql.ErrNoRows,再处理其余错误。
func loadName(ctx context.Context, db *sql.DB, id int64) (string, error) {
	var name string
	err := db.QueryRowContext(ctx,
		"SELECT name FROM users WHERE id = ?", id,
	).Scan(&name)
	if errors.Is(err, sql.ErrNoRows) {
		// 用包级错误让服务层决定返回 404 还是其他业务结果。
		return "", ErrUserNotFound
	}
	if err != nil {
		// 这里保留原始错误,便于记录超时、驱动和扫描原因。
		return "", err
	}
	return name, nil
}
如果项目定义了自己的领域错误,建议用 fmt.Errorf("user %d: %w", id, ErrUserNotFound) 包装,然后仍然用 errors.Is 判断。这样日志可以保留上下文,调用者仍能识别稳定的错误类别。
不要把 NULL 当成没有行
sql.ErrNoRows 只表示结果集没有匹配记录。若记录存在,但某个列的值是 SQL NULL,这是另一种情况:目标变量需要能够表达“没有值”,例如 sql.NullString、sql.NullInt64 或项目自己的可空类型。
var nickname sql.NullString
err := db.QueryRowContext(ctx,
	"SELECT nickname FROM users WHERE id = ?", id,
).Scan(&nickname)
if err != nil {
	// 这里仍然先区分 ErrNoRows,再处理查询本身的失败。
	return err
}
if !nickname.Valid {
	// 有这一行,只是 nickname 的 SQL 值为 NULL。
	useDefaultNickname()
} else {
	useNickname(nickname.String)
}
如果直接把 SQL NULL 扫描到普通 string,可能得到扫描错误;这个错误也不能被当成空结果。
QueryRow 的两个边界
第一,QueryRow 适合“最多需要一行”的查询。官方语义是扫描第一条匹配记录并丢弃其余记录,所以它不会帮你判断数据是否意外重复。如果业务要求必须唯一,应当在数据库加唯一约束,或改用 QueryContext 自己检查行数。
第二,QueryRow 的错误只能在 Scan 后判断。下面这种判断既捕获不到空结果,也无法区分其他查询错误:
row := db.QueryRowContext(ctx, query, id)
// 错误不在 row == nil 中体现;QueryRow 成功返回的 Row 通常非 nil。
if row == nil {
	return ErrUserNotFound
}
正确做法是把 QueryRowContext(...).Scan(...) 放在同一个错误处理点,并让调用方明确区分三种结果:找到记录、没有记录、查询失败。
一张表记住判断方式
| Scan 结果 | 含义 | 建议处理 |
|---|---|---|
nil | 至少扫描到一行,目标值可用 | 返回实体或成功结果 |
errors.Is(err, sql.ErrNoRows) | 没有匹配行 | 转换为 NotFound 等业务分支 |
| 其他非 nil 错误 | 查询、上下文、驱动或扫描失败 | 保留并上报原始错误 |
nil 但可空字段无效 | 记录存在,某列是 SQL NULL | 检查 sql.Null* 的 Valid |
常见问题
为什么 QueryRow 不直接返回 ErrNoRows?
因为它返回的是延迟读取的 Row。只有调用 Scan 时,程序才知道需要哪些目标列并完成结果映射,所以空结果错误在 Scan 阶段返回。
可以直接写 err == sql.ErrNoRows 吗?
简单代码可以这样写,但工程代码更适合 errors.Is,尤其是错误可能经过包装时。不要比较错误字符串。
QueryRow 查到多行会报错吗?
不会自动因为多行而报错;它扫描第一行并忽略其余行。需要唯一性保证时,应把约束放在数据库或改用多行查询自行检查。
结语
记住一个判断点就够了:QueryRow 本身不报告空结果,Scan 才是错误汇合点;用 errors.Is(err, sql.ErrNoRows) 识别没有行,再把 SQL NULL、查询失败和多行边界分别处理,代码的业务语义会清晰很多。
官方文档:https://pkg.go.dev/database/sql
Go 数据库查询指南:https://go.dev/doc/database/querying




