
Go Zap 采样为什么按等级和消息而不是所有字段分组
来源:17golang原创
时间:2026-10-29 13:12:23 134浏览 收藏
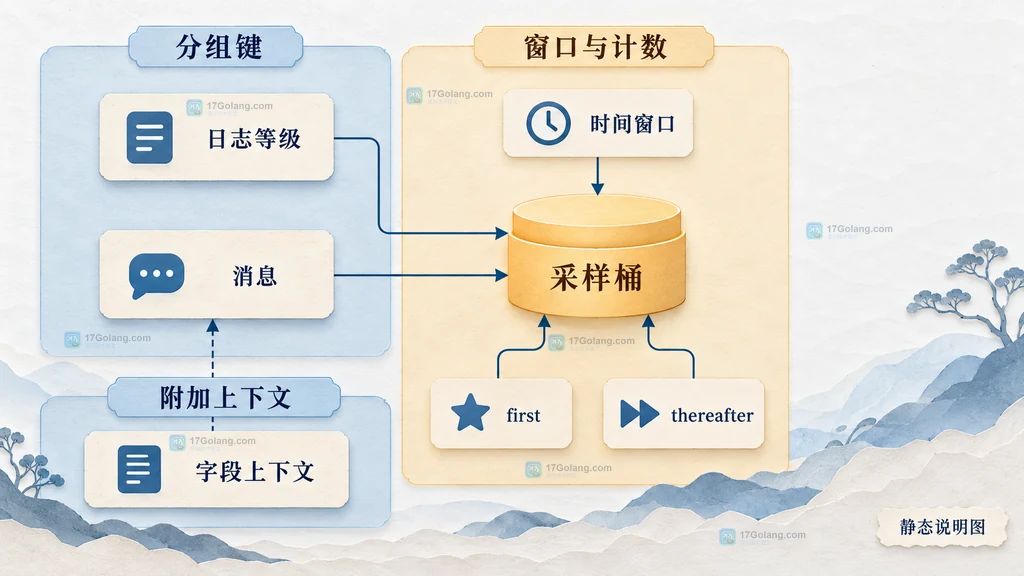
如果你给每条 Zap 日志都带上不同的 request_id、用户或延迟字段,却发现高频日志仍然被稳定采样,原因通常不是字段丢了,而是这些字段本来就不是默认采样分组键。Zap 按一个时间窗口里的“日志等级 + 消息”识别重复事件,字段只作为这次事件的上下文。
官方地址:https://pkg.go.dev/go.uber.org/zap
先把采样桶写成可观察的规则
Zap 的默认生产配置启用采样。官方文档给出的默认值是 100:100:同一秒内,某个等级和某条消息先放行 100 条,之后每 100 条再放行 1 条。zapcore.NewSamplerWithOptions 的规则也是同一时间窗口内按“同等级、同消息”计数。
可以把它抽象成一个键:
// 采样键只表达“这是什么重复事件”,不承载每次请求的全部上下文
sampleKey := logLevel + "|" + message

// first 控制窗口内先保留多少条,thereafter 控制后续每隔多少条保留一条
core = zapcore.NewSamplerWithOptions(core, time.Second, first, thereafter)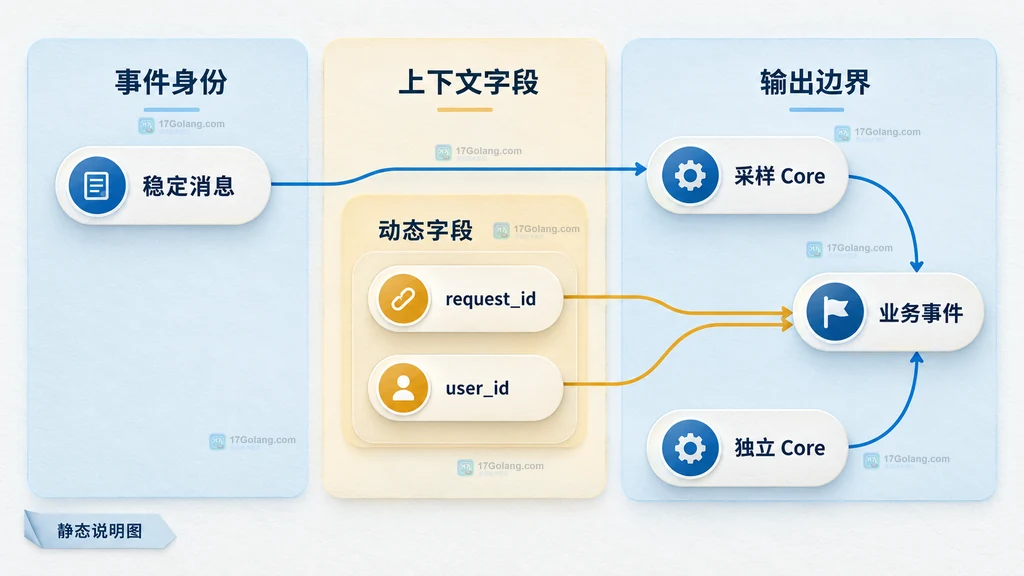
因此,下面两条日志虽然字段值不同,只要等级和消息相同,仍可能进入同一个采样桶:
// request_id 和 user_id 用来补充上下文,不会自动创建新的采样桶
logger.Info("订单同步失败",
    zap.String("request_id", "req-1001"),
    zap.String("user_id", "u-7"),
)
logger.Info("订单同步失败",
    zap.String("request_id", "req-1002"),
    zap.String("user_id", "u-8"),
)
字段为什么不进入默认分组
这里有一个工程取舍:消息通常描述事件类型,字段描述事件实例。如果把所有字段都放入采样键,request_id、时间戳、订单号和随机错误文本会让几乎每条日志都变成“新组合”,采样就很难压住突发流量;同时,采样状态还会被高基数数据拖大。
只使用等级和消息,还有两个直接收益。第一,ERROR 与 INFO 不会相互抢同一份配额,重要级别的重复错误可以独立保留。第二,同一类事件即使附带不同请求上下文,仍能共享抑制策略,避免日志系统被每个请求的差异打散。
这不等于字段无意义。采样器决定“是否写出这条记录”,真正写出时,Zap 仍会把字段编码到日志中。需要排查某个请求时,应该在被保留的记录里读取字段,而不是期待字段改变采样桶。
用 first 和 thereafter 调整采样强度
如果默认比例不适合业务,可以显式包裹 Core。下面的配置表示每秒内同一等级、同一消息先保留 10 条,之后每 20 条保留 1 条。
package main

import (
    "time"

    "go.uber.org/zap"
    "go.uber.org/zap/zapcore"
)

func buildLogger() (*zap.Logger, error) {
    base, err := zap.NewProduction()
    if err != nil {
        return nil, err
    }

    // 把采样包在已有 Core 外面,按每秒的等级与消息控制重复量
    sampledCore := zapcore.NewSamplerWithOptions(
        base.Core(), time.Second, 10, 20,
    )
    return zap.New(sampledCore), nil
}
thereafter 设为 0 时,窗口内超过 first 条的同类日志都会被丢弃;它不是“关闭采样”的写法。若要关闭配置采样,应在配置中把 Sampling 设为 nil,再按需求构造 Logger。
确实要区分事件时,改变事件表达而不是塞入动态 ID
如果“订单同步失败”和“库存同步失败”是两类需要独立配额的事件,应使用稳定、低基数的消息区分它们,例如分别写成 订单同步失败 与 库存同步失败,把订单号和请求号继续放在字段里。不要把 request_id 拼进消息:那会把每次请求都变成不同事件,直接削弱采样效果。
如果一条日志既要进入采样后的常规输出,又要完整写入审计流,可以为不同输出构造不同的 Core,并明确每个 Core 的采样职责。这样改变的是输出边界,不是误把上下文字段当成全局采样键。
排查采样结果时看这三点
- 先比较等级和消息是否真的相同;消息中的动态数字、错误文本变化会自然形成不同事件。
- 再确认时间窗口与
first/thereafter;官方也提醒高负载下采样量可能略有偏差,不能把它当成精确限流器。 - 最后区分“采样丢弃”与“输出 Core 未启用”:字段没有进入采样键,不代表字段编码或输出配置失效。
相关问题
同一条消息换了 request_id,会重新开始计数吗?
默认不会。只要日志等级和消息仍相同,它们共享同一个采样分组;request_id 只是这条记录的上下文。
想让不同业务类型各自采样,应该怎么办?
用稳定的业务事件名区分消息,或为不同输出建立独立 Core。避免把订单号、用户 ID 等高基数值拼进消息。
一句话总结:Zap 采样优先识别“重复发生的事件”,而不是识别“每次事件携带的全部数据”。等级和消息决定配额,字段负责让被保留的日志具备排查上下文。
-
211 收藏
-
328 收藏
-
348 收藏
-
431 收藏
-
490 收藏
-
101 收藏
-
264 收藏
-
408 收藏
-
251 收藏
-
343 收藏
-
249 收藏
-
419 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习