
如果你要在 UUID 中放入一部分由业务控制的字段,Python 3.14 新增的 uuid.uuid8(a, b, c) 可以直接完成这件事。它会按 UUIDv8 的布局接收三个整数:a 使用 48 位,b 使用 12 位,c 使用 62 位;传入值太大时只保留低位,省略的参数则由伪随机整数补齐。
最稳妥的用法是把 uuid.uuid8 当作“带自定义块的非密码学 UUID”:先在业务层明确字段范围,再传入三个整数;如果目标是不可预测的安全标识,直接使用 uuid.uuid4()。
官方地址:https://docs.python.org/3/library/uuid.html
uuid.uuid8 解决的是什么问题
UUIDv4 适合生成随机标识,但它不表达业务字段。UUIDv8 给了调用方三个可控输入位置,适合把版本、分片号、业务类别或内部编码的一部分映射进 UUID。不过这不是“把任意三段数据原样拼接进去”:版本位和变体位仍由 UUID 布局占用,三个参数也各有固定的有效位宽。
| 参数 | 有效位宽 | 使用建议 |
|---|---|---|
a | 48 位 | 放较大的业务分区、时间片或外部编号,调用前确认是否需要截断 |
b | 12 位 | 适合较小的类型、区域或版本字段 |
c | 62 位 | 保留更大的业务序列或组合值,但仍不是密码学随机空间 |
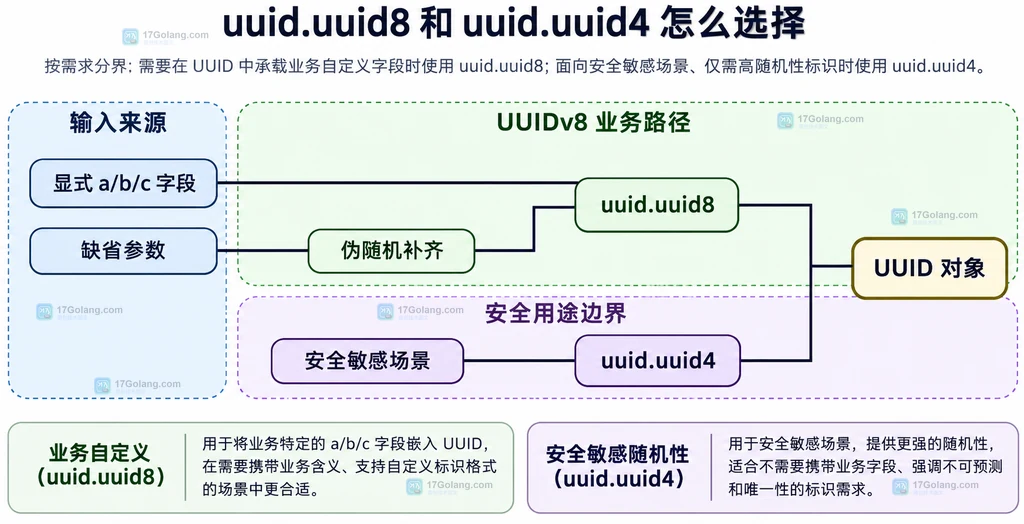
三个参数怎样映射到 UUID
uuid.uuid8(a=None, b=None, c=None) 的参数都应是非负整数。官方文档规定它们分别按 48、12、62 位处理。比如 b 即使传入了更大的整数,也不会让 UUID 额外获得位数,而是只保留它的低 12 位。
这条规则很重要:如果字段来自数据库自增值、哈希片段或外部协议,应该先在业务层检查范围,而不是等生成 UUID 后才发现高位已被丢弃。
用显式字段生成 uuid.uuid8
下面的封装把字段范围写清楚,并把输入收敛到文档规定的位宽。这样做的好处是,调用方可以在生成前发现错误,而不是静默接受截断。
import uuid

def make_uuid8(a: int, b: int, c: int) -> uuid.UUID:
    # 三个字段必须是非负整数,避免把负数当成隐式位模式传入。
    if min(a, b, c) < 0:
        raise ValueError("uuid.uuid8 的字段不能为负数")

    # 明确限制位宽;超出范围时保留低位,和 uuid.uuid8 的规则一致。
    a48 = a & ((1 << 48) - 1)
    b12 = b & ((1 << 12) - 1)
    c62 = c & ((1 << 62) - 1)

    # Python 3.14+ 提供 uuid.uuid8;版本位和变体位由实现负责设置。
    return uuid.uuid8(a48, b12, c62)

item_id = make_uuid8(0x12345678, 0x234, 0x112233445566)
print(item_id)
print(item_id.version)  # 读取版本号,确认这是 UUIDv8
示例里的掩码不是为了改变 UUID 的布局,而是把“只取低位”的行为显式化。若你的业务字段超范围应该直接报错,也可以把掩码替换成上限检查,让输入错误尽早暴露。
省略参数时会发生什么
a、b、c 可以分别省略。例如 uuid.uuid8(b=7) 会保留 b 的显式值,另外两块使用适合各自位宽的伪随机整数。省略参数只表示“由库补齐”,不表示三个字段都变成了密码学安全随机数。
import uuid

# 只固定中间字段,其余字段由标准库补齐。
value = uuid.uuid8(b=7)

# 读取稳定的结构信息;不要把内部字段当作安全凭据。
print(value.version)
print(value.variant)
字段、版本和变体怎样核对
生成结果是 uuid.UUID 对象,可以读取 version、variant 和 fields。这些属性适合做结构性检查,但不要据此推断输入值能完整地从字符串中还原:版本位、变体位以及字段排列都属于 UUIDv8 布局的一部分。
import uuid

value = uuid.uuid8(0x12345678, 0x234, 0x112233445566)

# fields 是 UUID 的六段标准字段,不等于 uuid.uuid8 的三个参数原样回显。
time_low, time_mid, time_hi_version, clock_seq_hi, clock_seq_low, node = value.fields
print("版本:", value.version)
print("变体:", value.variant)
print("标准字段:", time_low, time_mid, time_hi_version, clock_seq_hi, clock_seq_low, node)
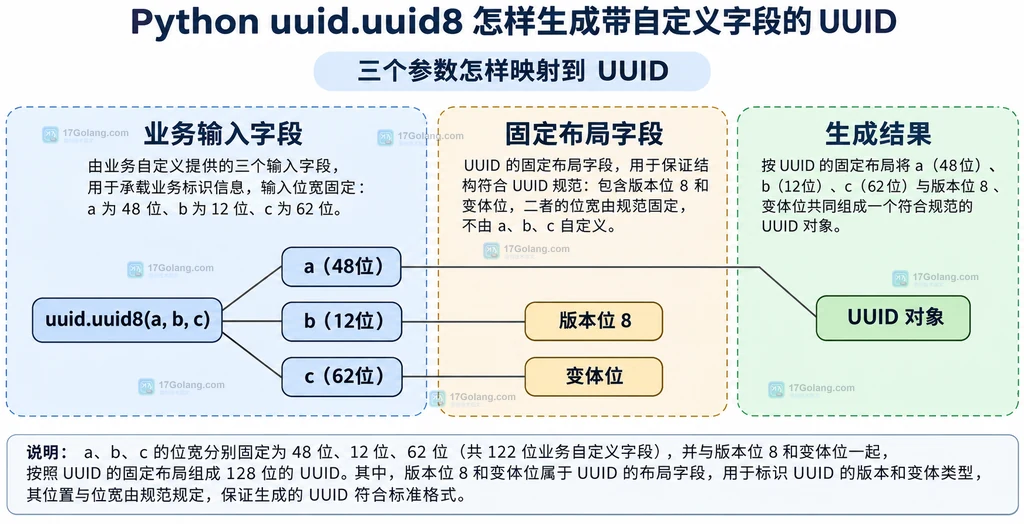
uuid.uuid8 和 uuid.uuid4 怎么选择
| 需求 | 选择 | 原因 |
|---|---|---|
| 需要把业务字段映射进 UUID | uuid.uuid8 | 三个参数可控,但要自行约束字段范围与碰撞策略 |
| 生成登录令牌、重置令牌或安全随机标识 | uuid.uuid4 | uuid.uuid8 的默认随机来源不是密码学安全随机数 |
| 需要稳定地由名称生成同一个 UUID | uuid.uuid3 或 uuid.uuid5 | 它们按命名空间和名称计算,不依赖 uuid.uuid8 的自定义块 |
此外,uuid.uuid8 并不自动提供数据库唯一约束、时间排序或业务字段的可逆编码。是否唯一仍取决于你的输入设计和存储约束;是否按时间排序也不能只看“UUIDv8”这个版本号。
命令行能不能直接生成 UUIDv8
Python 3.14 起,uuid 模块提供命令行入口,并允许通过 -u uuid8 选择 UUIDv8。但命令行入口主要用于快速生成,不能像 Python API 一样直接把三个自定义整数参数分别传给 uuid.uuid8(a, b, c);需要固定业务字段时,优先使用代码调用。
# 使用 Python 3.14+ 的 uuid 命令行入口生成 UUIDv8。
python -m uuid -u uuid8
常见问题
uuid.uuid8 能不能用来生成密码重置链接中的令牌?
不建议。官方文档明确提示 uuid.uuid8 的默认随机字段不是密码学安全随机数,安全敏感场景应选择 uuid.uuid4,并结合服务端一次性、过期时间和存储校验。
把超大的整数传给 uuid.uuid8 会报错吗?
超过对应位宽时,标准库只保留低位。若高位包含业务信息,调用前应主动检查并拒绝,而不是依赖静默截断。
uuid.uuid8 的三个参数能从最终字符串完全还原吗?
不能简单这样假设。版本位和变体位占用固定位置,参数还会按不同位宽进入 UUID 布局;如果需要可审计的还原关系,应把字段编码规则单独写进协议并配套测试。
Python 3.13 能调用 uuid.uuid8 吗?
不能依赖它。uuid.uuid8 是 Python 3.14 新增的标准库 API,旧版本需要升级,或根据兼容策略选择已有的 UUID 生成方式。
小结
uuid.uuid8 的核心不是“生成另一种随机 UUID”,而是为业务提供三个受限的自定义字段。记住三点即可:a/b/c 分别按 48/12/62 位处理;超范围只保留低位、缺省值由伪随机数补齐;安全敏感场景不要使用 uuid.uuid8,改用 uuid.uuid4。




