
Volcano NamespaceQueue 怎样为 AI 任务安排公平队列
来源:17golang原创
时间:2026-11-05 13:43:54 241浏览 收藏
Volcano v1.16.0 把 AI 集群里的“队列归属”和“历史公平”拆成了两项能力:NamespaceQueue 负责让租户在自己的命名空间内管理队列层级,fairshare 负责多个命名空间共用一个 Queue 时,按历史资源消耗重新安排待调度任务。要给训练或推理任务做公平排队,先选对模型,再写配置;不要把 NamespaceQueue 当成 fairshare 的替代品。
- 每个团队拥有自己的命名空间队列时,用 NamespaceQueue 加授权的 cluster Queue。
- 多个命名空间共享一个 GPU Queue 时,再用 fairshare 记录资源秒数并按半衰期衰减。
- fairshare 只影响待调度任务的顺序或入队,不会抢占已经运行的 AI 作业。
最稳妥的组合是:NamespaceQueue 解决“谁能在什么层级配置队列”,fairshare 解决“共享资源时谁应该先获得下一次调度机会”。如果每个团队已经被分到独立 Queue,先用 Queue 的 capacity/DRF 规则,不要为了“公平”额外套一层 fairshare。
先区分 NamespaceQueue 与 fairshare 的职责
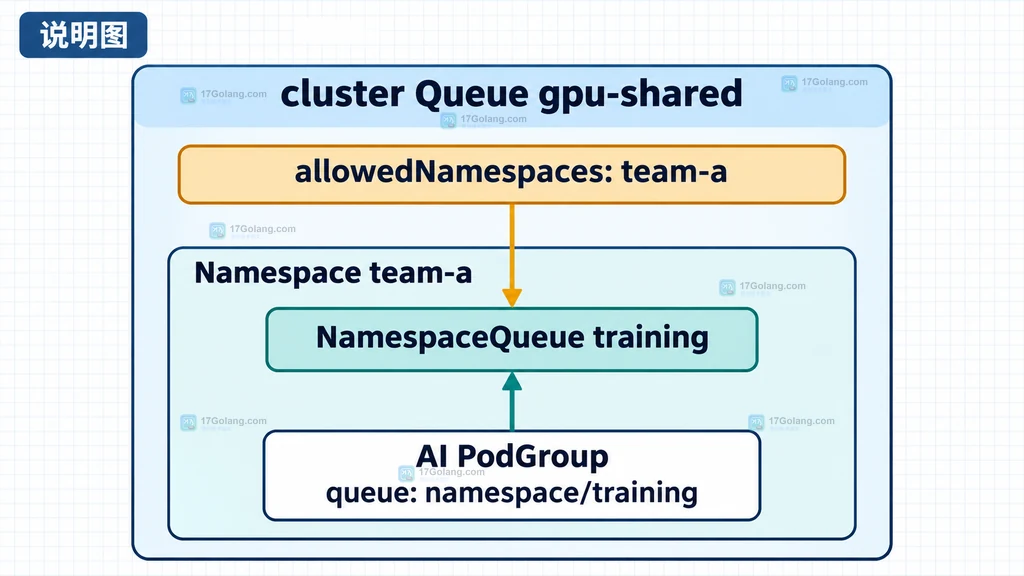
NamespaceQueue 是命名空间作用域的队列资源,租户可以在自己的 Namespace 内创建父子队列,但父树必须挂到管理员授权的 cluster Queue 上。它支持 capability、deserved、guarantee、reclaimable 和 priority 等资源语义,目前属于 Alpha 能力,默认关闭,初始调度支持依赖层级 capacity 插件。
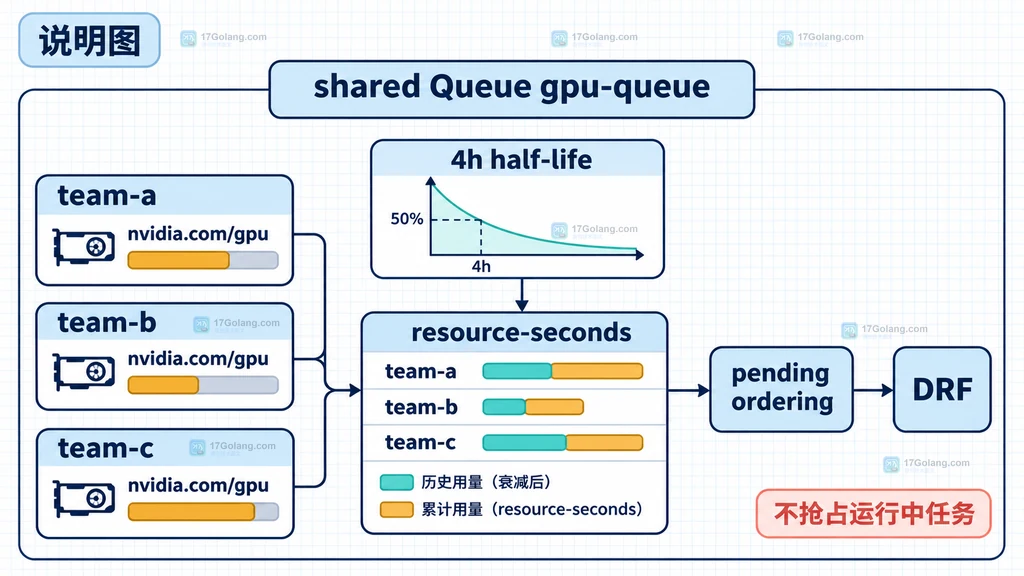
fairshare 的对象则是“同一个 Queue 里的多个命名空间”。它记录每个命名空间消耗的资源秒数,默认以四小时为半衰期衰减;历史消耗较少的命名空间优先考虑。这个策略针对的是一个团队连续提交大量 GPU 任务、后来者长期排不到的问题。
为租户队列打开 NamespaceQueue
安装或升级时先打开功能开关。管理员还要在父 Queue 中授权命名空间,并给租户只授予本命名空间内 namespacequeues 的 RBAC 权限:
# 开启 NamespaceQueue;v1.16.0 的 Helm 参数会同步配置相关组件
helm upgrade --install volcano volcano-sh/volcano \
  --namespace volcano-system --create-namespace \
  --version 1.16.0 \
  --set custom.namespace_queue_enable=true
apiVersion: scheduling.volcano.sh/v1beta1
kind: Queue
metadata:
  name: gpu-shared
spec:
  # 只允许 team-a 把命名空间队列挂到这个资源池
  allowedNamespaces:
    - team-a
---
apiVersion: scheduling.volcano.sh/v1beta1
kind: NamespaceQueue
metadata:
  name: training
  namespace: team-a
spec:
  # cluster/ 前缀表示父级是集群范围的 Queue
  parent: cluster/gpu-shared
  capability:
    nvidia.com/gpu: "8"
  deserved:
    nvidia.com/gpu: "4"
  reclaimable: true
---
# Job 或 PodGroup 必须显式引用命名空间队列
spec:
  queue: namespace/training
提交 AI 作业前先看 NamespaceQueue 的 Ready=True 和 Authorized=True。自定义 scheduler 配置时要保留 capacity 的 enableHierarchy: true,不要同时启用 proportion;父 Queue 的空 allowedNamespaces 不会授权任何命名空间。
共享 GPU Queue 时再启用 fairshare
如果 team-a、team-b 和 team-c 都把 PodGroup 提交到同一个 gpu-queue,可以在 scheduler tier 中把 fairshare 放在 drf 之前,让历史消耗先参与比较:
actions: "enqueue, allocate, backfill"
tiers:
  - plugins:
      # PriorityClass 仍先决定高优先级任务是否越过公平排序
      - name: priority
      - name: gang
      - name: fairshare
        arguments:
          # 只对共享 GPU 队列累计历史用量
          fairshare.targetQueues: "gpu-queue"
          fairshare.resourceKey: "nvidia.com/gpu"
          # 240 分钟即四小时半衰期
          fairshare.halfLifeMinutes: "240"
          # 先只重排等待任务,稳定后再评估入队门控
          fairshare.enableEnqueueGate: "false"
          fairshare.persistState: "false"
  - plugins:
      # DRF 继续处理当前资源占用的公平性
      - name: drf
      - name: capacity
      - name: predicates
      - name: nodeorder
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
| 队列对象未生效 | 功能开关、Ready、Authorized | 补齐父 Queue 授权和命名空间 RBAC |
| 公平排序没有变化 | 多个命名空间是否共用同一 Queue | 检查 targetQueues、resourceKey 与 fairshare 顺序 |
| 重启后历史消失 | persistState 默认关闭 | 确认是否接受内存状态,或启用 ConfigMap 持久化 |
| 后来者仍然等待 | 运行中任务和优先级策略 | 记住 fairshare 不抢占运行中作业,先观察 pending 排序 |
用三组证据确认公平策略真的工作
验证时不要只看某一次绑定结果。分别在三个命名空间提交相近的 GPU PodGroup,记录提交顺序、当前运行资源和完成时间,再做一次“单一命名空间突发提交”的对照。fairshare 的预期是:突发租户的历史资源秒数升高后,其他命名空间的待调度任务获得更早机会;经过半衰期后,旧消耗的影响逐步减弱。
最后检查三条边界:PriorityClass 仍可能优先于公平排序;长期运行的 GPU 作业不会因为 fairshare 自动被杀掉;NamespaceQueue 的租户授权和 fairshare 的共享排序是两条独立链路。需要跨 scheduler 重启保留历史时,再评估 ConfigMap 持久化带来的运维成本。
常见问题
NamespaceQueue 能直接替代 fairshare 吗?
不能。NamespaceQueue 管理命名空间内的队列层级和资源授权;fairshare 处理同一 Queue 内多个命名空间的历史用量排序。
fairshare 会不会抢占正在训练的 GPU 作业?
不会。它主要重排 pending 任务,并可选地阻止部分任务入队;已经运行的任务不会被 fairshare 插件主动抢占。
为什么每个团队一个 Queue 时看不到 fairshare 效果?
因为公平比较的范围在 Queue 内。队列已经隔离时,应先检查 Queue 的 capacity、deserved、guarantee 或 DRF 配置,而不是期待跨 Queue 的 fairshare 排序。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
281 收藏
-
科技周边 · 业界新闻 | 9分钟前 | 云原生 · kubernetes · 网络安全 · eBPF 网络策略 Cilium CiliumNetworkPolicy CiliumClusterwideNetworkPolicy toServices 节点策略196 收藏
-
297 收藏
-
科技周边 · 业界新闻 | 10分钟前 | 云原生 · 性能优化 · kubernetes · 人工智能 · Kubernetes LLM推理 llm-d GPU路由 Endpoint Picker InferencePool DCGM138 收藏
-
213 收藏
-
280 收藏
-
426 收藏
-
268 收藏
-
170 收藏
-
150 收藏
-
448 收藏
-
490 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习