
Hugging Face Transformers 怎样为推理启用半精度
来源:17golang原创
时间:2026-11-07 22:55:25 212浏览 收藏
用 Hugging Face Transformers 做推理,半精度不是简单地在模型后面调用一次 half()。更稳妥的做法是:加载模型时通过 dtype=torch.float16 或 torch.bfloat16 控制权重实例化;需要混合精度前向时,再用 torch.autocast 让适合降精度的算子使用半精度,其余敏感算子保留更高精度。这样既能压低显存,也能给不兼容算子留下回退边界。
- CUDA 设备先检查 BF16 支持,支持时通常优先尝试
bfloat16;不支持再考虑float16。 dtype影响模型权重加载,autocast影响前向区域内的算子计算,两者解决的问题不同。- 推理必须配合
model.eval()与torch.inference_mode(),上线前还要核对输出质量和显存峰值。
先区分加载精度和计算精度
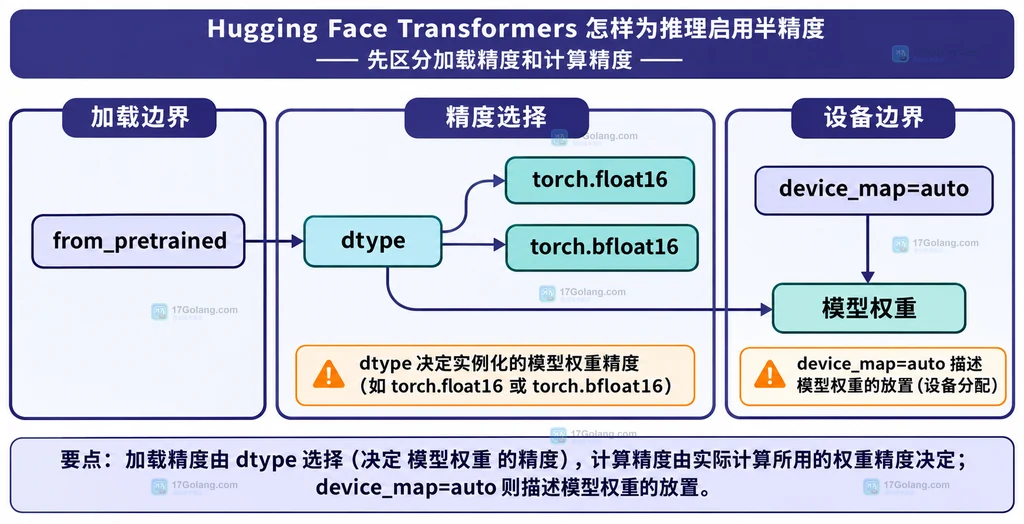
我在处理显存紧张的模型服务时,第一步不会直接把所有输入转成半精度,而是先看模型是以什么精度加载的。Transformers 当前文档把 dtype 作为 from_pretrained() 的模型权重实例化参数;dtype="auto" 则尝试读取配置中的 dtype 或旧的 torch_dtype,缺失时再参考检查点中的首个浮点权重。
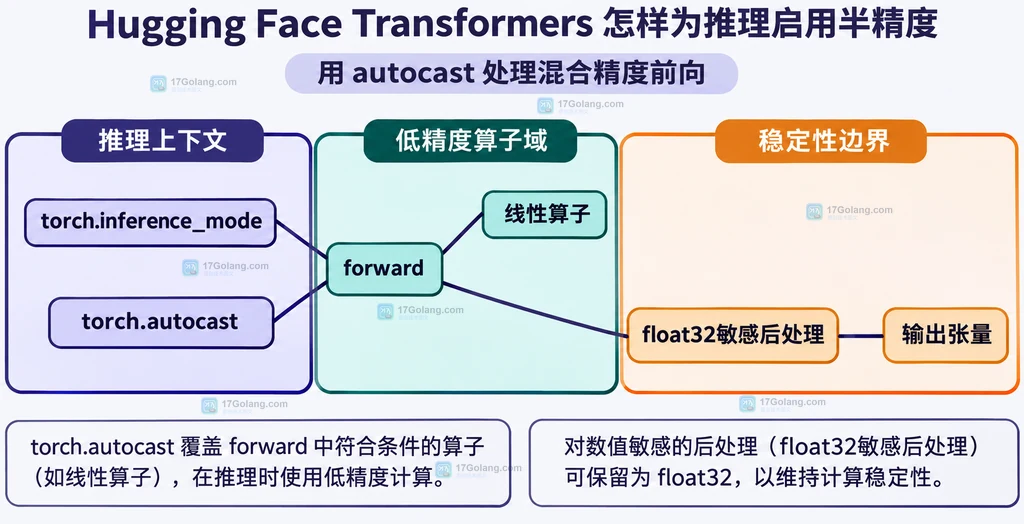
这一步决定了常驻权重的显存占用。torch.autocast 是另一层机制,它只包住前向计算,让适合低精度的矩阵运算降精度,同时允许需要动态范围的算子按策略保留 float32。所以,想减少模型常驻显存时设置 dtype;想在已有模型上做混合精度前向时考虑 autocast。
根据设备选择 bfloat16、float16 或 float32
bfloat16 的指数范围接近 float32,在支持它的 CUDA 设备上通常比 float16 更容易保留数值范围;但具体吞吐仍取决于硬件、模型架构和内核。float16 兼容面更广,却更容易遇到溢出或 NaN。CPU 推理不要为了“半精度”强行改权重,先以 float32 跑通,再根据 PyTorch 与目标硬件的 AMP 支持评估 BF16。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "google/gemma-3-1b-it"  # 示例模型 ID,换成你有权限使用的检查点
device = "cuda" if torch.cuda.is_available() else "cpu"

if device == "cuda":
    # 先判断硬件是否支持 BF16,避免在不支持的设备上盲选
    dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16
else:
    # CPU 先保持 FP32,避免把不兼容的半精度内核带进服务
    dtype = torch.float32

load_args = {"dtype": dtype}
if device == "cuda":
    # 让 Accelerate 按可用设备安排大模型权重
    load_args["device_map"] = "auto"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, **load_args)
model.eval()  # 关闭 Dropout 等训练态行为

inputs = tokenizer("用一句话解释半精度推理", return_tensors="pt")
inputs = inputs.to(model.device)  # 输入与模型保持同一设备
with torch.inference_mode():
    output = model.generate(**inputs, max_new_tokens=48)
print(tokenizer.decode(output[0], skip_special_tokens=True))  # 仅展示解码结果
这里的关键不是模型名称,而是加载边界:dtype 直接传给 from_pretrained(),避免先以 FP32 建立一份完整权重再转换。若模型配置已经可靠记录权重精度,也可以把它改成 dtype="auto";这表示沿用检查点信息,不等于自动判断“哪种精度一定最快”。
用 autocast 处理混合精度前向
当模型仍以 FP32 加载,或者自定义模块对权重精度有明确要求时,可以把降精度范围限制在前向区域。PyTorch 的推荐入口是 torch.autocast(device_type="cuda", dtype=...);推理场景不需要训练用的梯度缩放器。若某个自定义算子只接受 FP32,应把它放在禁用 autocast 的局部区域,而不是把整个模型退回 FP32。
# model 已经加载,inputs 也已放到 CUDA
amp_dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16
with torch.inference_mode():
    # autocast 只影响前向中的可转换浮点算子
    with torch.autocast(device_type="cuda", dtype=amp_dtype):
        outputs = model(**inputs)

    # 对必须保持 FP32 的后处理显式转换,避免数值边界不清
    scores = outputs.logits.float().softmax(dim=-1)
    best_token = scores[:, -1, :].argmax(dim=-1)  # 取最后位置的最高分 token
上线前用四项检查收住风险
| 检查项 | 关注信号 | 处理建议 |
|---|---|---|
| 设备与 dtype | 模型参数、输入设备是否一致 | 打印少量参数的 device 与 dtype,不要凭配置猜 |
| 数值稳定 | NaN、Inf、输出明显漂移 | 先切换 BF16/FP32 对比,必要时对敏感算子禁用 autocast |
| 资源峰值 | 首次加载或长序列时 OOM | 记录加载峰值和生成峰值,分别调小 batch、序列长度或换 dtype |
| 质量回归 | 固定样例的分类、排序或生成结果变化 | 用业务样本做 FP32 基线,接受半精度前设定可解释阈值 |
我的判断是:显存主要卡在权重常驻时,优先改 from_pretrained(dtype=...);显存尚可但想让部分前向算子降精度时,再引入 autocast。两者都要在目标设备上做小批量回归,不能用一次成功生成就证明半精度适合所有输入。
相关问题
可以直接对 Transformers 模型调用 model.half() 吗?
可以作为明确的实验手段,但它会修改已加载模型的参数,且可能把不适合 FP16 的模块一起转换。更可控的做法是加载时传入 dtype,或只在前向区域使用 autocast。
dtype="auto" 是否等于自动选择最佳推理精度?
不是。它主要沿用配置或检查点记录的浮点 dtype,解决加载路径和内存模式问题,不替你比较硬件吞吐、准确率和业务样本。
为什么用了半精度仍然 OOM?
权重只是显存的一部分,KV cache、激活、输入序列、批大小和 device map 都会产生额外占用。先区分加载峰值与生成峰值,再调整序列长度或批处理策略。
-
科技周边 · 人工智能 | 2个月前 | 人工智能 · Hugging Face Transformers generate output_scores compute_transition_scores 长度惩罚 生成概率374 收藏
-
457 收藏
-
308 收藏
-
260 收藏
-
286 收藏
-
441 收藏
-
428 收藏
-
111 收藏
-
160 收藏
-
408 收藏
-
259 收藏
-
440 收藏
-
426 收藏
-
177 收藏
-
123 收藏
-
218 收藏
-
435 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习