-
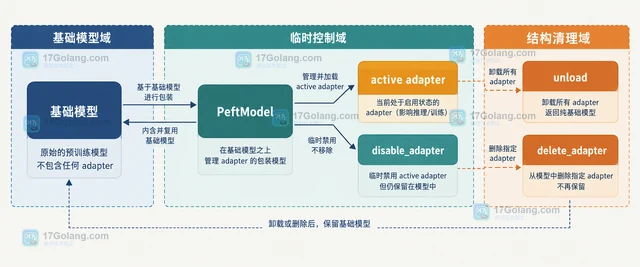
PEFT 中临时禁用 adapter、移除 LoRA 模块、删除命名 adapter 和合并权重是四种不同操作。本文用 unload 返回基础模型,说明为什么必须接住返回值,并整理多 adapter 与 Notebook 重跑时的排查边界。
-
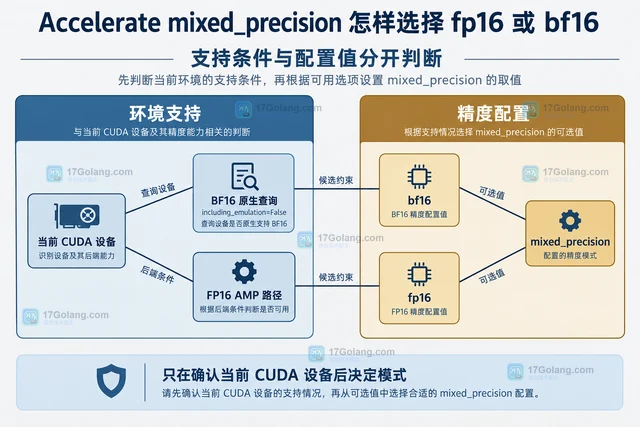
Accelerate 的 fp16 与 bf16 应按当前设备支持和模型数值行为选择。本文限定普通单卡 CUDA 场景,说明保守 BF16 查询、完整参数接入、梯度缩放与 no 模式对照,不以启动成功代替训练稳定性判断。
-
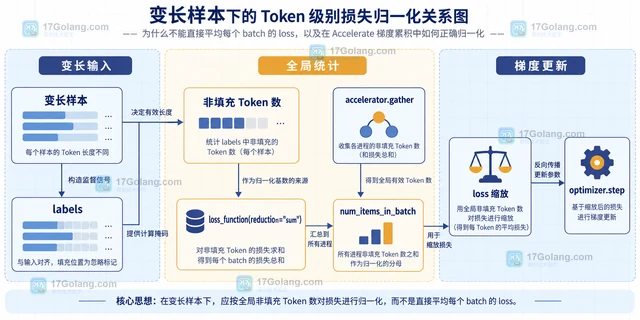
显存有限时,Accelerate 可以用 gradient_accumulation_steps 把多个 micro-batch 合成一次参数更新。本文说明 Accelerator、accumulate(model)、scheduler 与变长 token loss 归一化的配置边界。
-
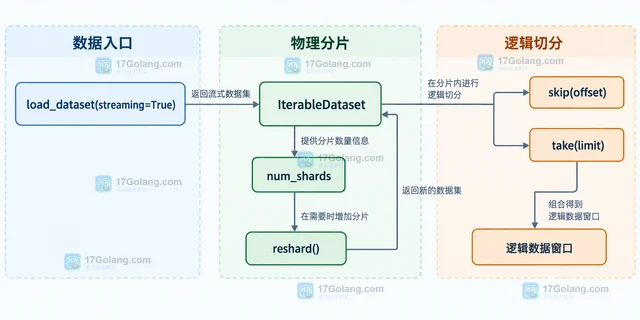
Hugging Face Datasets 的 IterableDataset 如果 reshard 后仍只有一个 shard,继续调用物理分片并不能解决切分问题。正确做法是先完成 shuffle,再用 skip 和 take 构造逻辑窗口,并明确 offset、limit、短流和重复遍历的边界。
-
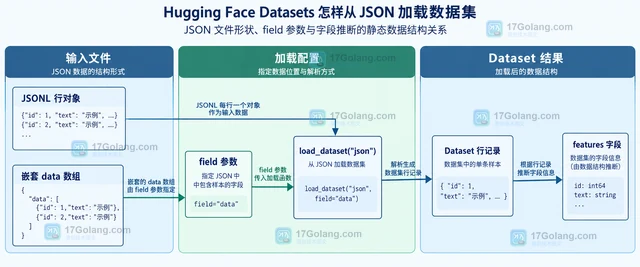
Hugging Face Datasets 读取 JSON 的关键是先判断根结构:JSONL 通常直接加载,嵌套数组要用 field 指向数据字段;多个文件则用 data_files 映射到 train、validation 等 split。本文给出最小写法、字段推断观察方式和常见排错边界。
-
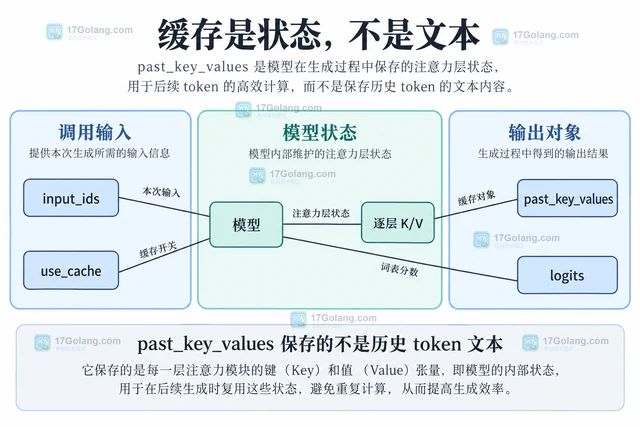
Transformers 的 past_key_values 保存已处理上下文的逐层 K/V,use_cache 控制缓存输出。本文用 GPT-2 原创示例解释新增 token、完整掩码与缓存长度的配合,并说明对象复用和内存边界。
-
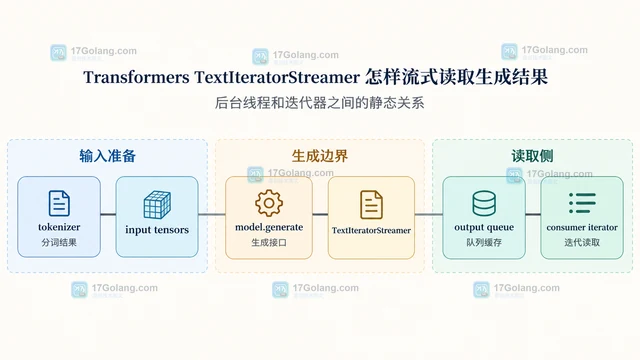
Transformers 的 TextIteratorStreamer 可以把 model.generate 放在独立线程中,再由消费端逐段迭代生成文本。本文按线程、队列、提示词、超时和异常边界说明一套可维护的写法。
-
Transformers 的 chat template 不是装饰性格式,而是模型训练时使用的控制 token 约定。本文只围绕 apply_chat_template,说明 role/content 消息结构、推理与训练参数、特殊 token 重复和不同模型模板不兼容时的处理方式。
-
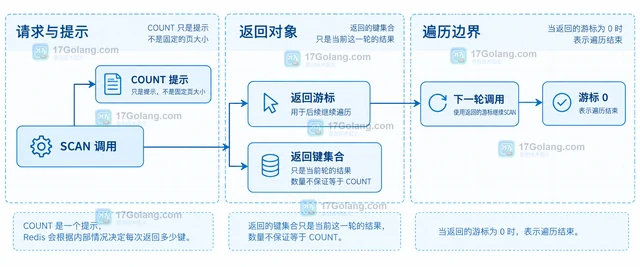
Redis SCAN 的 COUNT 只是遍历工作量提示,不保证每轮返回固定数量。本文解释游标结束条件、MATCH/TYPE 过滤、空批次与重复键,并给出 COUNT 的场景化选择方法。
-
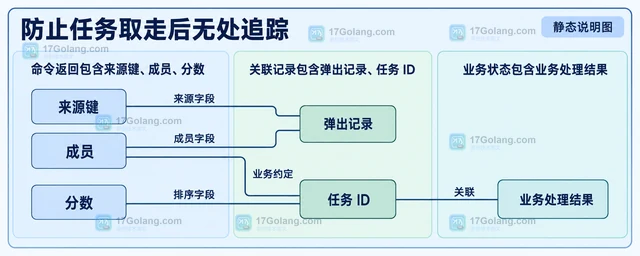
Redis BZPOPMIN 在集合为空时阻塞等待,有成员时弹出最低分项。本文说明超时秒数、多 key 的来源选择顺序,并用独立示例区分队列内最小值与全局最小值,提醒弹出后的任务恢复责任。
-
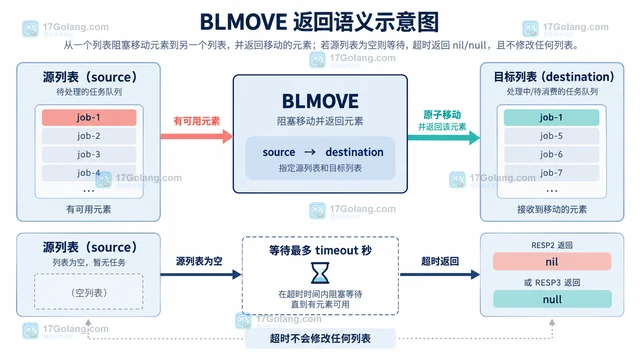
Redis BLMOVE 在源列表暂时没有元素时会阻塞,timeout 到期返回 nil 或 null,表示本次移动没有完成。本文说明如何用 EXISTS、TYPE、LLEN 观察源键,并处理补查时的并发竞态。
-
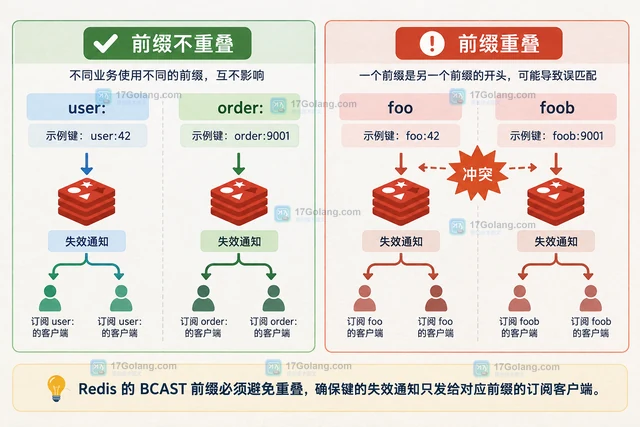
Redis 客户端缓存使用 BCAST 广播模式时,服务端按 PREFIX 广播键失效通知。本文讲清前缀配置、重叠限制和常见排查方法。
-
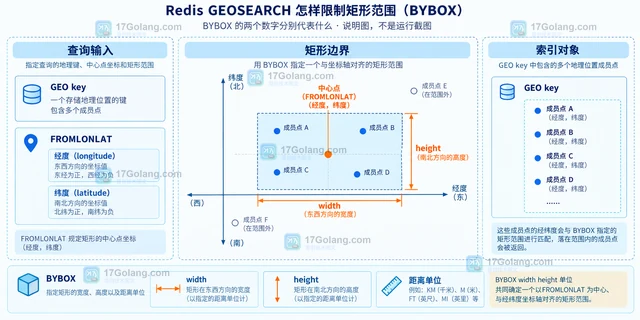
Redis GEOSEARCH 的 BYBOX 用中心点、宽度、高度和统一距离单位定义轴对齐矩形。本文说明 FROMLONLAT、FROMMEMBER、排序、COUNT、WITHDIST 与 BYRADIUS 的边界。
-
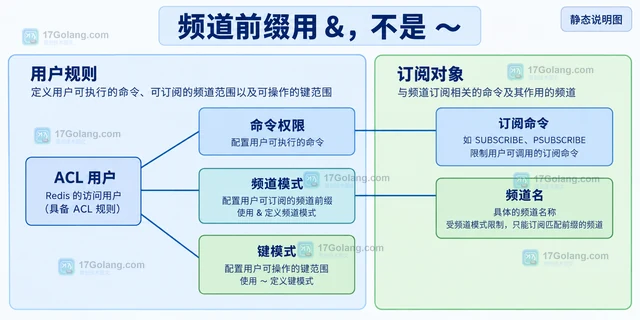
Redis ACL 用 &频道模式限制 Pub/Sub 范围,还需独立授予订阅命令。本文给出专用用户的最小配方,说明 PSUBSCRIBE 的字面匹配、旧宽权限残留及连接变更注意事项。
-
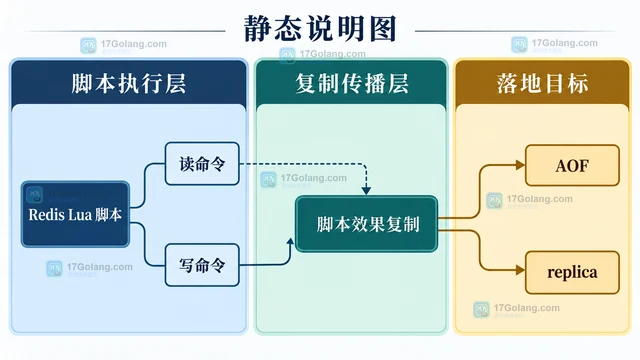
从脚本源码复制与脚本效果复制出发,解释 Redis Lua 写命令、AOF 和 replica 的传播边界,并给出可落地的确定性脚本写法。
