-
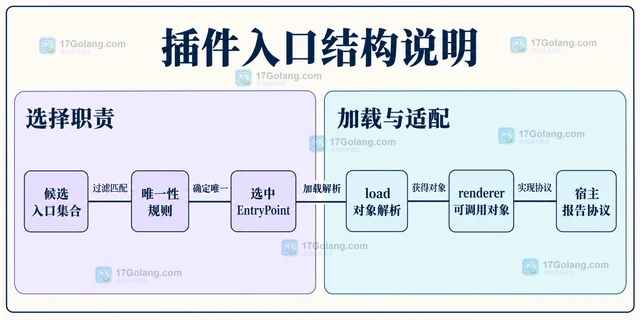
Python importlib.metadata.entry_points 可通过 group 选择插件入口,再按 name 精确筛选。本文以报告渲染器说明元数据发现、唯一候选加载、pyproject 声明,以及空结果、重名和接口错误的处理。
-
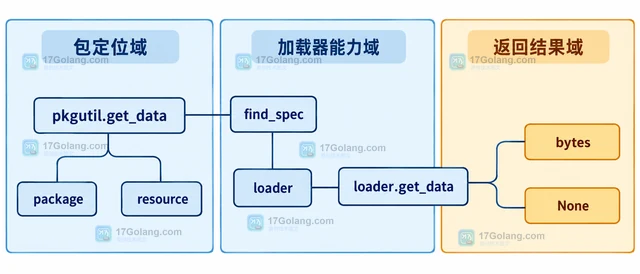
Python pkgutil.get_data 遇到不支持资源读取的加载器时返回 None,而不是空字节串。本文从包定位、loader.get_data 能力和命名空间包边界出发,说明如何处理 None,以及在不同打包方式下如何选择资源访问方案。
-
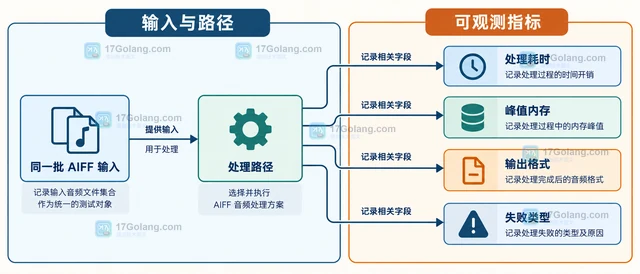
Python 3.13 起不再提供 aifc。需要读取 AIFF 并进入 NumPy 数组时选 soundfile,需要多格式转码时选 FFmpeg,需要短脚本剪切拼接时可用 pydub,但它仍依赖 FFmpeg。本文按任务边界、依赖、耗时和内存指标给出迁移选择。
-
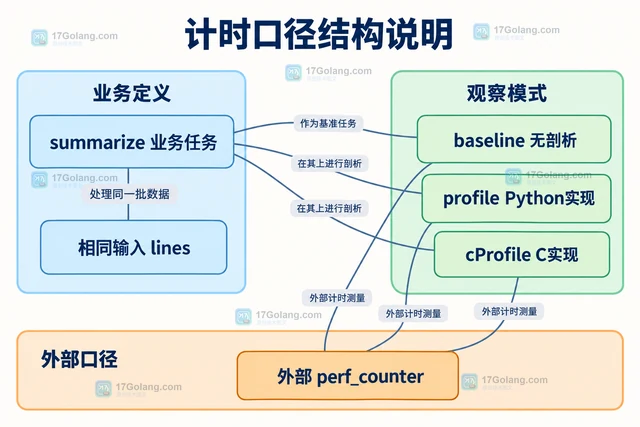
profile 的纯 Python 实现通常比 cProfile 带来更明显的剖析开销。本文以同一文本汇总任务解释外部耗时与报表统计的区别,提供三模式观察脚本和无剖析计时方法,不预设固定减速倍数。
-
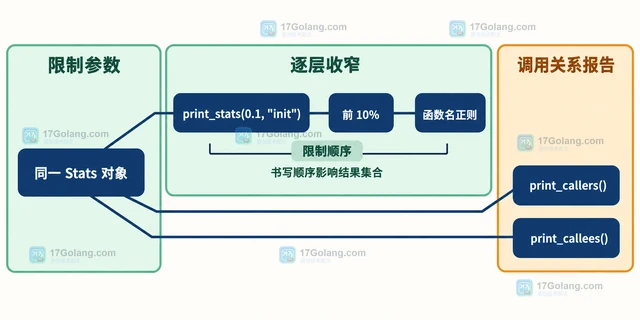
Python pstats 用 sort_stats() 决定性能报告的排序方式,再用 print_stats() 按数量、比例或函数名限制显示内容;多个限制会按书写顺序依次收窄。
-
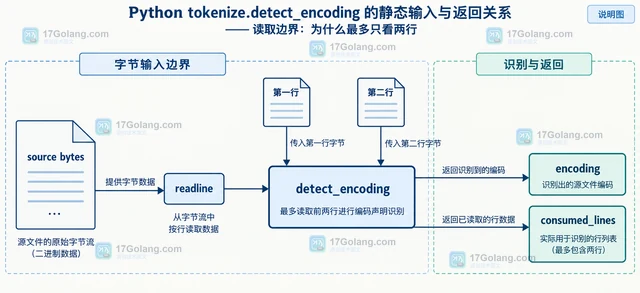
从字节流、前两行读取边界和 BOM/编码声明冲突三个角度,说明 Python tokenize.detect_encoding 如何识别源文件编码,并给出 tokenize.open 的使用边界。
-
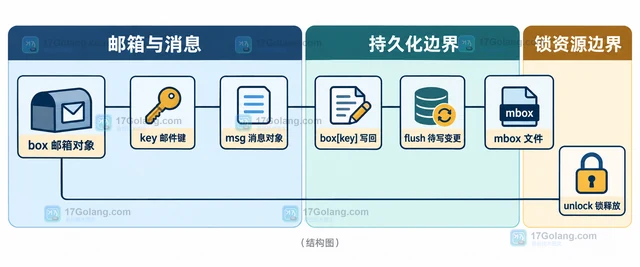
Python mailbox.mbox 修改后,flush 负责把待处理变更写入文件,unlock 负责释放排他锁,二者不是同一个动作。本文用一个带异常收尾的示例解释修改、落盘、解锁和 close 的关系。
-
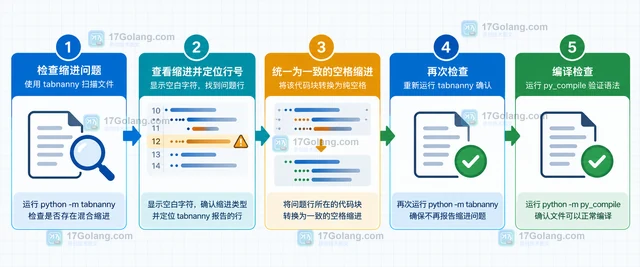
本文说明 Python tabnanny 如何扫描文件或目录中的混合缩进,解释 indent not equal 与 indent not greater 的区别,并给出显示空白、统一缩进和 py_compile 验证的完整排查流程。
-
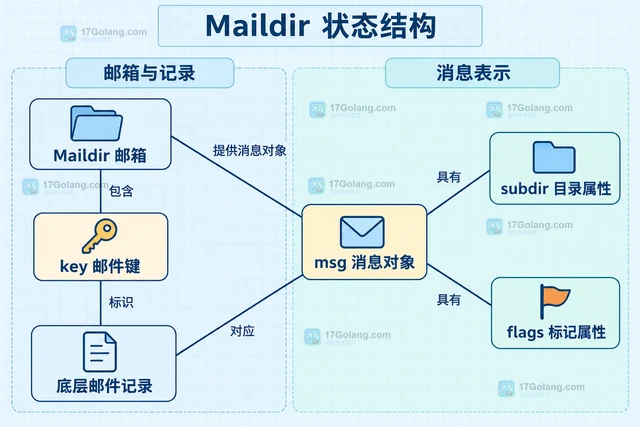
Python mailbox.Maildir 的 new/cur 目录位置与 S 已读标记应分开判断。本文给出只读扫描和单封标为已读的示例,解释 cur 未必已读、对象修改需写回,以及实验 info 和并发统计的限制。
-
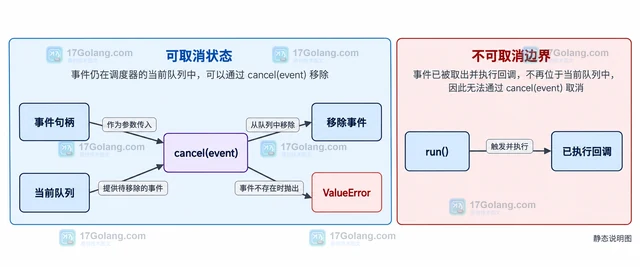
Python sched 取消尚未触发的定时事件,需要保存 scheduler.enter 或 enterabs 返回的事件对象,再交给同一个调度器的 cancel;事件不在队列时会抛出 ValueError。本文说明事件句柄、重复取消和业务任务映射的处理方式。
-
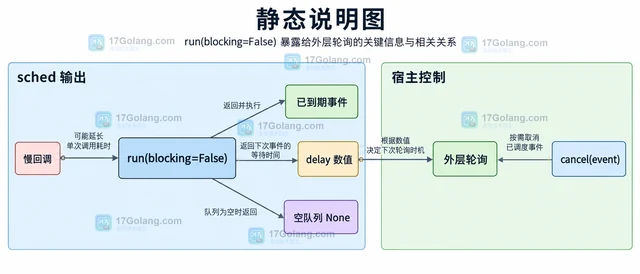
Python sched.scheduler 默认会在 run() 中等待下一个事件;改用 run(blocking=False) 后,它只处理已经到期的事件,并返回下个事件距离当前时钟的时间差。本文说明如何把这个返回值交给外层轮询,同时处理空队列、取消事件和慢回调。
-
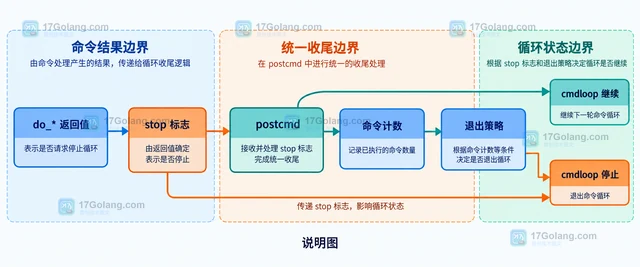
Python cmd.Cmd 的 precmd 在命令分发前改写输入,postcmd 在命令执行后接管 stop 标志。本文用一个最小命令解释器说明别名、计数和退出条件应该放在哪里。
-
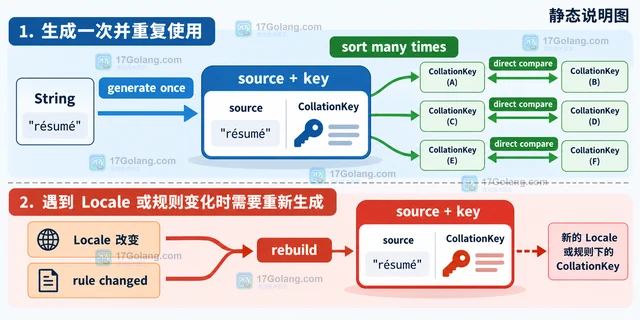
Java CollationKey 适合在同一批字符串需要反复排序时缓存比较键。本文给出绑定原文、固定 Collator 规则和缓存失效边界的写法,并说明何时直接 compare 更快。
-
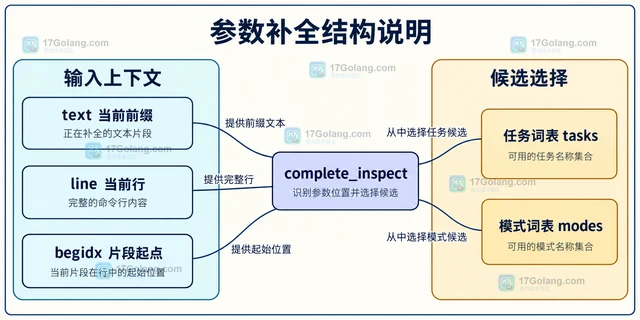
Python cmd.Cmd 可通过 complete_inspect 为指定命令提供参数候选。本文用只读任务控制台解释参数位置、空前缀、共享词表与执行判断,并说明 readline 环境和引号输入的限制。
-
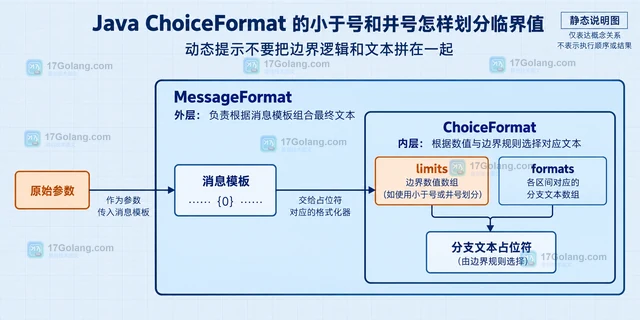
Java ChoiceFormat 中 # 包含当前下限,< 排除当前下限。本文用相邻区间、数组构造和 MessageFormat 示例说明如何处理 0、1、1 以上及其他临界值。
