-
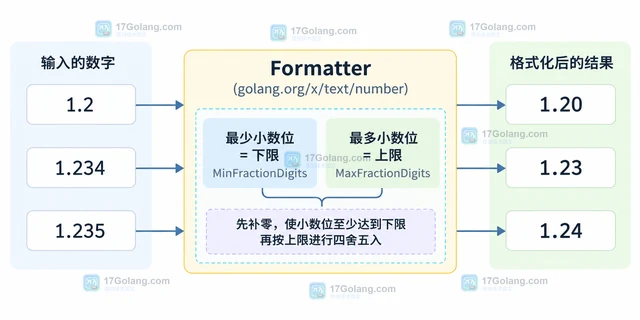
Go x/text/number 中 MinFractionDigits 控制小数位下限,MaxFractionDigits 控制上限。本文按排障手册说明两者何时配套、何时只设一侧,以及 Scale 固定精度的选择。
-
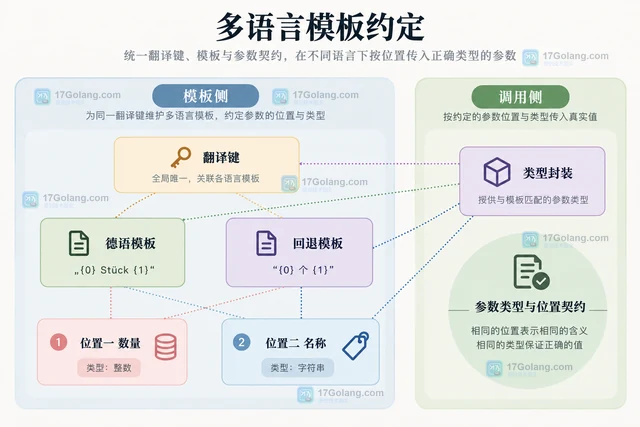
Go x/text/message 占位参数类型不匹配时,应检查实际翻译模板、参数索引和类型;通过类型封装与输入解析保持各语言模板约定一致。
-
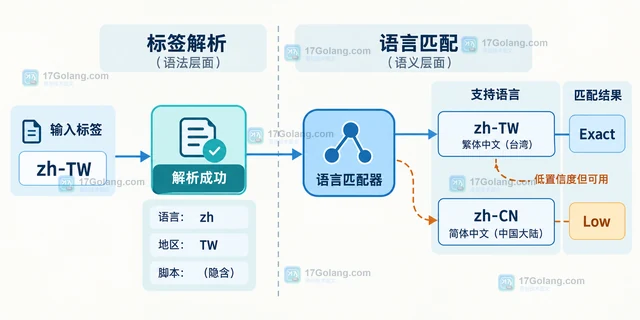
Go x/text/language 的 Low 表示匹配时从多个候选中选出较可能的结果,不等于 BCP 47 标签解析失败。本文区分 Parse、Matcher.Match、tag、index 和 Confidence,并给出 Low、No 与 error 的正确处理方式。
-
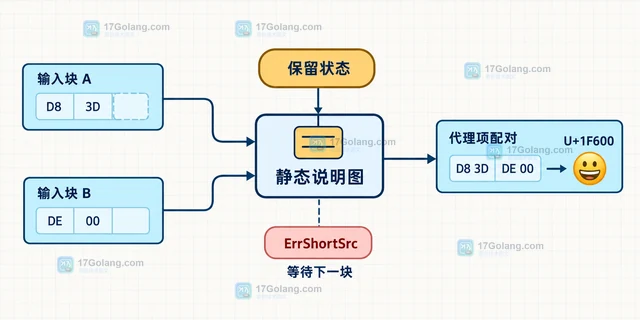
Go x/text/encoding/unicode 解码 UTF-16 时,代理项只是代码单元,必须由高代理项和低代理项配对才能还原补充平面字符。本文说明孤立代理项为何变成 U+FFFD,以及字节序、BOM 和流式 ErrShortSrc 的排查方法。
-
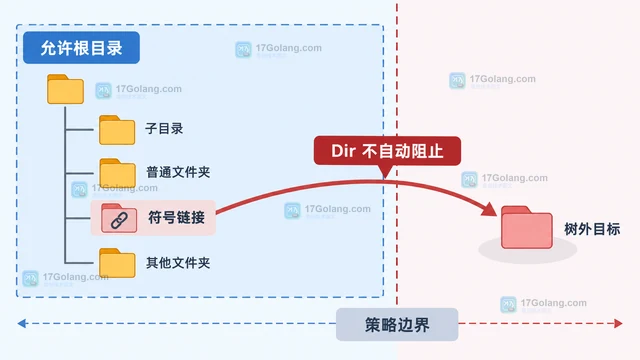
webdav.Dir 接收的是本机文件系统根目录,而 WebDAV FileSystem 方法接收的是用斜杠分隔的逻辑资源名。本文说明两种路径的边界,并提醒 Dir 不会自动阻止目录内符号链接指向树外。
-
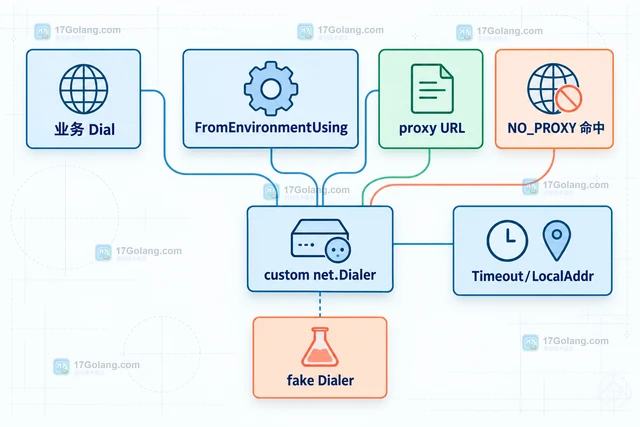
Go x/net/proxy.FromEnvironment 默认把 Direct 作为底层拨号器。本文拆开环境代理、NO_PROXY 与 forward 的关系,说明为什么需要 FromEnvironmentUsing 传入带超时、绑定参数或测试替身的备用拨号器。
-
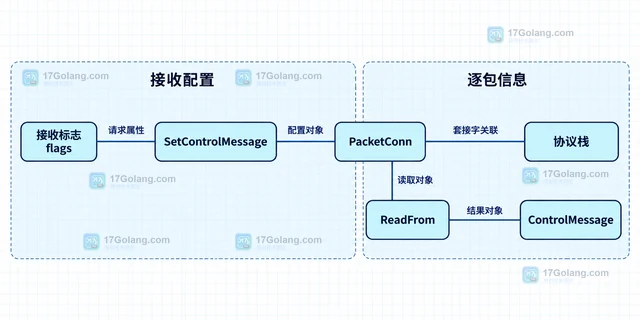
Go IPv6 控制消息需要先启用对应接收选项,再用 PacketConn.ReadFrom 取得逐包元数据。本文给出完整接收函数,区分配置与发送,并解释空值和平台限制。
-
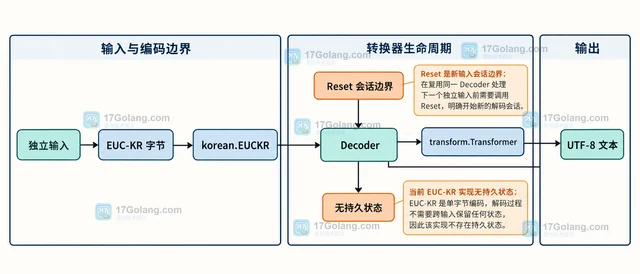
Go x/text/encoding/korean 的 Decoder 复用前为什么要 Reset?关键在于把 Reset 当作转换器生命周期边界,而不是把它误解成每次都能修复错误编码。当前 EUC-KR 解码器是无持久状态实现,但生产代码仍要隔离复用、Reader 生命周期和并发所有权。
-
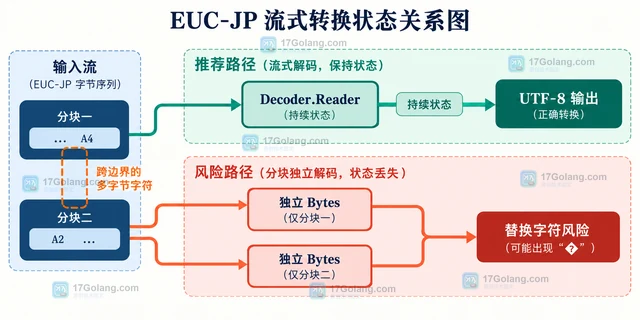
Go x/text/encoding/japanese 的 EUCJP 解码出现替换字符,通常不是 UTF-8 字符串本身坏了,而是源字节并非完整且正确的 EUC-JP。本文按输入编码、解码 API 和流式分块三个层面排查,并给出 Bytes 与 Reader 的用法。
-
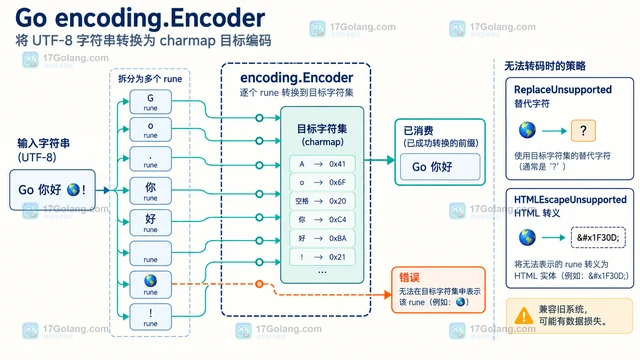
charmap 是 8-bit 字符集编码器,无法覆盖所有 Unicode rune。本文说明如何用 EncodeRune 判断单个字符,用 Encoder 识别整段转换的错误边界,并选择拒绝、替代或 HTML 转义策略。
-
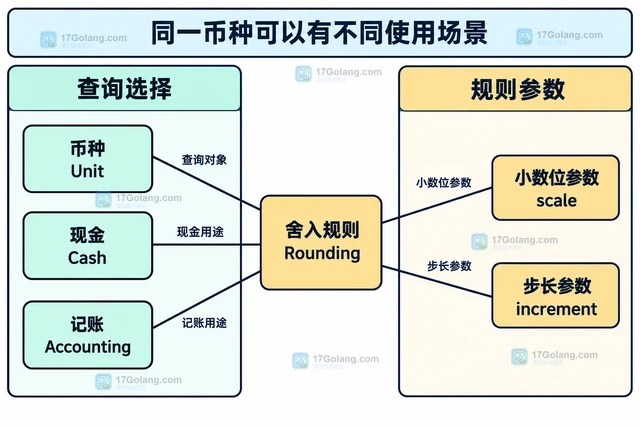
Go currency.Cash 与 Accounting 按用途选择舍入属性。本文说明 scale 和 increment 的区别,给出参数查询代码,并区分规则记录、格式化展示和实际金额计算。
-
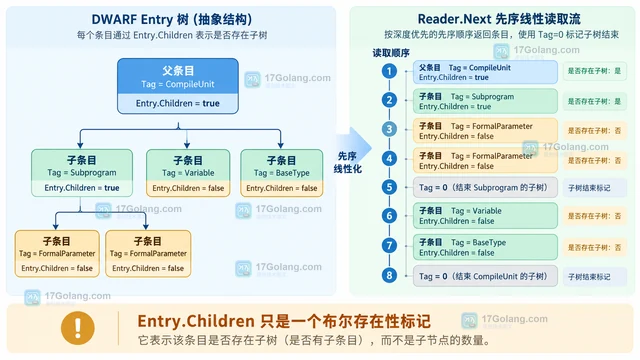
Go debug/dwarf 的 Entry.Children 只表示当前条目后面是否跟着子条目,并不保存子节点数量。本文结合 Reader.Next 的先序读取和 Tag 0 结束标记,说明如何统计层级、跳过子树以及避免误读。
-
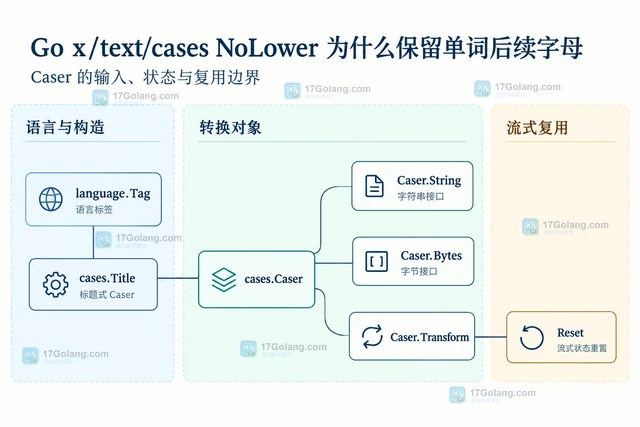
Go x/text/cases 的 NoLower 会关闭标题式大小写中非首字母的小写化,因此输入中的后续字母可以保留。本文对比默认 Title、NoLower、语言标签和 Caser 复用边界。
-
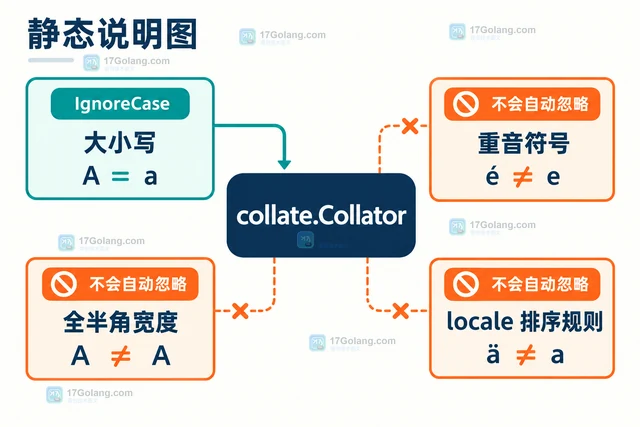
Go x/text/collate 的 IgnoreCase 只负责大小写比较权重,不会自动忽略重音、全半角、语言规则或数值差异。本文用 CompareString、Option 组合和检查表说明如何选择。
-
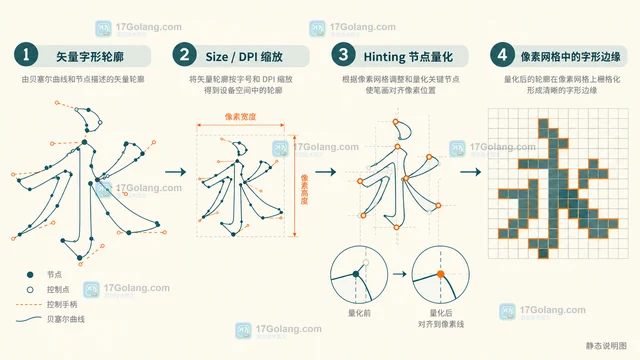
Go x/image/font/opentype 的 Hinting 会影响矢量字形节点如何落到像素网格。本文对照 HintingNone、HintingVertical 和 HintingFull,说明小字号变形的原因与排查顺序。
