-
Go x/net/ipv4.PacketConn 将数据载荷、ControlMessage 与源地址分层返回。本文从 ReadFrom 和 WriteTo 的接口边界解释原因,并给出控制字段配置、接口选择和跨平台排查方法。
-
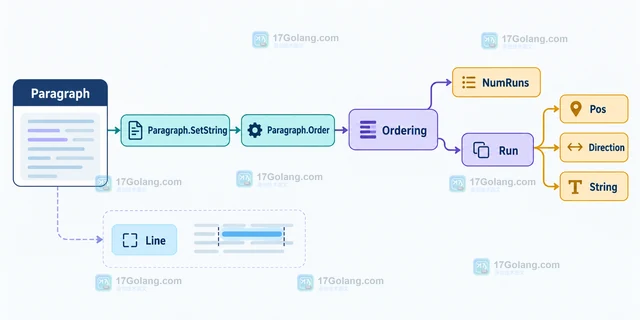
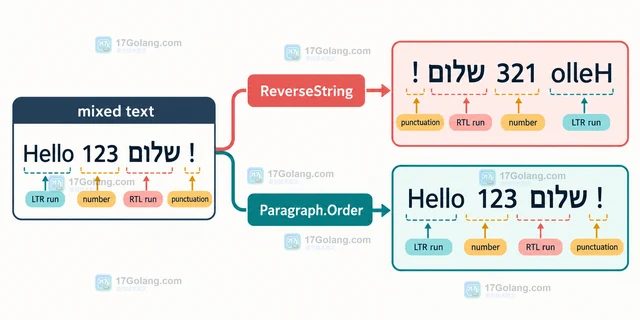
Go x/text/unicode/bidi 处理的是双向文本的段落与视觉 runs,不是把右向字符串从头到尾反过来。本文用混合文本说明 ReverseString 的边界,并给出 Paragraph.Order 与 Line 的排查写法。
-
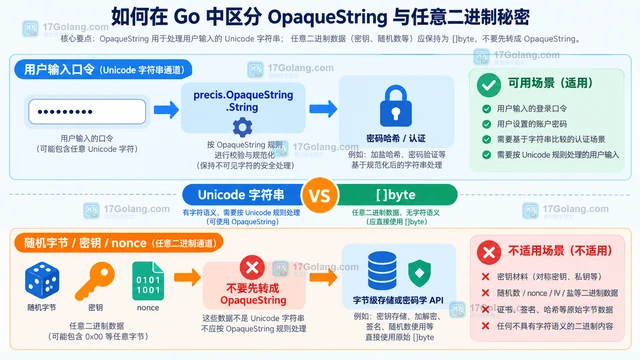
解释 Go x/text/secure/precis 的 OpaqueString 为什么面向 Unicode 口令字符串,而不是任意二进制秘密,并给出 Go 中的选型和错误处理方式。
-
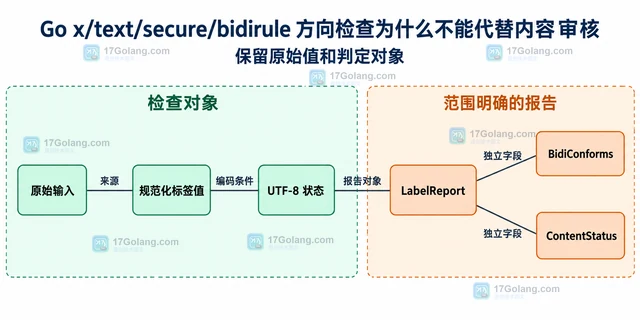
Go bidirule 检查 RFC 5893 方向规则,不判断文本语义或发布许可。本文给出独立检查报告示例,说明字段适用范围、状态设计和方向规则与内容策略的分工。
-
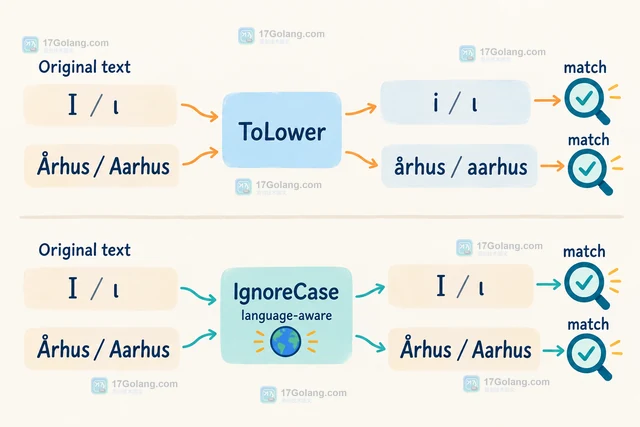
Go x/text/search 的 IgnoreCase 不是简单把两边字符串转成小写,而是保留原文并按语言规则完成大小写不敏感匹配。本文从一个小型搜索工具出发,说明它与 ToLower、Loose、Exact 的区别。
-
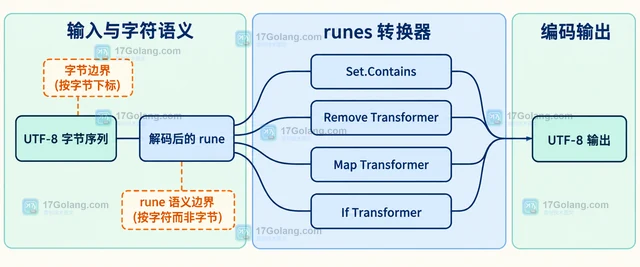
Go x/text/runes 处理的是 UTF-8 文本中的 rune,不是可以直接按字节下标切开的字符。本文从 Remove、Map、If 和 transform.String 的关系出发,说明字节索引、分块读取与非法 UTF-8 的边界。
-
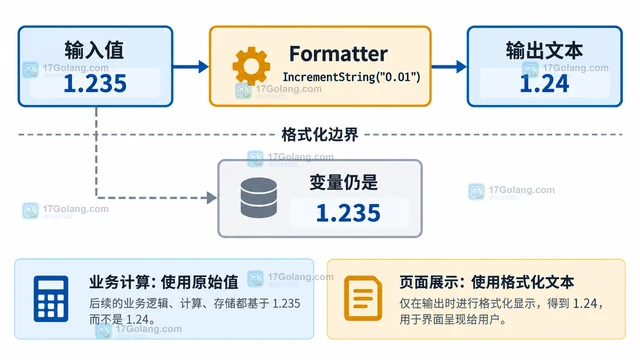
Go x/text/number 的 Scale 和 IncrementString 只改变数字的格式化结果,不会回写原始变量。本文用对照示例说明显示舍入、业务计算和输出边界应该怎样分开。
-
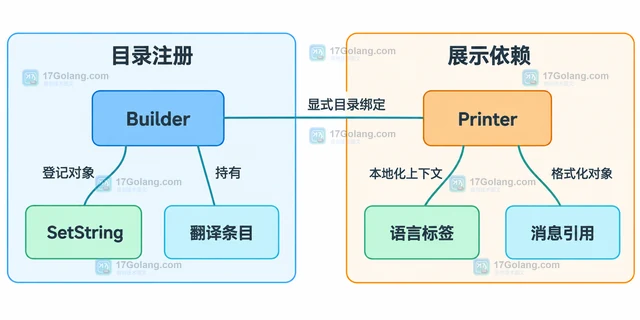
Go x/text/message 在缺少翻译时会格式化原文或备用文案。本文用独立目录示例说明 message.Key、目录绑定和语言选择,并比较原文键与稳定消息标识的维护方式。
-
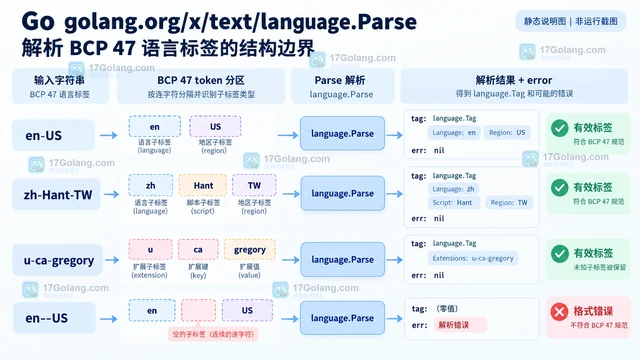
Go x/text/language.Parse 解析的是 BCP 47 语言标签,不是任意文本清洗器。本文区分格式错误、未知值和部分解析结果,说明 Parse、Make、MustParse 与 ParseAcceptLanguage 的选择边界。
-
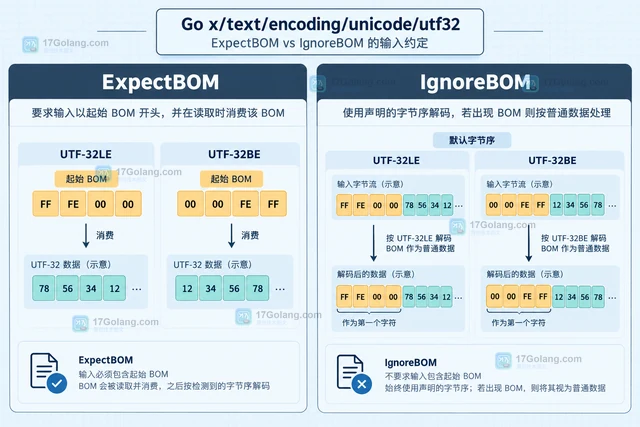
解释 Go x/text/encoding/unicode/utf32 中 ExpectBOM 与 IgnoreBOM 的解码、编码差异,给出缺失 BOM、字节序和 U+FEFF 输出的处理方法。
-
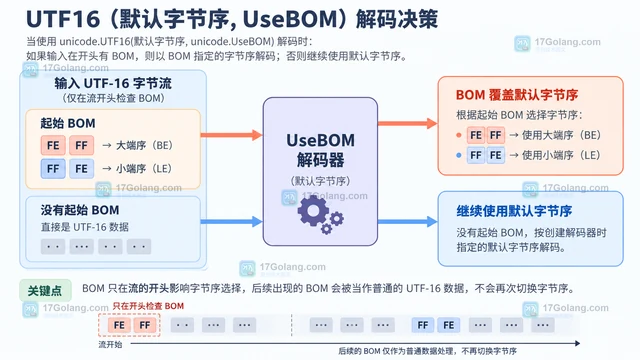
Go x/text/encoding/unicode 的 UseBOM 会在 UTF-16 输入带起始 BOM 时覆盖默认字节序,无 BOM 时再回退到默认值。本文用示例区分 UseBOM、ExpectBOM 和 IgnoreBOM。
-
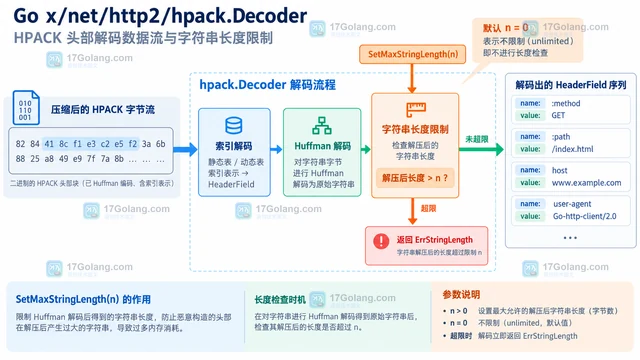
Go x/net/http2/hpack.Decoder 的输入是压缩后的 HPACK 头部块,解压后的名称和值可能更长。本文说明 SetMaxStringLength 的限制对象、ErrStringLength 的处理方式,以及增量 Write 与 Close 的生命周期边界。
-
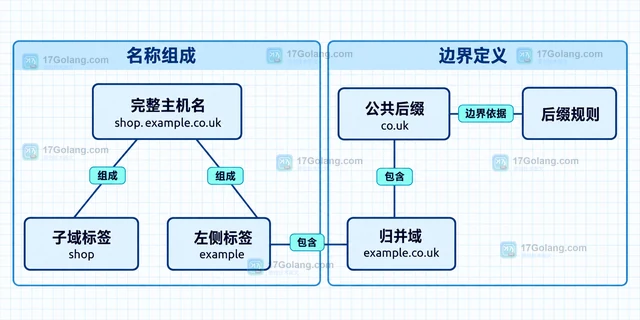
Go EffectiveTLDPlusOne 需要公共后缀左侧再有一个标签。本文解释后缀本身被拒绝的原因,给出区分结果与错误的代码,并说明归并记录与规则快照的保存方式。
-
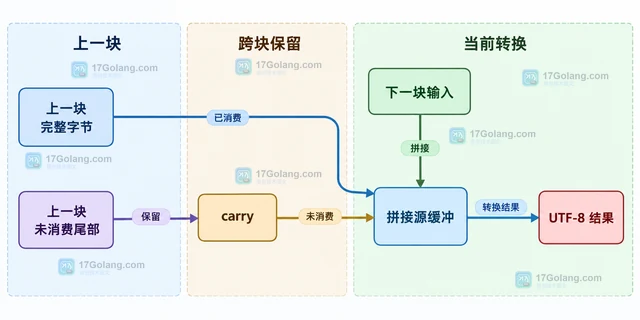
Go 使用 x/text/encoding/korean 解码 EUC-KR 分块数据时,Transform 返回的 nSrc 与 ErrShortSrc 决定了哪些字节必须带到下一块。本文结合 Decoder.Reader 和手动分块处理说明如何避免字符被截断。
-
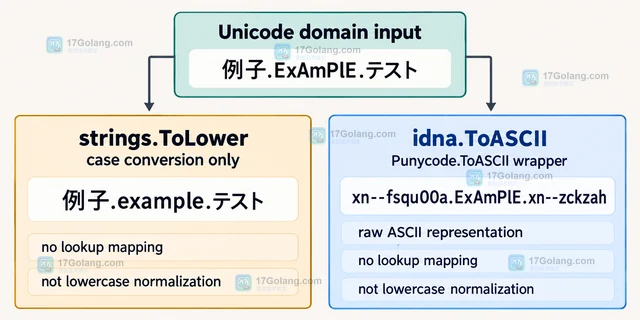
Go x/net/idna.ToASCII 不是简单的字符串转小写,而是原始 Punycode 编码入口。本文区分 ToASCII、Lookup.ToASCII 与 Registration.ToASCII 的用途,说明域名查找映射和注册校验应该怎样选择。
