-

HAVING和WHERE的区别在于作用时机和场景:1.WHERE在分组前筛选行,用于过滤原始数据,如筛选工资>5000的员工;2.HAVING在分组后筛选结果,用于过滤聚合结果,如保留员工数>5的部门;3.两者可同时使用,如先筛选工资>5000的员工,再保留平均工资>8000的部门;4.不能在WHERE中使用聚合函数,因为其逐行判断,而聚合计算需基于一组行。
-

数据分片的核心目的是提升数据库读写性能和存储扩展能力。其通过将大表数据分散到多个物理节点实现,常见方式包括应用层逻辑分片、使用中间件做透明分片或数据库引擎的分区功能(注意分区不是分片)。一、水平分片是按行分开放置在不同实例中,例如根据用户ID奇偶划分;优点是简单易懂,缺点是扩容麻烦且易数据倾斜,建议选好分片键避免跨库查询。二、常见分片方案有三种:1.应用层逻辑分片由代码控制路由,灵活但维护成本高;2.使用分片中间件如MyCAT、ShardingSphere实现透明分片,适合中大型项目但增加运维复杂度;3.
-
LPUSH+BRPOP构成FIFO阻塞队列,兼容Redis2.0+;但消费失败会导致消息丢失,适合允许少量丢失的场景,强可靠性需求应改用Stream。
-
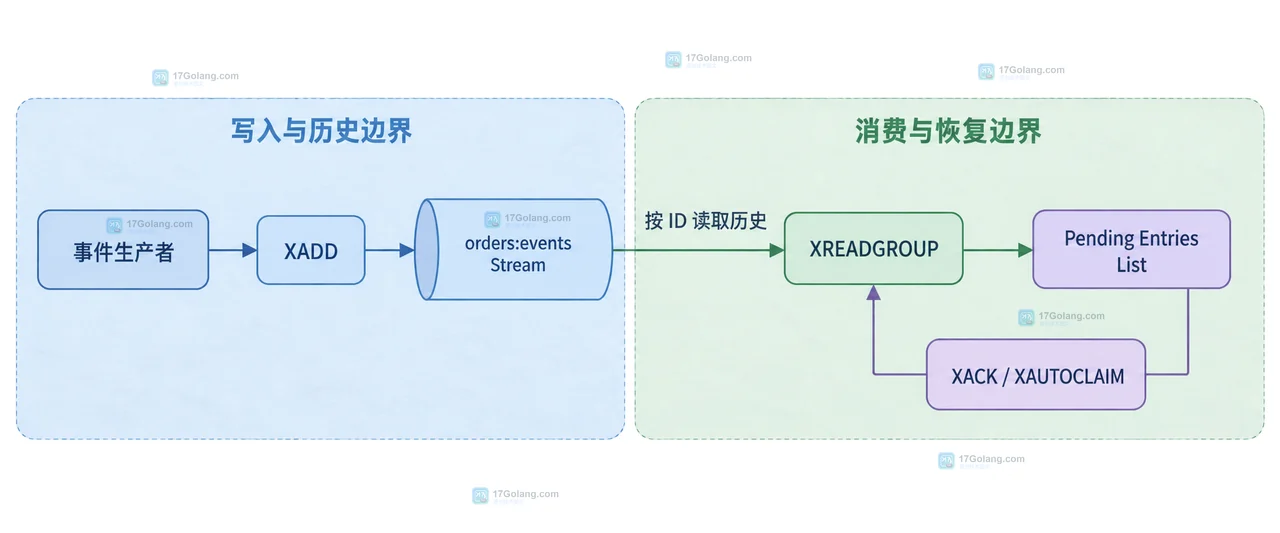
Redis Pub/Sub 采用至多一次投递,订阅端断线期间消息不会保留。本文用最小命令和排查表说明何时继续用 Pub/Sub,何时切换 Streams 或采用混合方案。
-
Redis LATENCY DOCTOR 只分析实例内部延迟事件,业务接口耗时还包含网络、连接池、序列化和下游调用。本文用 LATEST、HISTORY、慢日志与应用指标对齐排查,并说明 LATENCY RESET 的证据风险。
-
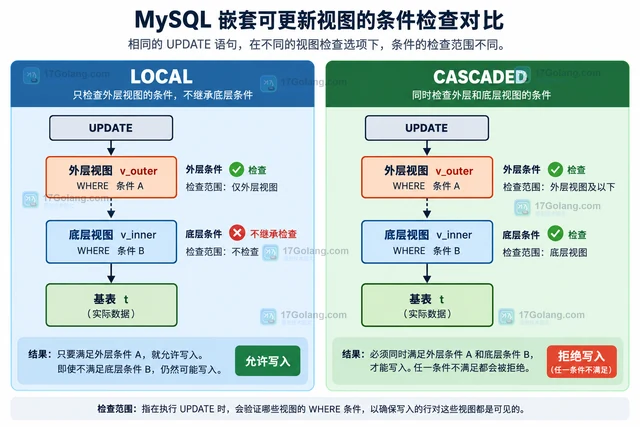
MySQL 嵌套可更新视图中的 LOCAL 与 CASCADED 决定写入检查范围。本文用订单视图对比两者在内层无约束、内层已有约束和 UPDATE 场景下的差异,帮助你选择合适的视图写入边界。
-
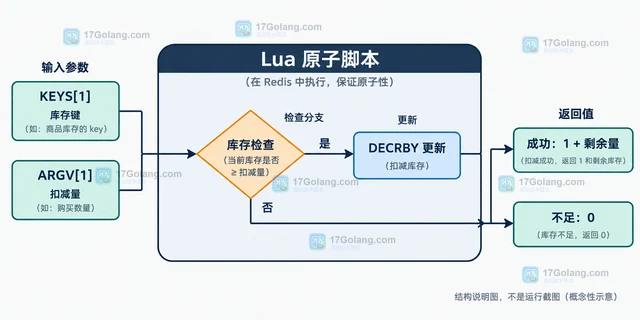
从客户端 GET、判断、DECRBY 的竞态出发,说明 Redis Lua 如何把检查与更新放入同一次原子执行,并给出 KEYS、ARGV、EVALSHA、NOSCRIPT 和脚本长度的迁移清单。
-
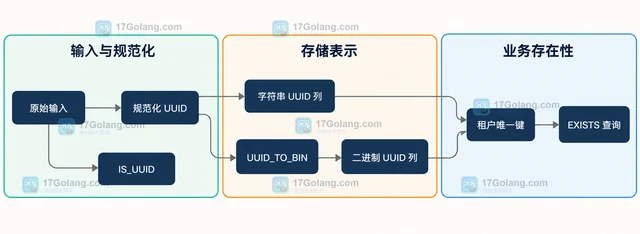
MySQL IS_UUID 返回 1 只说明输入符合可解析的 UUID 字符串格式,不代表业务表中存在对应记录。本文从故障影响、触发条件和根因出发,拆开格式校验、规范化、UUID_TO_BIN 与业务存在性查询的边界。
-
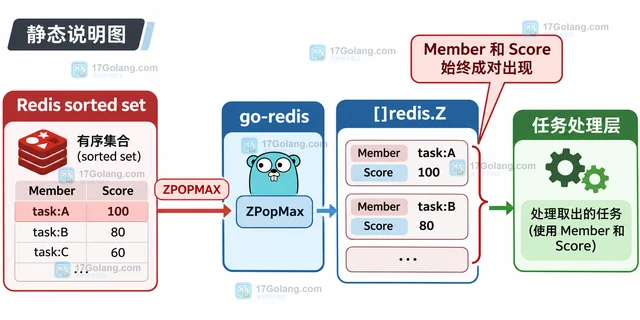
Redis ZPOPMAX 会从有序集合中取出并删除最高分成员,适合把 sorted set 当作优先级队列。本文说明 key、count、批量返回顺序、Go 客户端读取和业务确认边界。
-
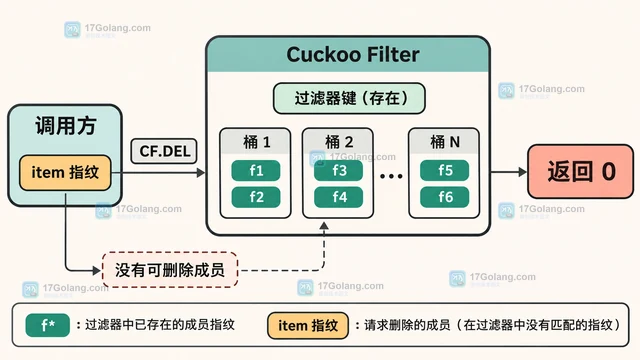
Redis Cuckoo Filter 的 CF.DEL 返回 0,通常表示过滤器中没有找到可删除的成员,而不是命令异常。本文解释删除一次、重复添加后的逐次删除、CF.EXISTS 的边界,以及 WRONGTYPE、参数错误和连接错误的区别。
-
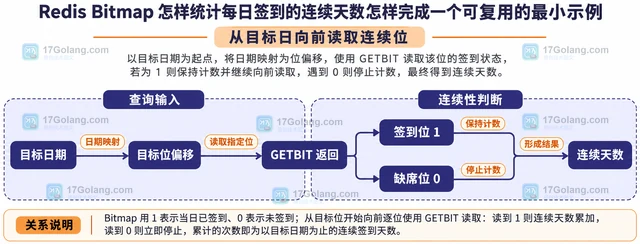
用 Redis Bitmap 按自然日记录签到状态,再在业务时区下从目标日向前读取连续的 1,得到可复用的连续签到天数查询。本文覆盖键设计、Go 示例、幂等签到、跨月边界、补签规则和适用范围。
-
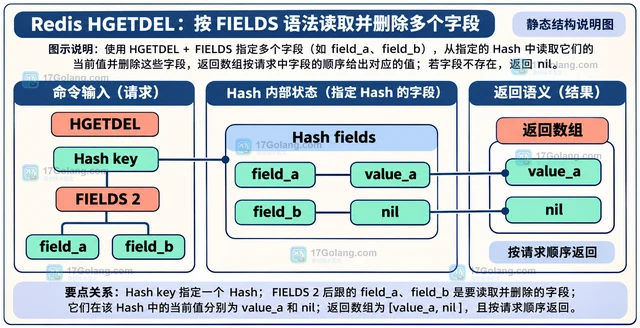
Redis HGETDEL 用一条命令读取并删除 Hash 中的一个或多个字段,适合消费后回收、一次性领取和取出即清理场景。本文说明 FIELDS 语法、返回顺序、缺失字段、最后字段删除以及与 HDEL 的选择边界。
-
在一些网络服务的系统中,Redis 的性能,可能是比 MySQL 等硬盘数据库的性能更重要的课题。比如微博,把热点微博[1],最新的用户关系,都存储在 Redis 中,大量的查询击中 Redis,而不走 My
-

一、摘要实际的软件项目开发过程中,不可避免的需要用到关系型数据库,比较主流的关系型数据库有 mysql、oracle、sql server、postgresql、db2 等等,当然目前最主流的数据库非 mysql 莫属,相比其
-

mysql的数据类型:数值型、日期/时间、字符串类型 安装mysql:http://down.cuohei.com/ tinyint:小整数,数据类型用于保存一些范围的整数数值范围,MySQL中无布尔值,使用tinyint(1)构造
