-
MySQL实现读写分离的核心逻辑是将写操作(INSERT、UPDATE、DELETE)发到主库,读操作(SELECT)分散到从库。其原理基于主从复制机制,主库处理写请求并将数据变更同步至从库,应用层或中间件负责路由请求;实现方式主要有两种:一是手动编码控制,适合小项目,如通过MyBatis拦截器切换数据源;二是使用中间件自动分流,适合中大型项目,可统一处理连接池、负载均衡、故障转移等问题;常用的中间件包括MyCat、ShardingSphere、MaxScale和ProxySQL,各自具备不同特点和适用场
-
根本原因是Redis集群要求多键操作的key必须位于同一slot,而HashTag(如{user:1}:profile)通过仅哈希花括号内内容实现强制同槽,但需命令本身支持多key且全链路保留括号语义。
-
PSUBSCRIBE性能瓶颈源于PUBLISH时线性遍历所有pattern做glob匹配。无索引、无缓存、无短路,pattern越多越慢;大小写敏感且*不匹配空字符串,易误配;超20个pattern或100qps即引发CPU毛刺。
-
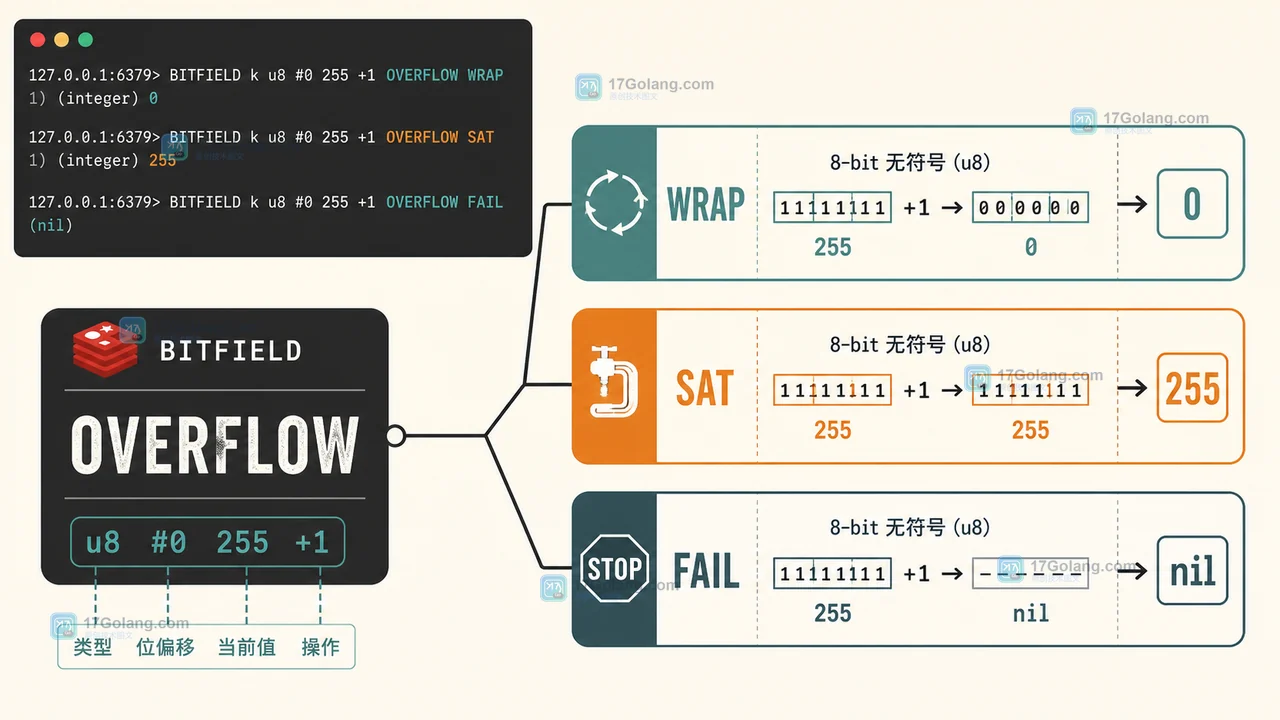
Redis BITFIELD 适合把多个小整数压进一个字符串,但积分计数一旦选错位宽或溢出策略,结果可能悄悄回绕。本文用积分桶示例拆开 GET、INCRBY、OVERFLOW 的边界,并给出可重复的验收命令。
-
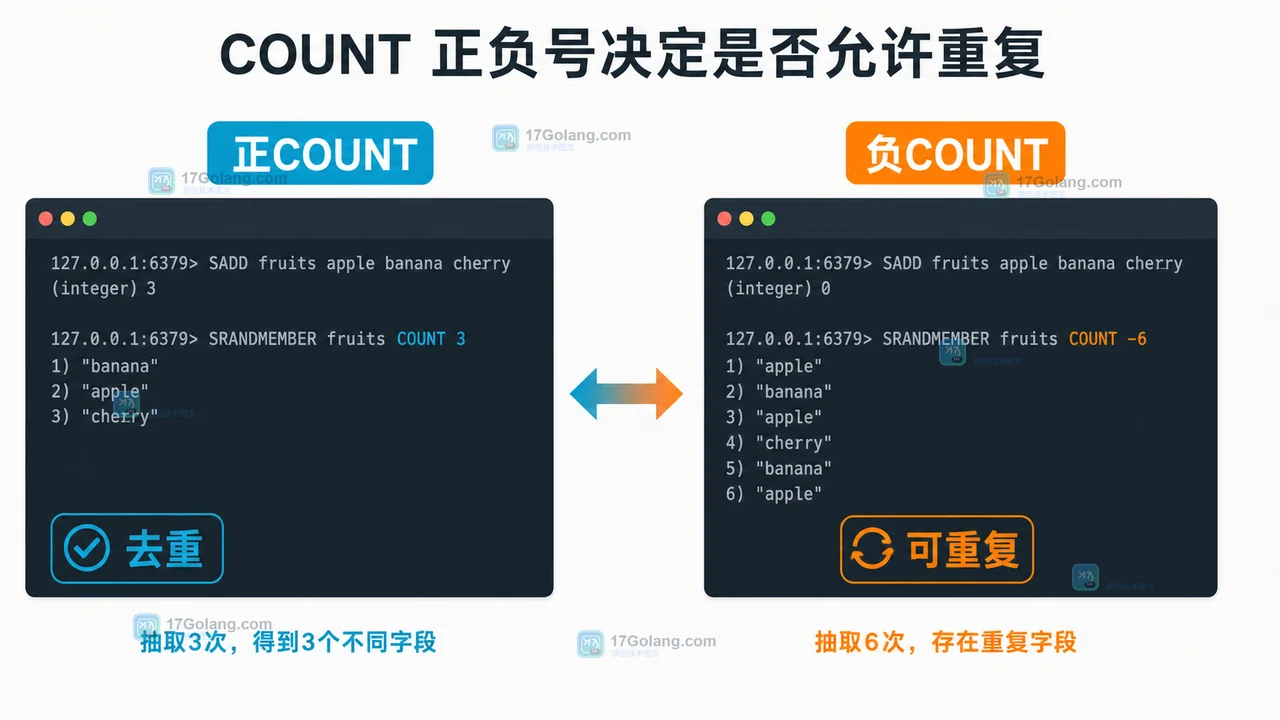
Redis HRANDFIELD 适合从 Hash 中抽取随机字段。本文用 redis-cli 核对单字段、COUNT、WITHVALUES、负数 COUNT、空键和重复结果,避免把随机读取误当成去重抽样。
-
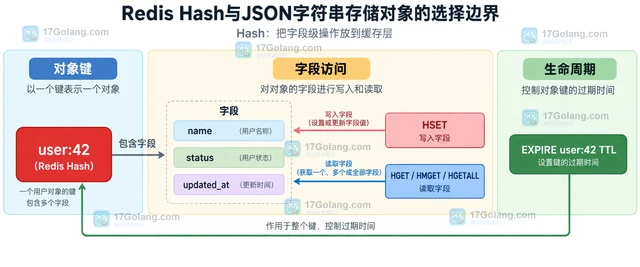
Redis Hash适合字段级读取和局部更新,JSON字符串适合整对象缓存;如果必须按JSONPath原子修改文档,再评估RedisJSON。本文用Go示例梳理三种方式的边界、过期策略和并发取舍。
-
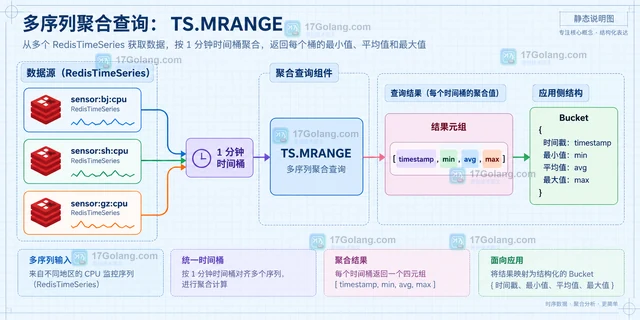
RedisTimeSeries 的 TS.MRANGE 可以在一次查询中用 AGGREGATION min,avg,max 返回同一时间桶的多个统计值。本文说明返回元组的字段顺序、应用侧映射方式,以及它与 GROUPBY/REDUCE 跨序列归并不能叠加的边界。
-

前言
每次利用终端 创建数据库或者创建表的时候,字符集都是latin1,或者进行插入值的时候,显示的是乱码(不指定字符集的时候)如下:
查看当前数据库的字符集
character_set_client:客户端
-

时光在不经意间,总是过得出奇的快。小暑已过,进入中暑,太阳更加热烈的绽放着ta的光芒,...在外面被太阳照顾的人们啊,你们都是勤劳与可爱的人啊。在房子里已各种姿势看我这篇这章的
-

为方便维护MySQL,写了个脚本用以提供收集错误信息的接口。这些错误信息来自与MySQL错误日志,而 通过grep mysql可以获取error-log的路径。
以下是全部相关代码:
#!/usr/bin/env python2.7
#-*- encoding: u
-
集成方式
使用Jedis
Jedis是Redis官方推荐的面向Java的操作Redis的客户端,是对服务端直连后进行操作。如果直接使用Jedis进行连接,多线程环境下是非线程安全的,正式生产环境一般使用连接池进
-
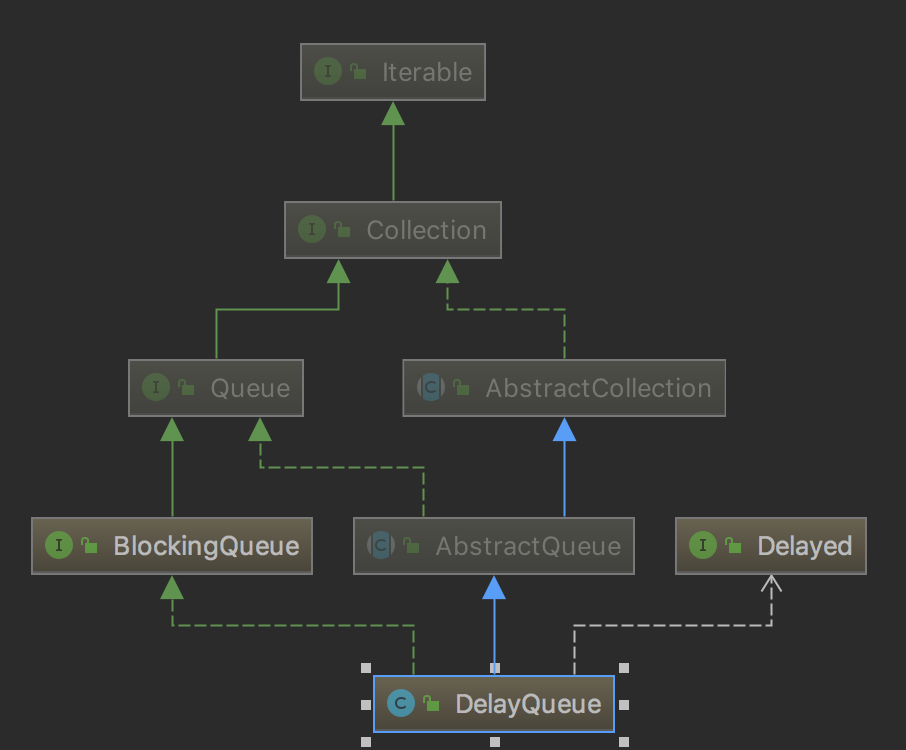
最近,又重新学习了下Redis,Redis不仅能快还能慢,简直利器,今天就为大家介绍一下Redis延迟队列和分布式延迟队列的简单实现。
在我们的工作中,很多地
-

通过本系统的了解和使用,可以快速的进行业务开发,大大提高开发效率。实际开发中有很多的业务代码是重复性的,其原理是相同的,只是不同的业务表会存在具体数据的不同,RDS快速开发系
-

未建立索引EXPLAIN SELECT * FROM class LEFT JOIN book ON class.card=book.card;在左表建立索引ALTER TABLE `class` ADD INDEX Y(`card`);LEFT JOIN 条件用于确定如何从右表中查找匹配行,左表的数据会全部显示。在右表建立
-

实验环境ES版本:5.3.0spring bt版本:1.5.9首先当然需要安装好elastic search环境,最好再安装上可视化插件 elasticsearch-head来便于我们直观地查看数据。Spring工程创建这部分没有特殊要交代的,但有几
