-
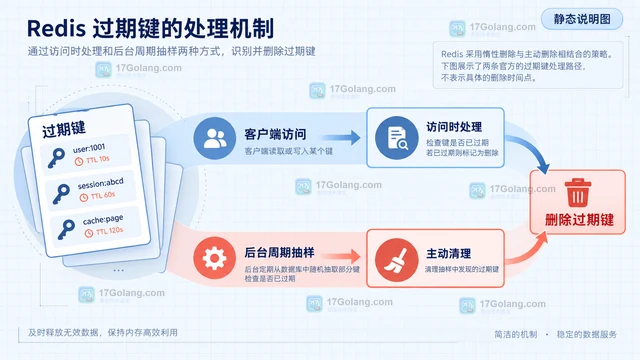
Redis 过期键并不是只靠一个定时器逐个删除:客户端访问到已过期键时会触发访问时处理,后台也会周期性抽样清理。本文用 TTL 的正数、-1、-2 返回值建立排查顺序,并说明主动过期、访问时删除和时间精度的边界。
-
通过redis-cli、RedisInsight、Prometheus和Grafana等工具,以及关注内存使用率、连接数、集群节点状态、数据一致性和性能指标,可以有效监控Redis集群的健康状态。
-
最佳实践是使用Docker部署Redis时,应注意数据持久化、配置管理、网络配置和性能优化。1.使用Docker命令启动Redis容器:dockerrun--namemy-redis-p6379:6379-dredis。2.配置数据持久化:dockerrun--namemy-redis-p6379:6379-v/path/to/host/data:/data-dredis。3.定制Redis配置:dockerrun--namemy-redis-p6379:6379-v/path/to/host/conf/
-
搭建Redis主从复制集群的步骤包括:1.配置主服务器和从服务器,2.实现读写分离,3.配置级联复制,4.优化和维护。通过这些步骤,可以实现数据的高可用性和读写分离,提升系统性能。
-
连接Redis客户端有四种常见方式,分别是直接TCP连接、使用Redis客户端库、使用连接池、以及使用RedisSentinel或Cluster。1.直接TCP连接简单高效但需手动管理连接,适用于简单场景;2.使用Redis客户端库封装了底层细节,提供高级API和自动管理功能,提升开发效率;3.使用连接池可复用连接,提升性能并控制资源消耗,适合高并发应用;4.使用RedisSentinel或Cluster支持高可用和分布式架构,实现自动故障转移与负载均衡。选择应根据应用复杂度、性能需求和是否需要高可用性综
-

Redis是一个开源的使用ANSI C语言编写、支持网络、可基于内存亦可持久化的日志型、Key-Value数据库,并提供多种语言的API。近期,Redis被爆出存在通过主从复制从而Getshell的漏洞。
在Redis4.x
-

Redis基本数据类型Set常用操作
Set是String类型的无序集合。集合成员是唯一的,这就意味着集合中不能出现重复的数据。
另外,redis中的set是通过哈希表实现的,所以添加,删除,查找的复杂度都
-
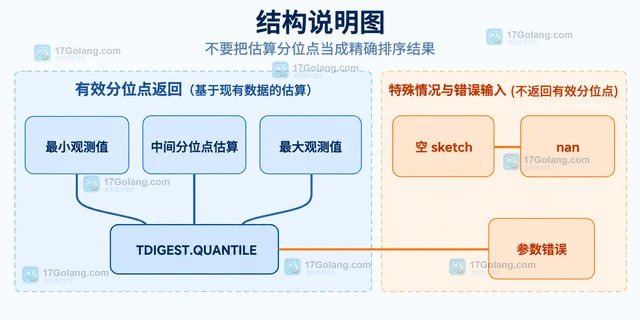
Redis TDIGEST.QUANTILE 可以在一次命令中传入多个 0 到 1 的分位点,并按输入顺序返回对应的浮点估算值。本文说明批量查询写法、返回数组对齐规则、0 和 1 的边界含义,以及空 sketch 和非法参数的处理方式。
-
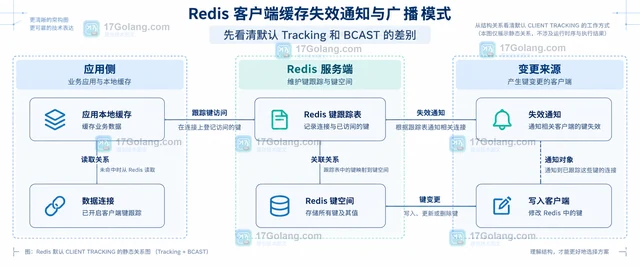
Redis 客户端缓存要解决的不是如何保存本地副本,而是数据变化后如何可靠地让副本失效。本文对比默认 Tracking 与 BCAST 广播模式,给出 RESP3 单连接、RESP2 REDIRECT 双连接、前缀范围和断线处理的落地选择。
-
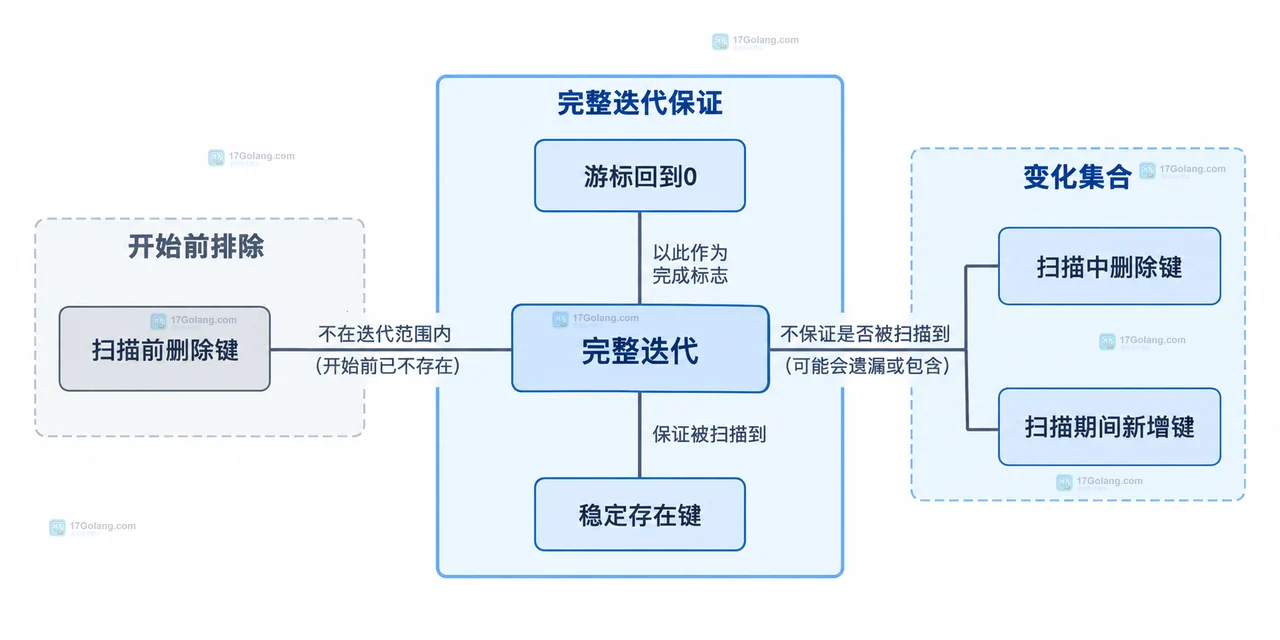
Redis SCAN 不是并发安全的静态快照:从扫描开始到结束始终存在的键会被完整迭代返回,但扫描期间被删除、新增或重新加入的键可能返回也可能不返回。本文给出重复返回、COUNT、UNLINK 和二次复查的处理方式。
-
必须同时排除RedisAutoConfiguration和RedisRepositoriesAutoConfiguration,否则因后者依赖redisTemplate而启动失败;exclude参数需传入Class数组,配置文件中须正确书写全限定名并避免缩进错误,且需清理残留Redis属性和手动Bean。
-

RedisPub/Sub超时主因是TCP连接中断或服务端阻塞,需独立配置订阅连接、启用tcp-keepalive、禁用中间设备断连,并监控blocked_clients与slowlog。
-
开启和查看Redis的安全审计日志需要编辑redis.conf文件,将appendonly设置为yes,并定义日志文件名。查看日志可通过读取AOF文件。1.编辑redis.conf,设置appendonlyyes和appendfilename。2.使用catappendonly.aof查看日志。定期管理AOF文件并确保其安全性是必要的。
-
解决Redis启动时内存分配不足问题的方法包括:1.检查系统内存使用情况,必要时增加物理内存或调整Redis配置;2.修改redis.conf文件中的maxmemory参数,限制Redis内存使用;3.配置maxmemory-policy参数,选择合适的内存回收策略;4.增加swap空间或禁用Redis的swap使用;5.通过RedisCluster分散数据存储,降低单节点内存压力;6.使用MEMORYUSAGE命令查找并处理大key。
-
Redis和Kafka可以集成使用,发挥各自优势。1.用户行为数据先存储在Redis中,确保实时性。2.通过定时任务或触发器将数据推送到Kafka,保证数据的顺序和可靠性。3.后端系统从Kafka消费数据进行实时分析和处理,实现高效的消息队列系统。
