
Python zipfile 怎样读取压缩包目录而不解压
来源:17golang原创
时间:2026-11-08 03:13:11 423浏览 收藏
如果只想确认 ZIP 里有哪些文件、目录层级和大小,不需要先把整个压缩包解到磁盘。Python 标准库的 zipfile 可以打开归档并读取中央目录:用 namelist() 拿到成员名称,用 infolist() 拿到更完整的 ZipInfo 元数据;只有调用 read() 或 extractall() 等操作时,才进入文件内容读取或解压阶段。
官方文档:https://docs.python.org/3/library/zipfile.html
读取压缩包目录的最小写法是用with zipfile.ZipFile(path) as archive打开文件,再遍历archive.namelist()。它只返回归档成员名称,不会把成员文件释放到当前目录。
先用 namelist() 读取压缩包目录
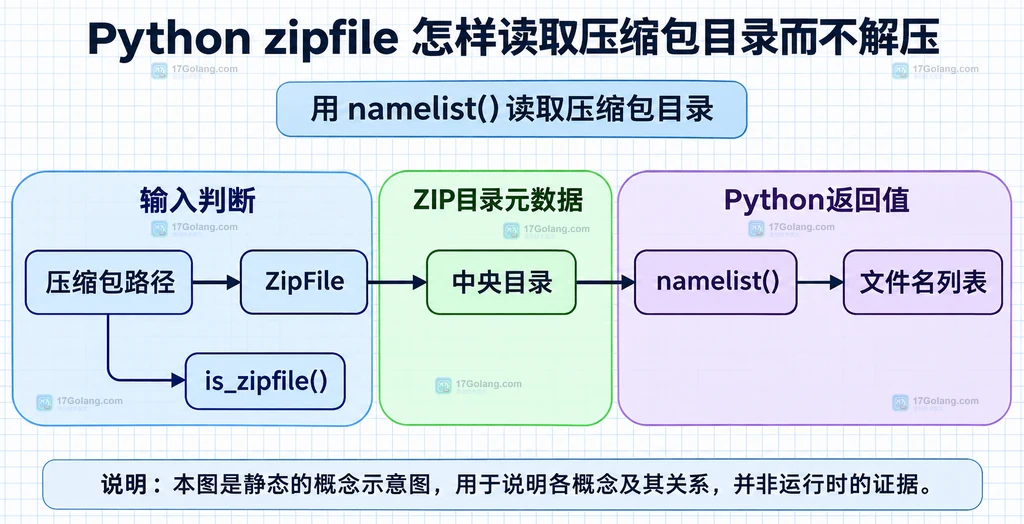
namelist() 返回归档中成员名称组成的列表,适合先做文件存在性判断、目录前缀筛选和简单目录展示。使用上下文管理器可以让读取目录结束后自动关闭 ZIP 文件:
from pathlib import Path
from zipfile import BadZipFile, ZipFile

archive_path = Path("release.zip")

try:
    # 这里只读取 ZIP 的成员名称,不把任何成员解压到磁盘。
    with ZipFile(archive_path) as archive:
        names = archive.namelist()
        for name in names:
            # 名称可能以 / 结尾,表示归档中的目录条目。
            print(name)
except BadZipFile:
    # 文件存在但不是可读取的 ZIP 时,给调用方保留明确错误边界。
    print("输入文件不是有效的 ZIP 归档")
这里的关键是 ZipFile 负责打开归档,namelist() 负责返回名称。列表中的名称仍然是归档内部路径,不是已经创建在本机文件系统上的路径,因此不能把它们当成解压结果。
用 infolist() 读取条目元数据
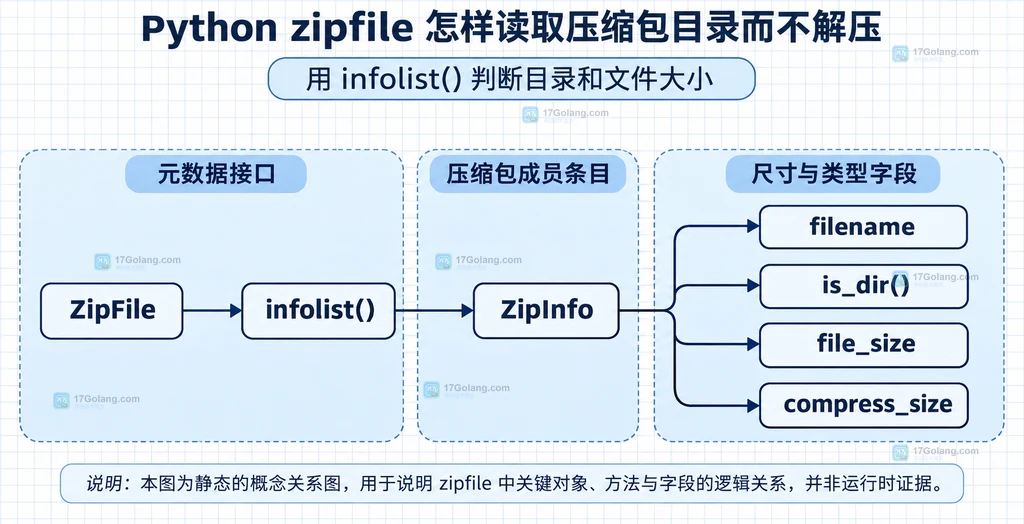
如果还要判断某个成员是不是目录,或者比较原始大小与压缩后大小,可以遍历 infolist()。它返回 ZipInfo 对象,每个对象对应一个归档成员:
from zipfile import ZipFile

with ZipFile("release.zip") as archive:
    for info in archive.infolist():
        # is_dir() 判断归档条目是否表示目录,避免只靠字符串猜测。
        kind = "目录" if info.is_dir() else "文件"
        print(
            f"{kind}: {info.filename} | "
            f"原始 {info.file_size} bytes | 压缩后 {info.compress_size} bytes"
        )
filename 是归档中的成员名,file_size 是未压缩大小,compress_size 是压缩数据大小。它们都是目录元数据,读取这些字段不等于读取成员正文。对于旧式或特殊归档,也不要假设每个目录都一定有一个显式的“目录条目”;判断具体文件时,用名称前缀和业务规则补充处理更稳妥。
打开前先判断输入是不是 ZIP
文件名后缀不能完全代表文件格式。如果输入来自上传、批处理或用户选择,先用 is_zipfile() 做轻量判断,再进入 ZipFile 读取流程,可以把普通文件和损坏归档分开处理:
from pathlib import Path
from zipfile import BadZipFile, ZipFile, is_zipfile

path = Path("incoming.data")

if not is_zipfile(path):
    # 这个判断只说明文件不符合 ZIP 文件特征,不负责修复或解压文件。
    raise ValueError(f"不是 ZIP 文件: {path}")

try:
    with ZipFile(path) as archive:
        # 目录读取仍然只访问成员清单,不读取每个成员的正文。
        for name in archive.namelist():
            print(name)
except BadZipFile as exc:
    # 处理目录结构损坏等打开错误,避免把异常伪装成空目录。
    raise ValueError("ZIP 目录无法读取") from exc
is_zipfile() 适合做输入筛选,但它不是内容安全审计,也不能保证每个成员都能成功解压。真正打开时仍要处理 BadZipFile,不要在异常后返回一个“没有文件”的空列表。
区分目录查看、读取内容和实际解压
这几个接口名称相近,但资源成本和结果不同:
| 操作 | 得到什么 | 是否把成员释放到磁盘 |
|---|---|---|
namelist() | 成员名称列表 | 不会 |
infolist() | 名称、大小、时间等 ZipInfo 元数据 | 不会 |
printdir() | 直接把目录表打印到标准输出 | 不会 |
read(name) | 指定成员的解压后字节内容 | 不会写入文件,但会读取内容 |
extractall(path) | 把成员解压到目标目录 | 会 |
因此,做“压缩包里有没有某个配置文件”的判断时,先用 namelist() 或 infolist();只有确实需要解析文件内容时,再调用 read()。不要为了列目录而执行 extractall()。
命令行也可以只列目录
不写 Python 脚本时,标准库自带的命令行接口可以直接列出 ZIP 文件成员:
# -l 只列出 ZIP 目录,不把成员解压到目标目录。
python -m zipfile -l release.zip
命令行方式适合人工快速查看;需要根据目录前缀筛选、读取大小字段或接入上传流程时,再使用 Python API。二者都应该把“查看目录”和“读取内容”分开。
处理不可信压缩包时不要直接解压
只读取目录通常比直接解压更容易控制,但目录名称本身也应该被当作外部输入。对于来源不明的归档,不要因为列出了某个文件就认为内容可信;如果后续要执行 read() 或解压,应设置文件数量、单文件大小、总大小和处理时间等业务限制,并把输出目录固定在受控位置。
尤其要注意,官方文档对 extract() 和 extractall() 提醒过路径、文件系统容量和压缩炸弹等风险。本文的示例停留在目录读取阶段,不能替代对实际解压流程的安全设计。
常见问题
namelist() 会把压缩包解压吗?
不会。它返回归档成员名称;如果要得到某个成员的实际字节内容,应调用 read(),如果要生成本地文件,则应使用提取接口。
为什么只看文件后缀不够?
后缀是命名约定,不是文件格式判断。上传或批处理输入可以先调用 is_zipfile(),打开时再捕获 BadZipFile。
如何判断一个条目是目录?
使用 infolist() 得到 ZipInfo 后调用 info.is_dir()。同时保留对名称前缀的业务判断,因为不同归档不一定显式保存全部目录条目。
总结
Python zipfile 读取压缩包目录的核心是:用 ZipFile 打开归档,用 namelist() 读取成员名称,用 infolist() 读取 ZipInfo 元数据。is_zipfile() 和 BadZipFile 负责输入边界,read() 与 extractall() 则分别进入内容读取和实际解压阶段。把这些职责分开,既能减少不必要的磁盘写入,也能让后续的安全限制更容易落地。
-
346 收藏
-
235 收藏
-
332 收藏
-
387 收藏
-
447 收藏
-
文章 · python教程 | 16分钟前 | python · 版本升级 · sys.version_info Python 3.14.10 Python安全修订 ssl.OPENSSL_VERSION pip-audit167 收藏
-
342 收藏
-
118 收藏
-
460 收藏
-
117 收藏
-
221 收藏
-
230 收藏
-
206 收藏
-
218 收藏
-
文章 · python教程 | 1小时前 | 标准库 · python · 压缩文件 Python 3.14 Zstandard compression.zstd zstd.open ZstdCompressor152 收藏
-
192 收藏
-
438 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习