-

SQL实现思路如何查询在指定时间段内连续多日都有特定商品库存的商店?以下是一个SQL实现思路:通过UNION...
-

悲观锁的使用场景悲观锁,又称悲观并发控制,是一种假设数据会经常被其他事物修改的并发控制策略。在使用...
-

MySQL查询两个字段特定值且重复记录如何查询refund_id相同,且return_code为SUCCESS的记录,并且该记录中的...
-

Python连接MySQL数据库时出现报错在Python中,使用mysql.connector连接MySQL数据库时,可能会遇到如
之类的报错�...
-

<p>MySQL的基础命令包括:1.连接服务器:mysql-uroot-p;2.创建数据库:CREATEDATABASEmydatabase;3.选择数据库:USEmydatabase;4.创建表:CREATETABLEusers(idINTAUTO_INCREMENTPRIMARYKEY,nameVARCHAR(100)NOTNULL,emailVARCHAR(100)NOTNULLUNIQUE);5.插入数据:INSERTINTOusers(name,email)VALUES('JohnD
-

MySQL实现数据同步的主要方式包括主从复制、基于日志的同步和第三方工具。主从复制是MySQL原生支持的方式,通过主库写入、从库读取并重放binlog实现同步,适用于读多写少场景;使用GTID可简化故障切换并提升一致性保障;第三方工具如Canal、Debezium、MaxScale提供更灵活方案,适合跨数据库或大数据同步需求;同步时需注意主键冲突、网络延迟及定期校验一致性等问题。
-

使用布隆过滤器防护缓存穿透是因为它能快速判断元素是否可能存在,拦截不存在的请求,保护数据库。Redis布隆过滤器通过低内存占用高效判断元素存在性,成功拦截无效请求,减轻数据库压力。尽管存在误判率,但这种误判在缓存穿透防护中是可接受的。
-

HAVING和WHERE的区别在于作用时机和场景:1.WHERE在分组前筛选行,用于过滤原始数据,如筛选工资>5000的员工;2.HAVING在分组后筛选结果,用于过滤聚合结果,如保留员工数>5的部门;3.两者可同时使用,如先筛选工资>5000的员工,再保留平均工资>8000的部门;4.不能在WHERE中使用聚合函数,因为其逐行判断,而聚合计算需基于一组行。
-

<p>要从零开始学习MySQL操作,需按以下步骤进行:1.安装MySQL,可从官方网站或使用包管理器。2.连接到MySQL服务器,使用命令行工具mysql。3.创建数据库,如CREATEDATABASEmydb;。4.创建表,如books表,并插入数据。5.进行查询,如SELECT*FROMbooks;。6.学习复杂查询,如使用JOIN和子查询。7.优化性能,使用索引等工具,如CREATEINDEXidx_isbnONbooks(isbn);。通过这些步骤,你可以逐步掌握MySQL的基本操作和
-

Redis安全漏洞的扫描与修复可以通过以下步骤进行:1.使用Redis-Rogue等工具进行扫描,并在扫描前备份数据。2.分析报告,关注未授权访问、弱密码和过期版本等问题。3.修复时,设置强密码(如"Redis@2023#Sec"),定期更换,并更新到最新版本。
-

Redis布隆过滤器不支持动态扩容,BF.RESERVE设定的capacity和error_rate不可修改;扩容需手动迁移数据并切换key,参数选错易致内存激增或OOM。
-
Pub/Sub频道命名必须带租户前缀,采用三段式结构{租户标识}:{业务域}:{实体ID},禁用裸频道和通配符泛订阅;ACL需按前缀精确控制,显式授权+subscribe/+publish;TLS与消息体加密必须同时启用;Pub/Sub不可替代可靠队列,应改用Stream或List。
-
Redis碎片率超1.5时响应变慢甚至雪崩,根本原因是jemalloc在不连续空闲块中反复查找合适内存块,导致分配延迟升高、CPU波动、GC压力上升并可能引发级联雪崩。
-
STRING_AGG必须指定非NULL分隔符且排序需在函数内显式声明;它自动跳过NULL但保留空字符串,应优先于array_agg+array_to_string,处理数组字段需先unnest。STRING_AGG 语法必须带分隔符,不能省略或传 NULL 在PostgreSQL 15里,STRIN
-
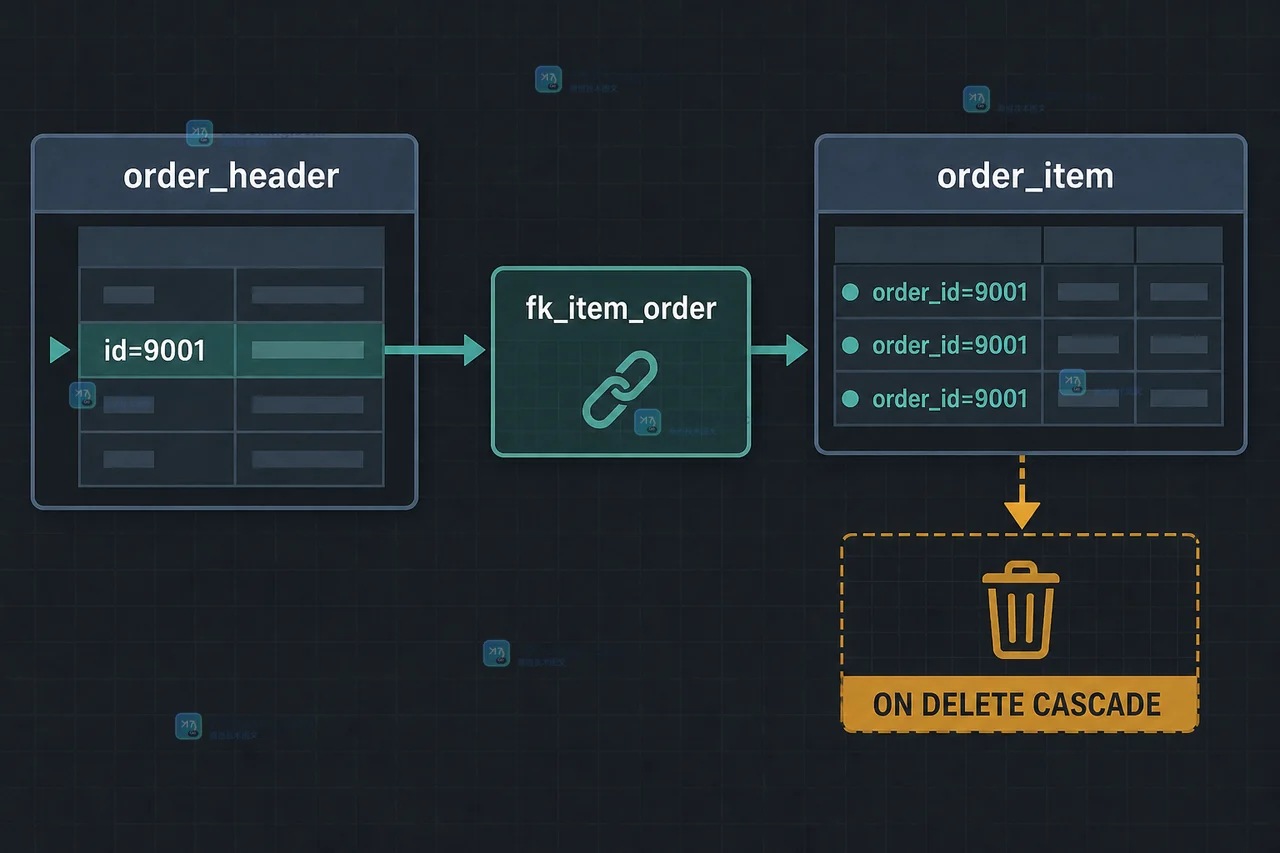
删除一条订单主表记录时,如果外键触发级联检查,耗时可能来自子表扫描、级联删除和锁等待。本文用 InnoDB 示例拆开索引与锁范围。
