-

一,Redis简单介绍Redis是一个高性能的key-value非关系型数据库,由于其具有高性能的特性,支持高可用、持久化、多种数据结构、集群等,使其脱颖而出,成为常用的非关系型数据库。此外,Re
-
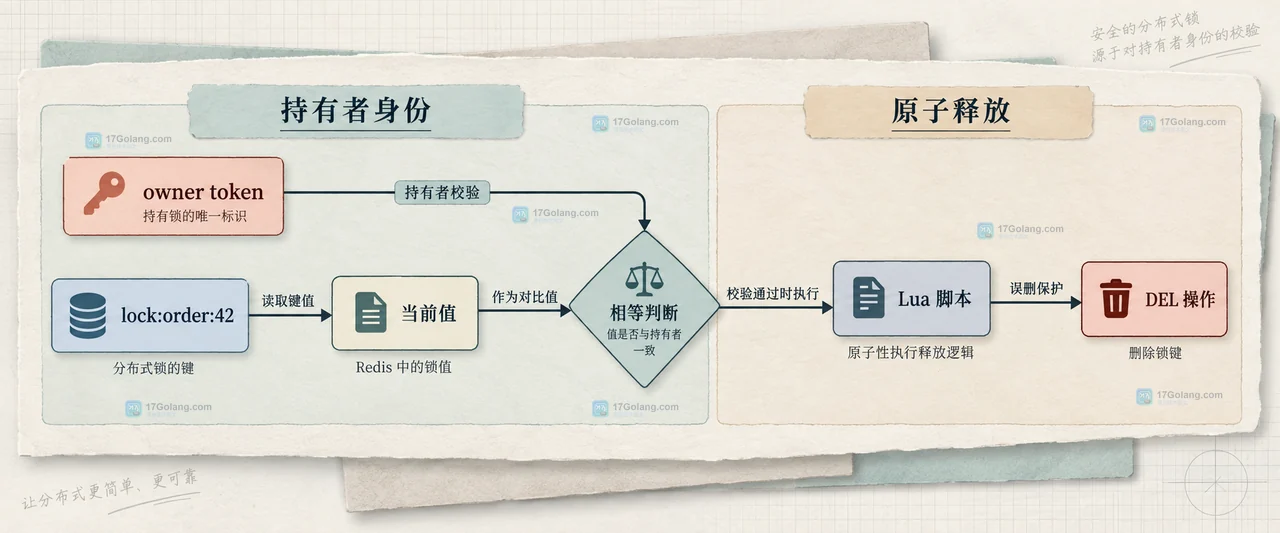
用 Redis SET NX EX 原子创建带过期时间的分布式锁,配合唯一 token 和 Lua 原子释放,避免锁永久残留或误删其他实例的新锁。
-
AOF重写后文件变大是因为重写时仍会写入带过期时间但尚未过期的key,尤其高频短TTL的SET/EXPIREAT等指令堆积且无法压缩,导致AOF体积膨胀。
-
Redis自动RDB备份不能仅用crontab调用bgsave,因BGSAVE异步返回OK不保证写入完成,需校验rdb_last_save_time和文件非空,并动态获取路径、加超时、轮转清理。
-

“永不过期”策略实质是Rediskey物理永存,逻辑过期时间嵌入value中;安全的get_with_logic_expire需用SETNX抢锁、双重检查、异步更新;必须搭配主动刷新机制防脏数据。
-
确保Redis与MySQL数据一致性的方法是:1.写操作优先写入MySQL,然后异步更新Redis;2.读操作优先从Redis获取数据,若Redis无数据则从MySQL读取并更新Redis。这种方法通过消息队列实现异步更新,确保最终一致性,并提高读操作性能。
-
有效解决Redis集群脑裂问题的方法包括:1)网络配置优化,确保连接稳定性;2)节点监控和故障检测,使用工具实时监控;3)故障转移机制,设置高阈值避免多主节点;4)数据一致性保证,使用复制功能同步数据;5)人工干预和恢复,必要时手动处理。
-

监控Redis内存变化的步骤包括:1)使用INFOmemory命令查看当前内存使用情况;2)通过MONITOR命令实时监控命令执行对内存的影响;3)利用慢查询日志间接监控内存变化;4)结合Prometheus和Grafana实现全面监控。
-

SpringBoot与非关系型数据库Redis的整合(1)添加SpringDataRedis依赖启动器引入这个依赖器创建项目,在项目pom.xml文件会出现以下依赖:(2)编写实体类Person:packagecom.hardy.springbootdataredis.domain;importorg.springframework.data.annotation.Id;importorg.springframework.data.redis.core.RedisHash;importorg.spring
-

利用Redis实现分布式缓存预热的实践在现代大型应用程序中,缓存是提升性能和减少服务器负荷的常见方法之一。而分布式缓存预热则是在高并发场景下常用的优化技术之一。本文将介绍如何利用Redis实现分布式缓存预热,并给出具体的代码示例。什么是缓存预热缓存预热是指在应用启动或者系统容量空闲时,提前加载部分数据到缓存中,避免在用户请求到达的短时间内,大量请求直接命中数
-

在当今互联网时代,搜索引擎已经成为了人们获取信息的重要途径,而高性能的搜索引擎也成为了许多企业和网站的追求目标。Redis作为一款高性能、开源的缓存系统,已被广泛应用于搜索引擎的构建中,成为了构建高性能搜索引擎的利器之一。在本文中,我将介绍Redis在搜索引擎中的应用,以及给出具体的代码示例。1、Redis在搜索引擎中的应用Redis作为一款高性能的缓存系统
-

使用Redis和Scala构建实时数据分析应用随着大数据时代的到来,实时数据分析在各个行业中变得越来越重要。而在构建实时数据分析应用时,选择合适的技术栈是至关重要的。Redis是一个功能强大的内存数据库,而Scala则是一种强大而灵活的编程语言。本文将介绍如何使用Redis和Scala构建实时数据分析应用,并通过代码示例演示其实现过程。首先,我们需要安装和配
-
RedisLua脚本中不能直接执行SET等命令,必须通过redis.call()或redis.pcall()调用;MULTI/EXEC等事务命令禁用;所有key需显式传入,集群下须同slot;返回值类型需手动判断,避免误判false/0。
-
Redis内存飙升多因bigkey,应优先在从节点用redis-cli--bigkeys扫描,避免主节点阻塞;它仅返回每类最大key且不反映真实内存,需结合MEMORYUSAGE和访问频次进一步分析。
-

Redis“无条件刷新”实为业务代码显式执行SET/SETEX覆盖key,需确保写路径确定、key名准确、实例正确;禁用SETNX,慎用GETSET;批量操作须防pipeline/事务失败导致缓存未更新;穿透雪崩时应加空值缓存与随机TTL而非强行刷新。
