-
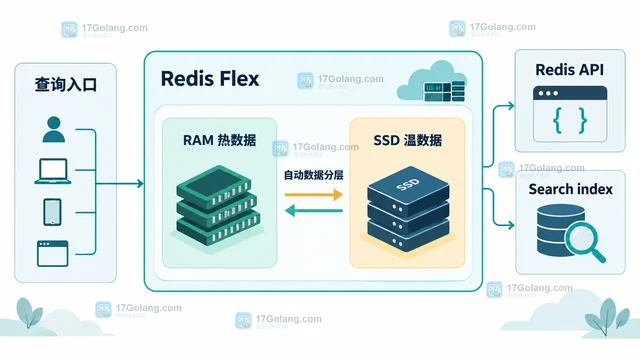
Redis Flex 把 RAM 与 SSD 组合成分层存储后,索引与数据的驻留位置会直接影响查询边界。本文区分自动分层、Redis Search 索引和返回路径,给出大数据集下的选型与查询设计方法。
-
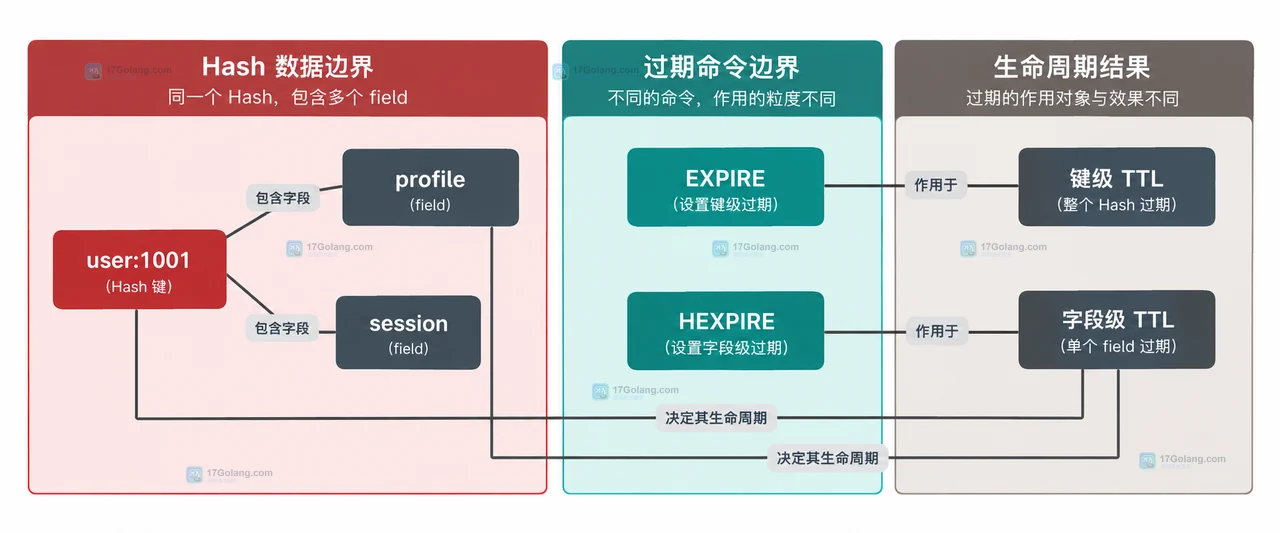
EXPIRE 只能让整个 Redis Hash key 过期,不能单独淘汰某个 field。Redis 7.4.0 起可用 HEXPIRE、HPEXPIRE 设置字段级 TTL;旧版本则应按生命周期拆分 key。
-

Redis 8.6 新增 HOTKEYS,可以在指定采样窗口内按 CPU 或网络指标找出高频访问键。本文从缓存延迟升高的现场出发,演示 HOTKEYS START、GET、STOP 的最小用法,解释 COUNT、DURATION、SAMPLE 与 SLOTS 的边界,并给出集群分片、误判和上线验收清单。
-

一台Redis服务器在很短的时间里消耗了几十个G的内存,最终因为SWAP而宕机。因为这台服务器的社会背景比较复杂,所以一时无法判断犯罪嫌疑人到底是谁。
最开始的直觉是认为肯定有人保存了
-

序言
Redis的几种基本数据结构有字符串(String)、哈希(Hash)、列表(List)、集合(Set)、有序集合(Sorted Set),这些是最常见的,也能在官网上查看到。
官网链接:Redis 教程_redis教程
字符
-
Redis Functions 升级最容易混淆的是 library name、function name 和 Lua 脚本 SHA1。本文用整库替换、脚本兼容窗口和升级检查表,说明如何保持业务调用名稳定。
-
缓存击穿是热点key过期瞬间并发请求涌向DB,需用逻辑过期、随机过期时间、分级预热、互斥锁及行为验证来防控。
-

Redis列表在消息队列中的应用可以通过以下优化措施提升性能和可靠性:1.启用持久化机制(AOF或RDB)确保消息不丢失;2.使用BRPOP命令提高消费者的响应性和降低系统负载;3.通过多个列表模拟优先级队列处理不同优先级的消息;4.设置键的过期时间或在消息中加入时间戳管理消息的生命周期;5.利用批量操作减少网络开销,提升系统性能。
-

Redis和Kafka可以集成使用,发挥各自优势。1.用户行为数据先存储在Redis中,确保实时性。2.通过定时任务或触发器将数据推送到Kafka,保证数据的顺序和可靠性。3.后端系统从Kafka消费数据进行实时分析和处理,实现高效的消息队列系统。
-

Redis启动后无法访问的原因主要包括配置文件问题、网络问题、防火墙设置和内存不足。解决方案如下:1.调整配置文件,确保绑定地址和端口正确;2.修复网络连接,确保Redis服务器和客户端连接正常;3.调整防火墙规则,允许Redis端口访问;4.增加内存或调整Redis配置,确保内存充足。
-
如何利用Redis和Ruby实现分布式锁功能简介:分布式锁是在分布式系统中实现并发控制的重要机制之一。在高并发的环境下,为了保证数据的一致性和完整性,需要使用锁来控制对共享资源的访问。本文将介绍如何使用Redis和Ruby来实现分布式锁功能。RedisRedis是一个内存数据库,常用于缓存、消息队列和分布式锁等场景。它的特点是高性能、支持多种数据类型和提供了
-
Redis扣库存,主要目的是减少对数据库的访问,之前的减库存,直接访问数据库,读取库存,当高并发请求到来的时候,大量的读取数据有可能会导致数据库的崩溃。
大家可以先读一下《秒杀系
-
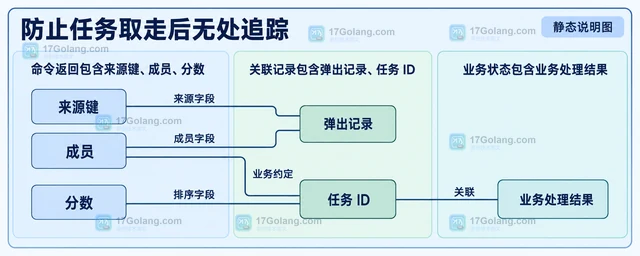
Redis BZPOPMIN 在集合为空时阻塞等待,有成员时弹出最低分项。本文说明超时秒数、多 key 的来源选择顺序,并用独立示例区分队列内最小值与全局最小值,提醒弹出后的任务恢复责任。
-
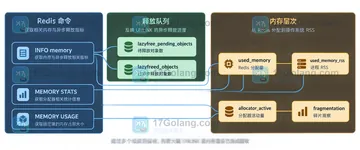
Redis UNLINK 只会先把 key 从键空间摘除,真正的对象释放在后台异步完成。本文用 lazyfree 队列、used_memory、RSS 和 MEMORY STATS 建立删除大键后的内存回收判断方法。
-
volatile-lru是仅对设置了TTL的key生效的近似LRU淘汰策略,不淘汰无过期时间的key;必须显式配置maxmemory-policy且配合EXPIRE或SETEX使用,否则无效。
