-

Redis Functions 不是把一段脚本临时塞进缓存,而是先加载成数据库里的函数库,再由客户端通过 FCALL 调用。本文用一个库存扣减函数说明 FUNCTION LOAD、显式传入键名、FUNCTION LIST 和重启后的恢复验收边界。
-

Redis和Kafka可以集成使用,发挥各自优势。1.用户行为数据先存储在Redis中,确保实时性。2.通过定时任务或触发器将数据推送到Kafka,保证数据的顺序和可靠性。3.后端系统从Kafka消费数据进行实时分析和处理,实现高效的消息队列系统。
-

Redis内存占用过高可以通过以下步骤优化:1.设置maxmemory参数控制内存使用量;2.选择合适的内存回收策略,如volatile-lru或allkeys-lru;3.使用EXPIRE命令设置键的过期时间;4.选择合适的数据结构,如使用Hash类型存储小对象;5.调整持久化配置,选择RDB或AOF;6.实施分片(Sharding)技术。这些方法结合使用,可以有效降低Redis的内存占用,提升系统性能。
-

如何使用Redis实现分布式缓存更新在分布式系统中,缓存起到了重要的作用,可以大大提升系统的性能和可扩展性。而Redis作为一种高性能的内存数据库,常用于分布式缓存的实现。本文将为您介绍如何使用Redis实现分布式缓存的更新,并给出具体的代码示例。一、分布式缓存的更新策略在分布式系统中,多个节点同时访问缓存时,可能会出现缓存不一致的问题。为了解决这个问题,可
-

Redisson是Redis服务器上的分布式可伸缩Java数据结构----驻内存数据网格(In-Memory Data Grid,IMDG)。底层使用netty框架,并提供了与java对象相对应的分布式对象、分布式集合、分布式锁和同步器、分布
-

面试官:小明呀,redis 有几种数据结构呀?小明:8 种面试官:那你说一下分别是什么?小明:raw,int,ht,zipmap,linkedlist,ziplist,intset,skiplist,embstr面试官:额,你在说什么?小明:在回答你的问题
-

1、简单动态字符串(SDS)
Redis 虽然是用 C 语言写的,但Redis没有直接使用C语言传统的字符串表示(以空字符 ‘\0’ 结尾的字符数组),二是自己构建了一种名为简单动态字符串(simple dyn
-
确保Redis与MySQL数据一致性的方法是:1.写操作优先写入MySQL,然后异步更新Redis;2.读操作优先从Redis获取数据,若Redis无数据则从MySQL读取并更新Redis。这种方法通过消息队列实现异步更新,确保最终一致性,并提高读操作性能。
-

1、redis哨兵(Sentinel)
1.1、redis集群介绍
前面文章讲的主从复制集群是无法实现master和slave角色的自动切换的,如果master节点出现现redis服务异常、主机断电、磁盘损坏等问题导致master无法使用
-
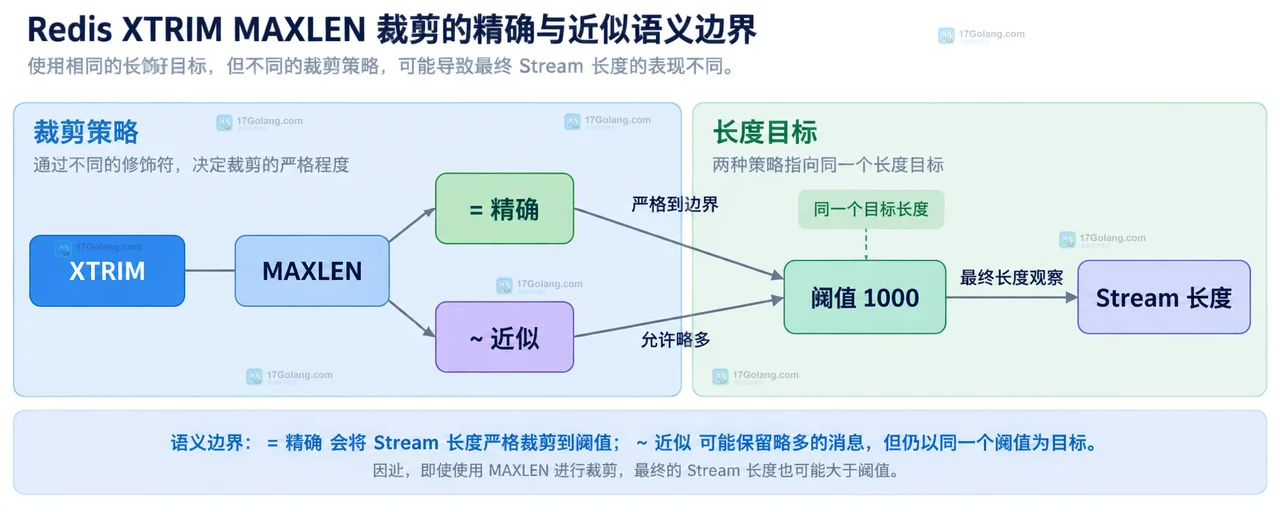
Redis Stream 使用 XTRIM MAXLEN ~ 时,阈值是近似目标而不是硬上限,宏节点边界和 LIMIT 都可能让裁剪后保留少量额外消息。本文用 XLEN、XRANGE 解释结果,并给出精确裁剪与 MINID 的选择方法。
-
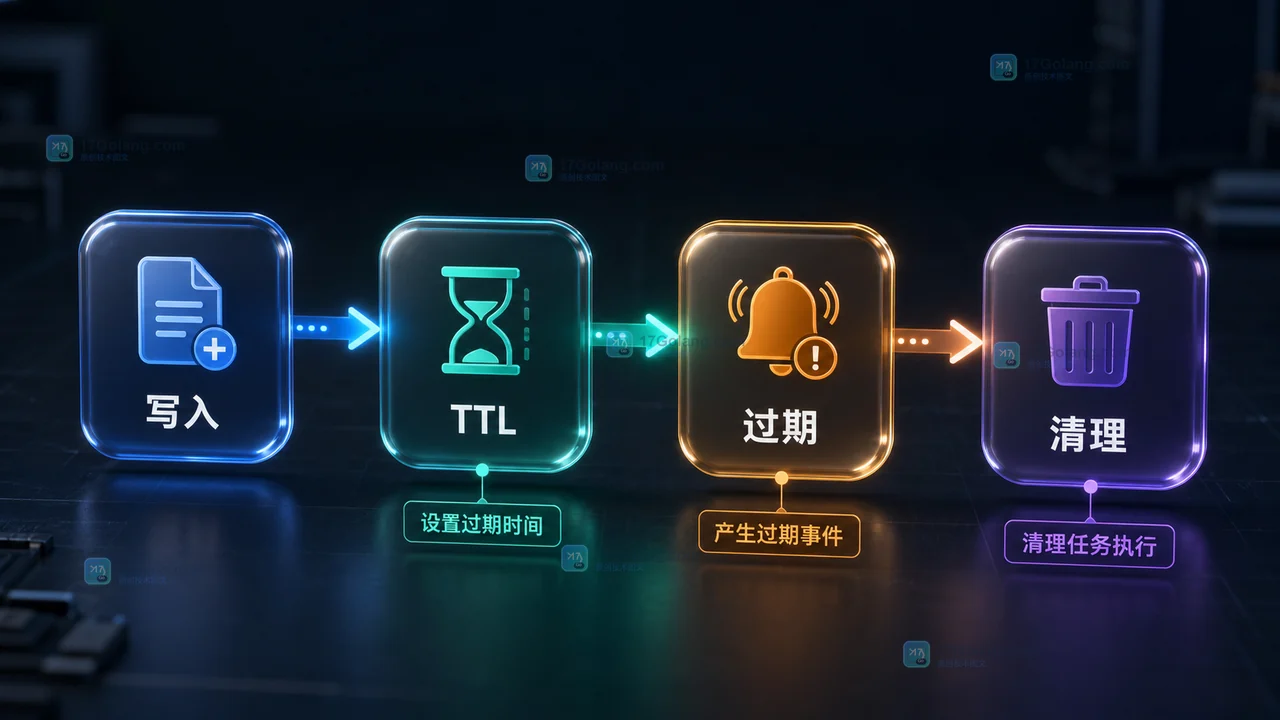
Redis 过期键通知适合做自动清理的提醒信号,但不能当成可靠消息队列。更稳的做法是订阅事件触发清理任务,同时保留补偿扫描、幂等门禁、失败重试和告警复盘。
-
volatile-ttl策略仅在内存达限且有写入时触发,随机采样已设TTL的key并淘汰其中剩余过期时间最短者,并非主动或精准清理“马上过期”的key。
-
RedisPub/Sub不支持优先级,仅为瞬时广播;真正优先级队列需用List+BRPOP多键轮询,按queue:high→queue:medium→queue:low顺序原子消费,Pub/Sub仅作轻量通知触发器。
-
有效解决Redis集群脑裂问题的方法包括:1)网络配置优化,确保连接稳定性;2)节点监控和故障检测,使用工具实时监控;3)故障转移机制,设置高阈值避免多主节点;4)数据一致性保证,使用复制功能同步数据;5)人工干预和恢复,必要时手动处理。
-

Redis和Kafka可以集成使用,发挥各自优势。1.用户行为数据先存储在Redis中,确保实时性。2.通过定时任务或触发器将数据推送到Kafka,保证数据的顺序和可靠性。3.后端系统从Kafka消费数据进行实时分析和处理,实现高效的消息队列系统。
