-
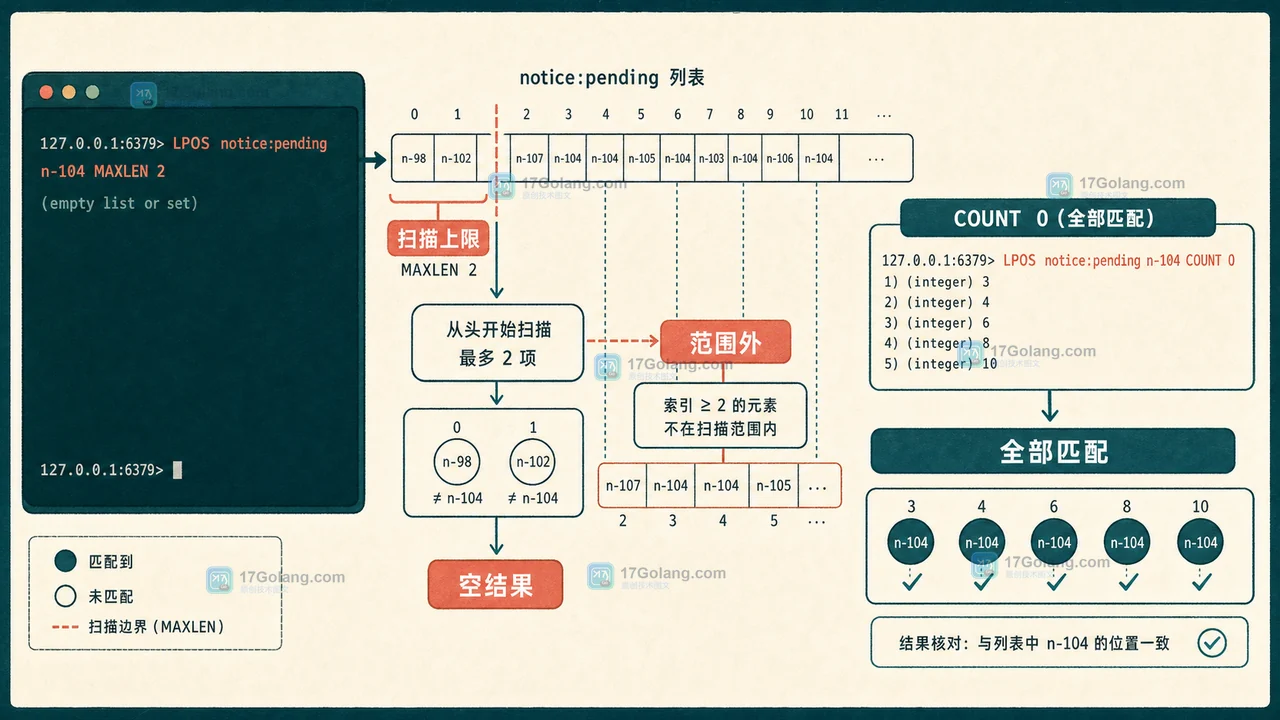
Redis LPOS 查找列表元素时,负数 RANK、List 下标和空结果容易混淆。本文用重复通知场景拆解从尾部定位、扫描边界与应用侧验收。
-
Redis卡顿但命令不慢,主因是系统级资源竞争:CPU中断、NUMA错配、swap抖动、TCP队列溢出、透明大页fork阻塞、磁盘IO毛刺等,需逐项排查验证。
-
RedisPub/Sub不能替代RabbitMQ,因其不保证消息可达、无持久化订阅、无消费确认机制,消息丢失理直气壮;它纯内存广播,断连、重启后消息全丢,无积压、无offset、无重试,仅适用于允许丢失的实时轻量场景。
-
Redis集群不支持跨槽位Lua脚本原子执行,所有key必须位于同一slot,可通过哈希标签(如{1001})强制路由、客户端ASKING模式及KEYS参数传入确保合规。
-
Redis列表在消息队列中的应用可以通过以下优化措施提升性能和可靠性:1.启用持久化机制(AOF或RDB)确保消息不丢失;2.使用BRPOP命令提高消费者的响应性和降低系统负载;3.通过多个列表模拟优先级队列处理不同优先级的消息;4.设置键的过期时间或在消息中加入时间戳管理消息的生命周期;5.利用批量操作减少网络开销,提升系统性能。
-
配置RedisSentinel高可用集群需要以下步骤:1.配置Sentinel节点,使用sentinelmonitor指令监控主节点;2.设置主从节点,确保从节点能自动接管;3.确保网络稳定性,避免误判;4.至少配置三个Sentinel节点保证高可用性;5.谨慎配置故障转移策略,设置超时时间;6.确保数据一致性,通过配置min-slaves-to-write和min-slaves-max-lag减少数据丢失风险;7.调整sentineldown-after-milliseconds参数减少不必要的故障转移
-

使用Python和Redis构建在线问卷调查:如何实现数据收集与分析引言:随着互联网的普及和发展,在线问卷调查成为了收集数据和获取用户反馈的重要方式之一。本文将介绍如何使用Python和Redis搭建一个简单而强大的在线问卷调查系统,并通过代码示例演示如何实现数据收集与分析。一、什么是Redis?Redis是一个开源的内存数据存储系统,常用于缓存、消息队列和
-

如何利用Redis和Node.js实现数据同步功能引言:在如今的网络应用开发中,数据同步是一个非常重要的功能需求。当我们在多个服务间进行数据传输和共享时,需要保证数据的一致性和实时性。在本文中,我们将探讨如何利用Redis和Node.js实现数据同步的功能。通过使用Redis作为数据缓存和消息传递中心,以及Node.js作为应用开发运行环境,我们可以快速高效
-
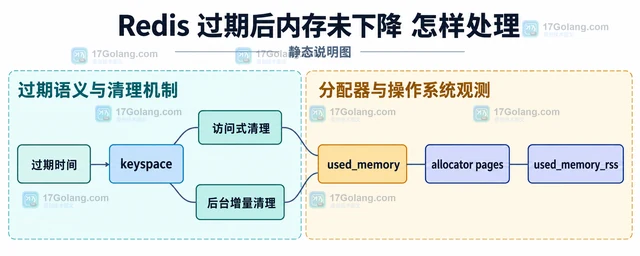
Redis 键过期后,used_memory、used_memory_rss 和 allocator 内存不一定同时下降。本文从 TTL、过期清理、分配器碎片和 RSS 四个层次判断现象,再给出低风险的处理顺序。
-
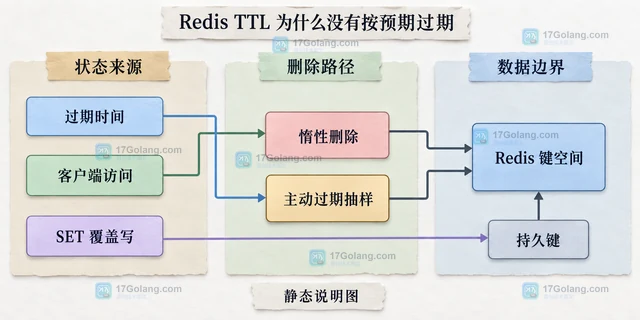
Redis TTL 不按预期过期,通常不是 Redis 忽略了时间,而是过期没有成功写入、后续 SET 覆盖清除了 TTL,或把主动清理误解成精确计时。本文用 TTL、PTTL 和最小命令集逐层定位。
-
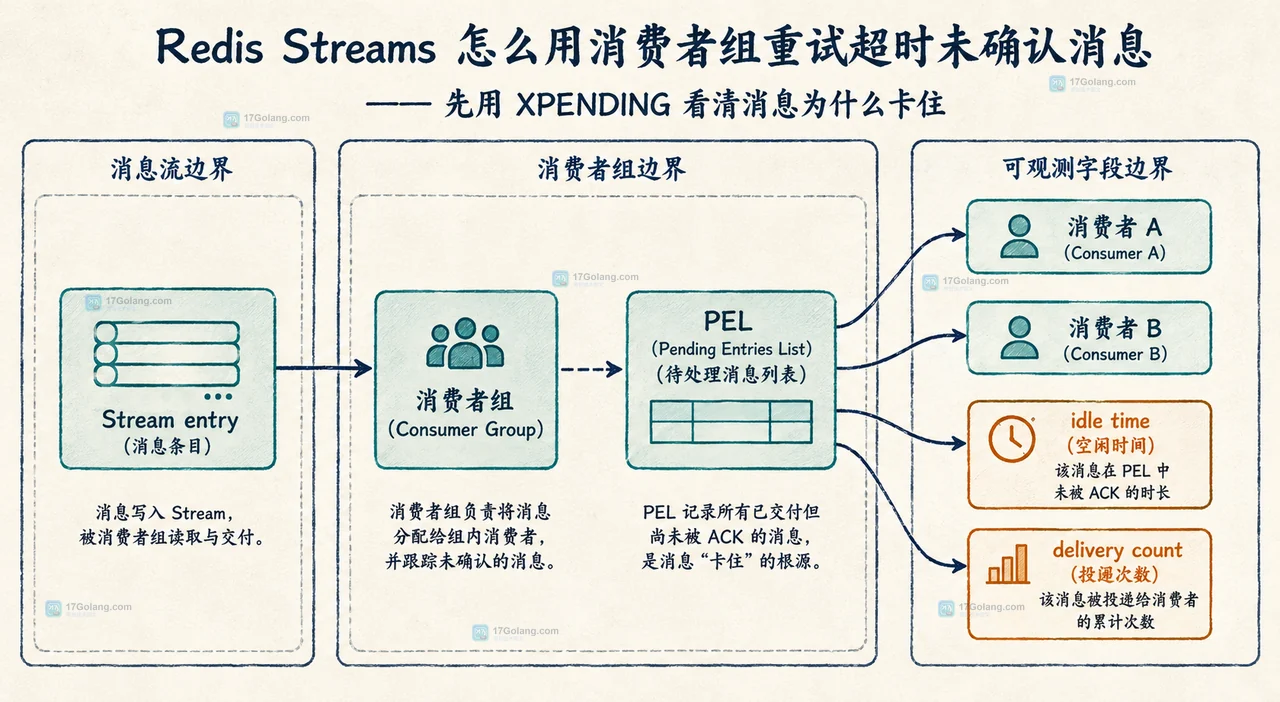
Redis Streams 消费者异常退出后,消息会留在 PEL 中。先用 XPENDING 观察归属、空闲时间和投递次数,再用 XAUTOCLAIM 接管超时消息,处理成功后用 XACK 完成闭环。
-
单纯靠频率限制无法防住缓存穿透,因其无法识别语义非法请求(如user_id=-1),且分布式攻击下单IP低频可绕过;限流仅作为兜底,需与布隆过滤器、空值缓存等联动,并结合多维特征精准识别恶意请求。
-
哨兵判定主节点“客观下线”失败的常见现象是客户端连接断开、写请求超时,但sentinelinfo显示master-status:ok或sentinels数量不足,本质是哨兵未达成quorum票数共识;原因包括quorum设置过大、哨兵间26379端口不通、monitor配置不一致等。
-
Redis集群通过主从复制、故障转移和一致性哈希保障数据一致性。优化方法包括:1.调整网络配置,提升网络性能;2.合理的数据分片策略,均衡负载;3.采用读写分离,提升读性能和降低主节点压力。
-
Redis的安全配置在不同环境下不同,因为各环境的角色和风险不同。1.开发环境配置宽松,建议启用基本认证,不暴露在公网。2.测试环境配置更严格,推荐强密码和更多安全措施。3.生产环境配置最严,使用最强密码和所有安全措施。通过合理配置和持续监控,确保Redis在各环境中的安全性和性能。
