-
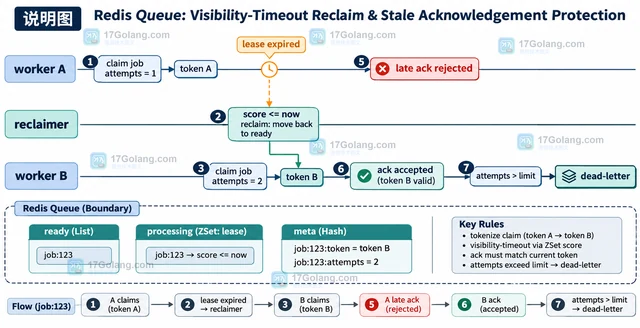
Redis 队列要处理消费者崩溃和失败重试,可以把任务原子转入 processing 区,用 Sorted Set 记录可见性超时,并用领取 token 防止旧消费者晚到确认误删新任务。本文给出状态模型、回收脚本和重试边界。
-
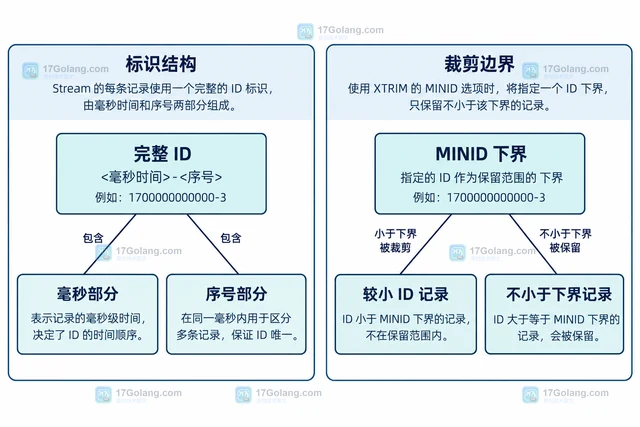
Redis XTRIM MINID 按完整消息ID下界裁剪Stream。通过独立样例区分精确、近似裁剪和消费组引用策略,说明时间窗口、残留记录与不可恢复删除的边界。
-
Redis 普通 SET 会替换键的过期设置。本文说明怎样用 KEEPTTL 覆盖字符串值、用 TTL/ PTTL 确认结果,并梳理 XX、永久键以及 EX/PX 参数冲突。
-

Redis Lua 返回 RESP3 map 时,客户端是否拿到字典取决于脚本内部的 redis.setresp(3) 与连接侧的 HELLO 3 是否分别配置正确。本文拆开两层协议,说明 RESP2 为何会把 map 展平成交替键值数组,并给出客户端解析检查表。
-
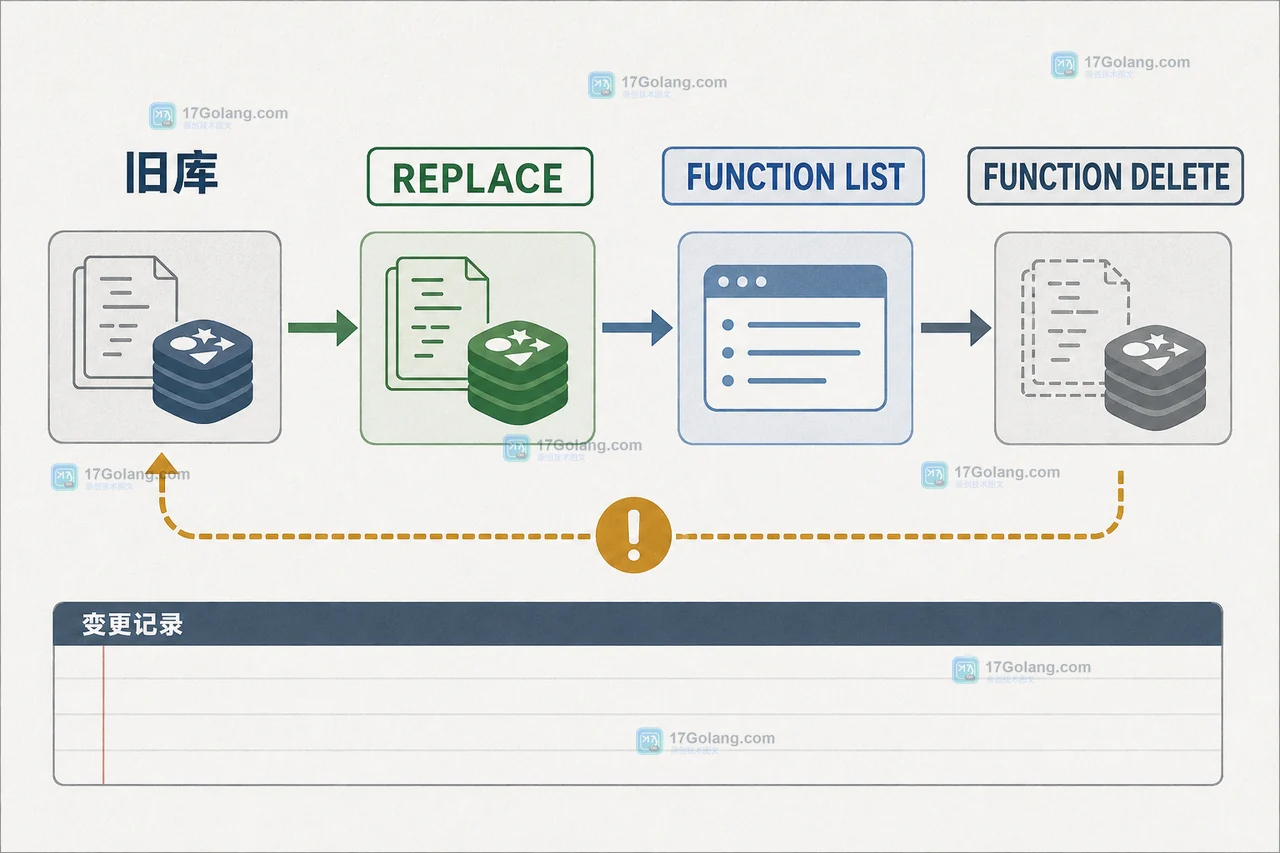
Redis Functions 会把 Lua 逻辑作为函数库保存。本文用一个订单状态校验函数说明 FUNCTION LOAD、REPLACE、FUNCTION LIST 和 FUNCTION DELETE 的切换边界,给出发布前验收与失败回滚顺序。
-
生产环境必须组合使用RDB和AOF:RDB作冷备快照,AOF负责实时写入;仅用AOF有崩溃导致启动失败、重放慢、数据丢失风险;仅用RDB则丢失窗口大、fork开销高、无法增量修复。
-

Redis和HBase可以协同工作,发挥各自优势。1)使用Redis处理实时数据和缓存,如用户行为数据。2)利用HBase存储和分析历史数据,如用户购买习惯。通过这种方式,可以实现快速访问和长久存储的平衡。
-

最佳实践是使用Docker部署Redis时,应注意数据持久化、配置管理、网络配置和性能优化。1.使用Docker命令启动Redis容器:dockerrun--namemy-redis-p6379:6379-dredis。2.配置数据持久化:dockerrun--namemy-redis-p6379:6379-v/path/to/host/data:/data-dredis。3.定制Redis配置:dockerrun--namemy-redis-p6379:6379-v/path/to/host/conf/
-

Redis因系统崩溃后的重启和数据恢复可以通过以下步骤实现:1)理解Redis的RDB和AOF持久化机制,根据业务需求选择合适的方式;2)使用redis-check-aof工具修复损坏的AOF文件;3)检查并调整redis.conf文件中的持久化设置;4)对于Redis集群,先移除崩溃节点,重启并恢复数据后再重新加入集群;5)定期使用bgsave命令备份数据,确保数据安全。通过这些步骤,可以有效地重启Redis并恢复数据,保障系统的连续性和数据的安全性。
-

Redis需要内存淘汰策略来在内存资源有限时决定移除哪些数据。选择最佳策略应基于应用场景和数据使用模式。具体策略包括:1.noeviction:适用于数据完整性要求极高的场景。2.allkeys-lru:适合缓存系统,淘汰最久未使用的数据。3.volatile-lru:适用于有明确过期时间的数据。4.allkeys-random:适用于对数据敏感度不高的场景。5.volatile-random:适用于有过期时间但对使用模式不敏感的数据。6.volatile-ttl:适用于优先移除即将过期数据的场景。
-

序言图示:Redis热度排名Redis当下很流行,也很好用,无论是在业务应用系统,还是在大数据领域都有重要的地位;但Redis也很脆弱,用不好,问题多多。2012年以前都是以memcached为主,之后转到Redis阵营,经历过单实例模式、主从模式、哨兵模式、代理模式,集群模式,真正公司层面用得好的很少,对于Redis掌控都很片面,导致实际项目中问题不少。Redis要想用得好,需要整体掌握3个层面:开发层面架构层面运维层面其中架构与运维至关重要,多数中小型企业仅在开发层面满足常用功能,数据规模稍微大些,业
-

Redis提供了RDB和AOF两种持久化方案:RDB:生成指定时间间隔内的Redis内存中数据快照,是一个二进制文件dumpr.rdbAOF:记录Redis除了查询以外的所有写命令,并在Redis服务启动时,通过重新执行这些命令来还原数据。RDB持久化默认Redis会以RDB快照的形式将一段时间内的数据持久化到硬盘,保存成一个dumpr.rdb二进制文件。【相关推荐:Redis视频教程】工作原理简单介绍一下:当Redis需要做持久化时,Redis会fork一个子进程,子进程将数据写到磁盘上一个临时RDB文
-

如何利用Redis实现分布式锁的高可用,需要具体代码示例一、引言在分布式系统中,由于多个进程或线程可以同时访问共享资源,会带来资源竞争的问题。为了解决这个问题,需要引入分布式锁来进行资源的互斥访问。Redis作为一种内存数据库,提供了分布式锁的实现方式,并且具备高可用性。本文将介绍如何利用Redis实现分布式锁的高可用,并给出具体的代码示例。二、分布式锁的基
-
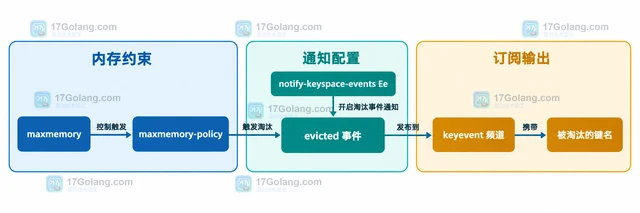
用 keyspace notification 实时观察 Redis 被 maxmemory 淘汰的键名,再用 INFO stats 的 evicted_keys 做累计核对,覆盖单机、断线和 Cluster 边界。
-
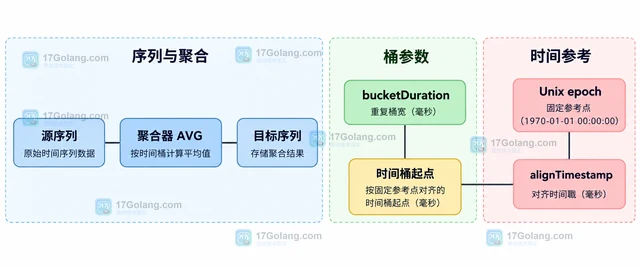
Redis TS.CREATERULE 的时间桶默认按 Unix epoch 对齐。本文用 alignTimestamp 解释毫秒参考点、时区边界、目标序列创建、空桶和最新部分桶,并区分规则对齐与 TS.RANGE 查询端 ALIGN。
