-

在当今的大数据时代,数据处理已成为各大企业和应用必备的重要环节。而在海量数据时代,如何才能更加高效地处理数据,成为所有企业和应用的共同难题。而流式数据处理在解决实时性强、数据量大的数据处理问题上发挥着重要作用。Redis作为流式数据处理平台之一,其实时计算能力备受关注。本文将与大家分享Redis作为流式数据处理平台实时计算能力的对比。一、KafkaKafk
-

随着互联网应用的发展,缓存技术在应用中越来越重要。Redis和Memcached都是当今比较流行的缓存解决方案,它们都有着优秀的性能和可靠性,但在一些方面上有所不同。本文将介绍Redis和Memcached的区别以及使用场景。简介Redis是一个基于内存的key-value存储系统,与Memcached不同的是,Redis支持多种
-
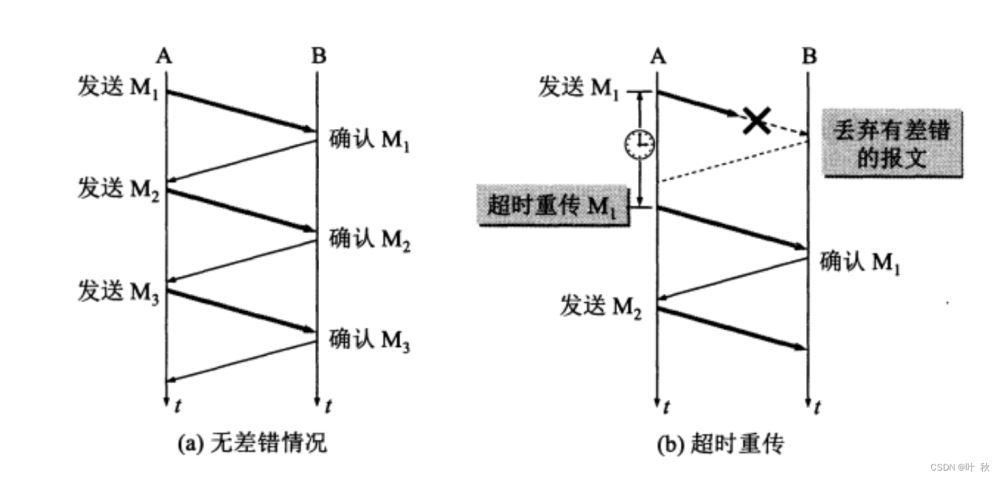
如何在redis中防止消息丢失
前言
在项目中,由于网络问题,我们很难保证生产者发送的消息能100%到达消息队列服务器,也就是说有消息丢失的可能性,因 此,生产者就必须具有消息丢失检测和
-
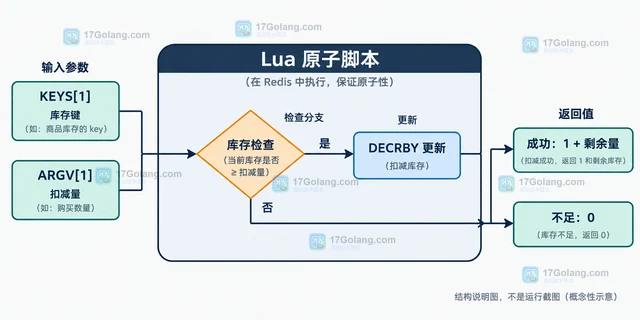
从客户端 GET、判断、DECRBY 的竞态出发,说明 Redis Lua 如何把检查与更新放入同一次原子执行,并给出 KEYS、ARGV、EVALSHA、NOSCRIPT 和脚本长度的迁移清单。
-
Redis LATENCY DOCTOR 只分析实例内部延迟事件,业务接口耗时还包含网络、连接池、序列化和下游调用。本文用 LATEST、HISTORY、慢日志与应用指标对齐排查,并说明 LATENCY RESET 的证据风险。
-
Redis Pub/Sub 采用至多一次投递,订阅端断线期间消息不会保留。本文用最小命令和排查表说明何时继续用 Pub/Sub,何时切换 Streams 或采用混合方案。
-
LPUSH+BRPOP构成FIFO阻塞队列,兼容Redis2.0+;但消费失败会导致消息丢失,适合允许少量丢失的场景,强可靠性需求应改用Stream。
-
要监控Redis命中率,可通过INFO命令获取keyspace_hits和keyspace_misses计算得出,或使用RedisInsight、Prometheus+Grafana等工具实现;命中率低常见原因包括1.缓存穿透,可用布隆过滤器或缓存空值解决;2.缓存击穿,可通过永不过期或互斥锁处理;3.缓存雪崩,需设置不同过期时间或引入二级缓存;4.淘汰策略不合理,应根据访问模式选择LFU等合适策略;5.内存不足,可扩容或用集群;6.Key设计不当,应规范命名并控制长度;提升命中率还需合理选用数据结构,如
-
通过redis-cli、RedisInsight、Prometheus和Grafana等工具,以及关注内存使用率、连接数、集群节点状态、数据一致性和性能指标,可以有效监控Redis集群的健康状态。
-
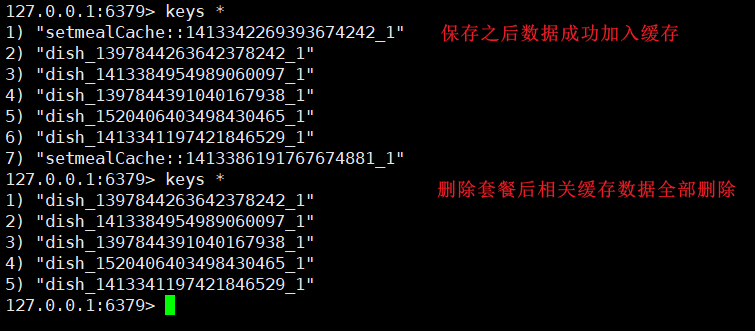
1、简介SpringCache是一个框架,实现了基于注解的缓存功能,只需要简单地加一个注解,就能实现缓存功能。SpringCache提供了一层抽象,底层可以切换不同的cache实现。具体就是通过CacheManager接口来统一不同的缓存技术。CacheManager是Spring提供的各种缓存技术抽象接口,这是默认的缓存技术,是缓存在Map中的,这也说明当服务挂掉的时候,缓存的数据就没了。针对不同的缓存技术需要实现不同的CacheManagerCacheManager描述EhCacheCacheMana
-
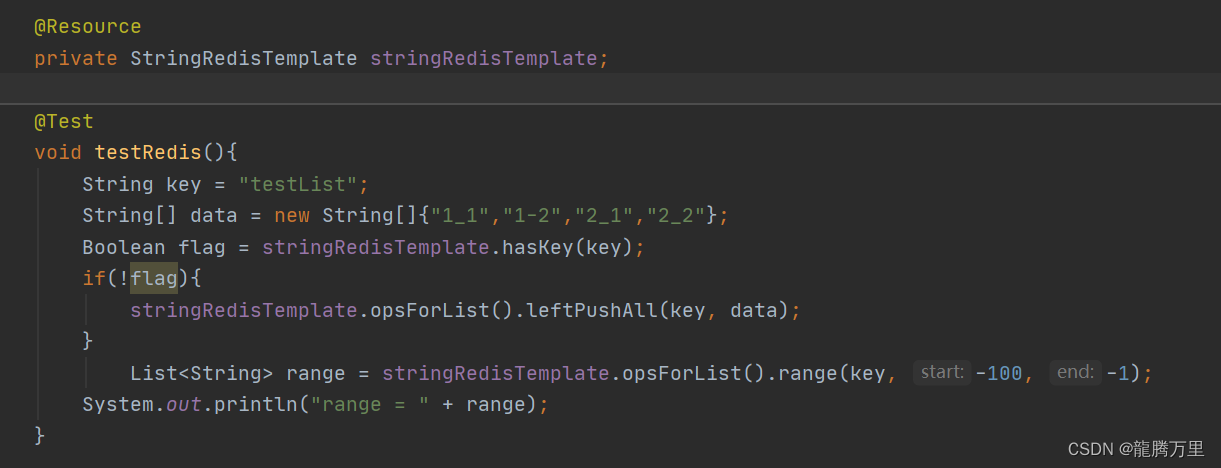
测试stringRedisTemplate.opsForList().range(key, start, end)的使用
结论(具体测试数据请往下看)
1、start—end总体保持着顺序就没问题
2、按照顺序,即便start < -N或者end > N-1也能查询出数据
3、特殊用法
-
react 一直遵循UI = fn(state) 的原则,有时候我们的state却和UI不同步 有时候组件本身在业务上不需要渲染,却又会再一次re-render。之前在项目中遇到的一些问题,这里做一个简单的分析,大家可以
-

Redis作为一款高性能的内存数据库,在日常应用中会面临着高并发的场景。为了应对这些需求,Redis提供了主从同步与读写分离的两种机制,以提高Redis的性能和可用性。本文将详细介绍Redis的主从同步与读写分离原理与实现方式。一、Redis的主从同步机制Redis的主从同步机制可以将数据从一个Redis服务器同步到另一个Redis服务器,以实现数据备份、负
-
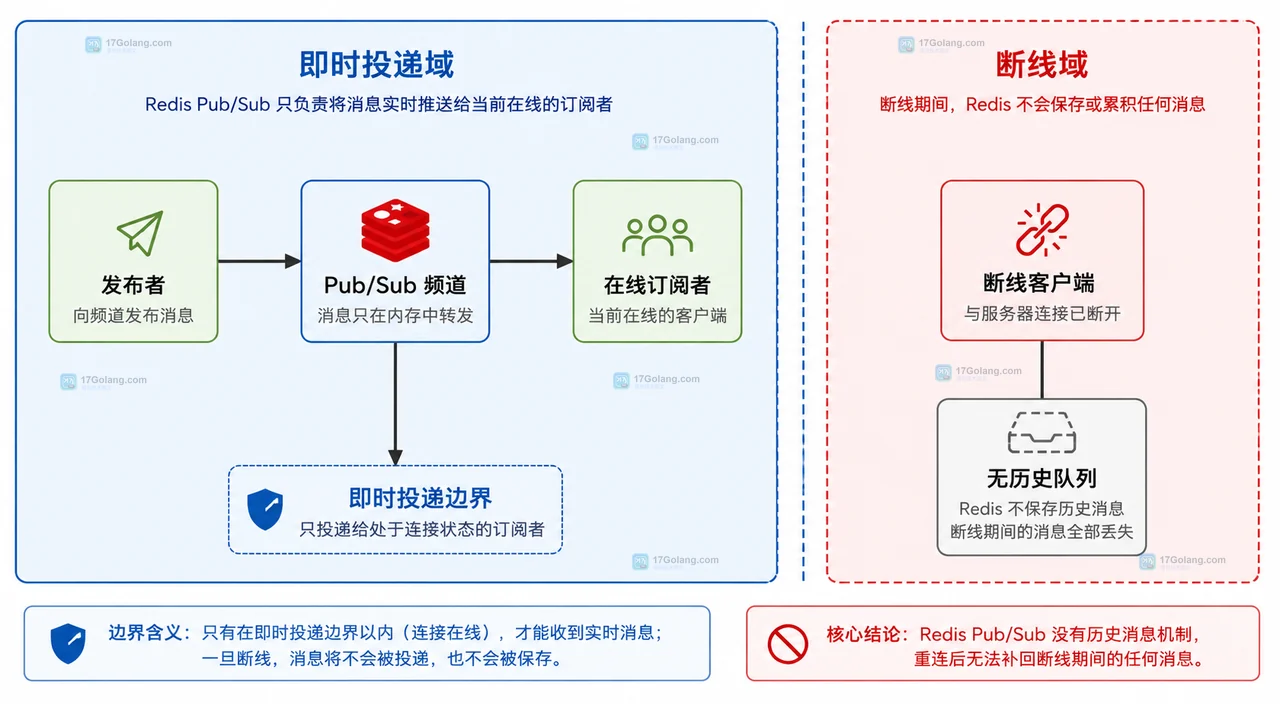
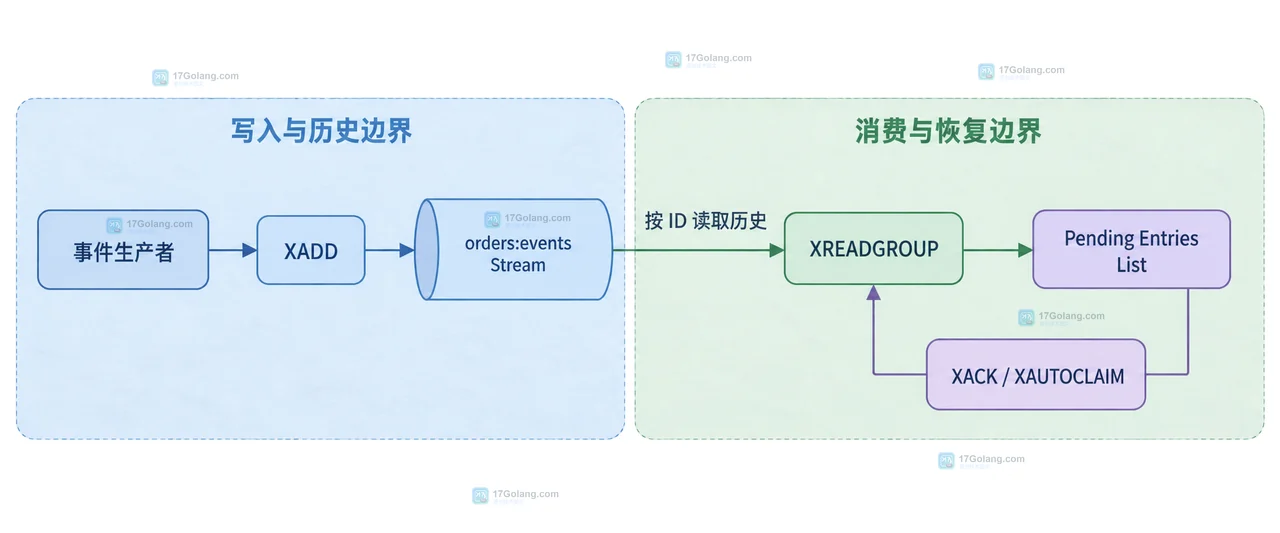
Redis Pub/Sub 断线后不能补回已经错过的消息。本文解释至多一次投递的原因,并用 Redis Streams 消费组设计可补读的可靠事件方案。
-
应从单节点Redis升级到集群模式,因为单节点在处理大规模数据和高并发请求时会遇到瓶颈,而集群模式通过分片和高可用性解决这些问题。升级步骤包括:1.评估现有数据量和访问模式,规划分片策略;2.准备新的集群环境,使用redis-cli--clustercreate命令创建集群;3.将数据迁移到集群,可使用MIGRATE命令或RDB快照方法;4.更新客户端连接逻辑,使用如redis-py-cluster库;5.实施分批迁移策略,监控数据一致性和系统性能;6.优化性能,设置监控和告警,制定故障恢复计划。通过这些
