
Go语言技术文章
-
科技周边 · 人工智能 | 2星期前 | 内存优化 · PyTorch DataLoader IterableDataset num_workers prefetch_factor pin_memory persistent_workers
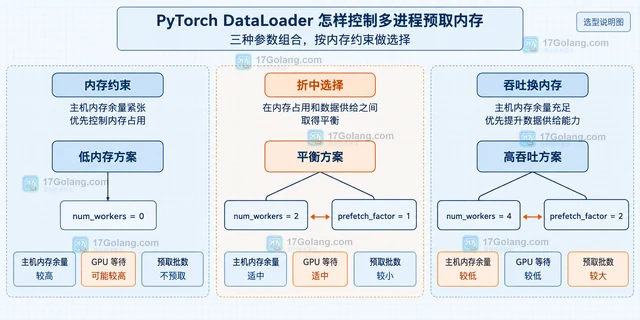 PyTorch DataLoader 的多进程内存主要受单批大小、num_workers 和 prefetch_factor 共同影响。本文用预取批次数估算主机侧占用,并比较低内存、平衡吞吐和高吞吐配置,同时说明 pin_memory、persistent_workers 与 IterableDataset 的边界。319 收藏
-
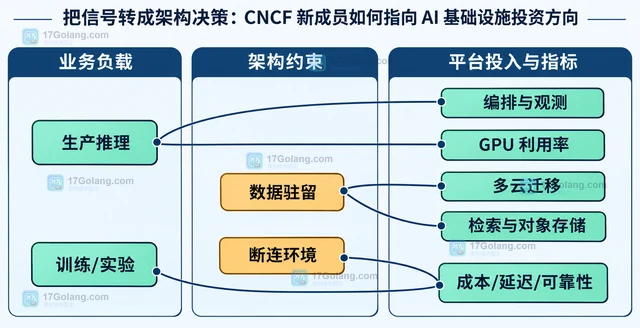 CNCF 2026 年 9 月新增九家 Silver Member,能力覆盖 AI 工厂、生产推理、资源效率、主权 Kubernetes、托管云和数据检索。本文区分公告事实与趋势判断,说明 AI 基础设施投资为何从单纯算力扩展到推理运营、混合部署和数据访问。318 收藏
-
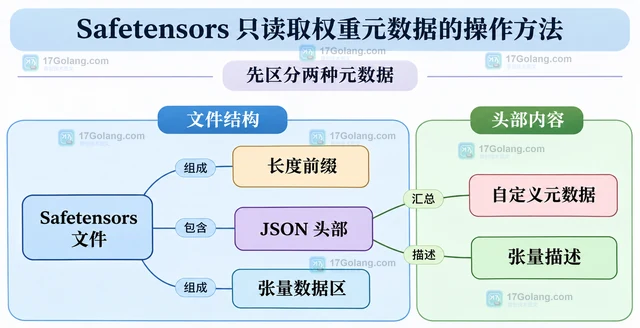 用 Python 标准库读取 Safetensors 长度前缀和 JSON 头部,获取张量名称、dtype、shape 与偏移,区分自定义元数据及分片索引,无需构造张量或初始化模型。318 收藏
-
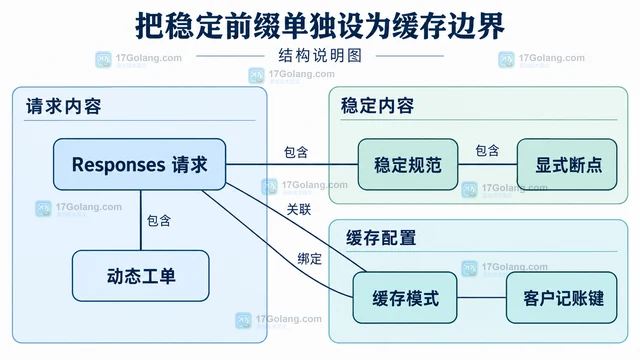 OpenAI API 提示词缓存需要稳定前缀与适用模型配置。通过显式缓存边界、读取和写入用量记录及完整请求组算例,判断重复输入是否真正降费,并区分旧模型参数。317 收藏
-
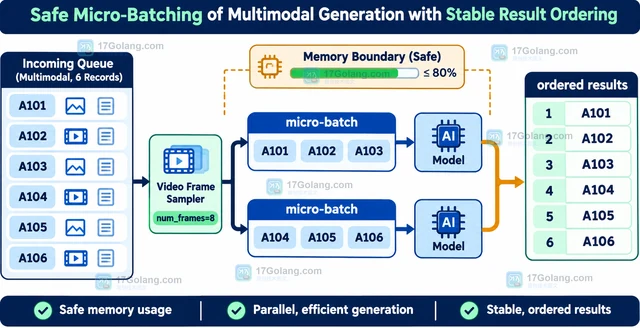 Transformers 处理多模态批次时,关键不是把图片简单塞进列表,而是让每条样本的消息结构、处理器字段和结果顺序保持一致。本文用 AutoProcessor、聊天模板、padding 与 micro-batch 说明一套可落地的批处理写法。317 收藏
-
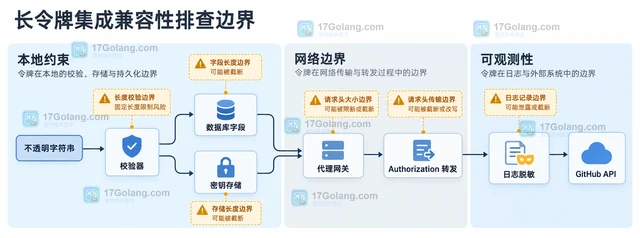 GitHub App 安装令牌从约 40 个字符变为约 520 个字符后,旧系统可能在长度校验、存储容量、Authorization 转发和日志脱敏处出现兼容问题。本文按链路给出排查与迁移清单。316 收藏
-
 OpenSSF 的近期活动把开源安全从单点扫描扩展到项目治理。本文结合 OSPS Baseline、Scorecard、Best Practices Badge 与协作指南,说明维护者怎样补齐责任、贡献入口、漏洞披露、CI、发布证据和上游参与,并明确分数与徽章不能替代项目判断或正式合规结论。316 收藏
-
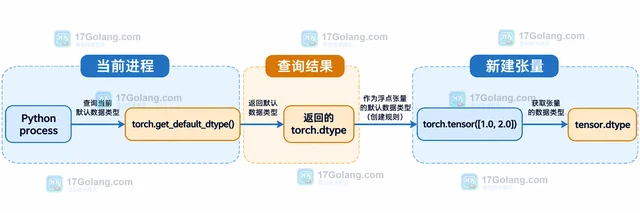 用 torch.get_default_dtype() 读取 PyTorch 当前默认浮点类型,分清已有张量 dtype、显式 dtype 与新建张量默认类型之间的关系。316 收藏
-
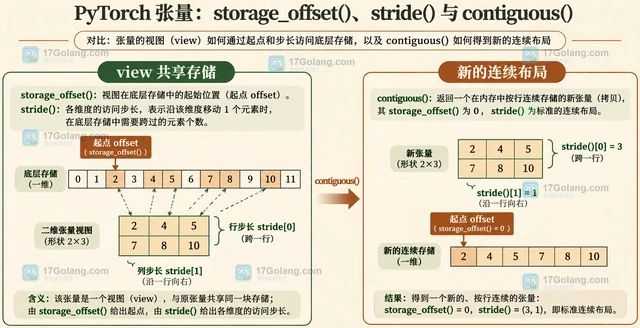 用切片和转置示例说明 PyTorch Tensor.storage_offset() 的读取方式,解释返回值是底层 storage 的元素偏移而非字节数,并把 storage_offset、stride、numel 与 contiguous() 放在同一套布局排查方法中。316 收藏
-
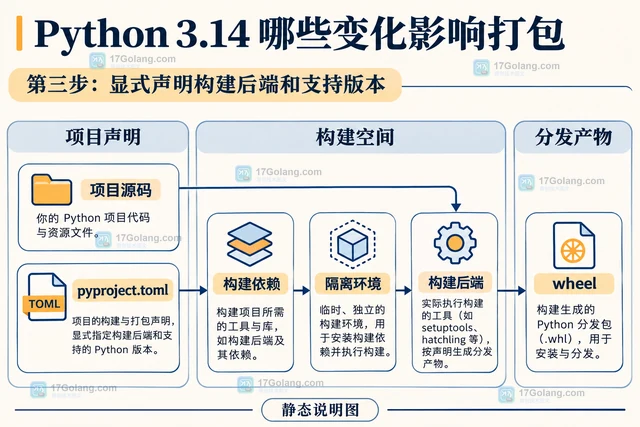 Python 3.14 的新语法、注解求值和自由线程构建会影响包的支持范围与工具兼容。通过最小项目说明隔离构建、版本声明、wheel 安装及原生扩展矩阵的区别。314 收藏
-
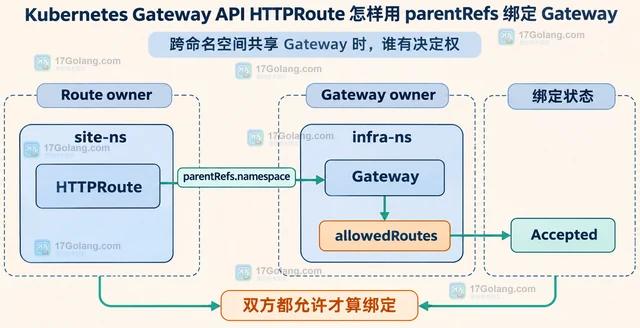 HTTPRoute 通过 spec.parentRefs 声明要绑定的 Gateway;同命名空间通常只写名称,跨命名空间还要写目标 namespace,并满足 Gateway Listener 的 allowedRoutes 约束。本文用原创说明图和 YAML 示例讲清绑定方式、sectionName 选择与 Accepted 状态排查。314 收藏
-
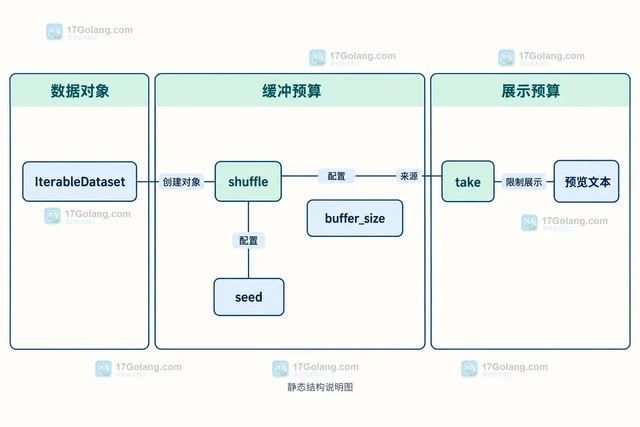 Datasets streaming 大数据集读取教程:使用 JSONL 和 IterableDataset 做有界预览,配置 shuffle 缓冲区,处理空数据与字段错误,避免全量累积内存。313 收藏
-
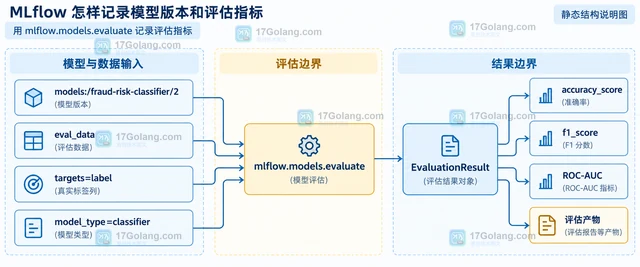 用一个完整的 MLflow Run 串起参数、手工指标、模型制品、注册模型版本和测试集评估结果:先固定实验与注册模型名,再用 registered_model_name 生成版本,最后通过 mlflow.models.evaluate 读取 accuracy、F1 等指标。313 收藏
-
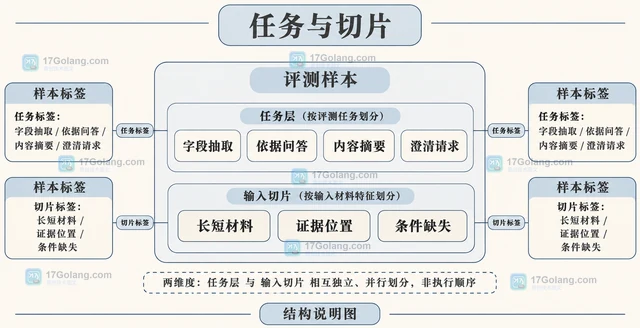 以客服助手为例,说明生成式模型评测集如何划分任务与切片、保存评分条件、配置常规集和挑战集,解释分层结果与加权汇总的区别,并维护固定测试集。313 收藏
-
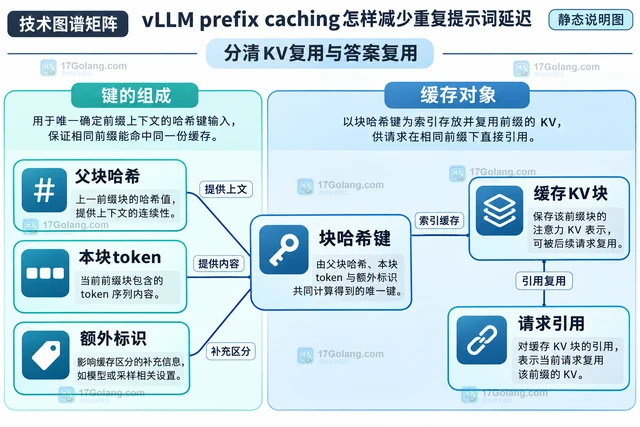 vLLM prefix caching怎样复用共同前缀KV缓存:显式启用APC、稳定提示词结构,用冷暖对照观察首字延迟,并区分预填充优化与答案缓存。312 收藏