-
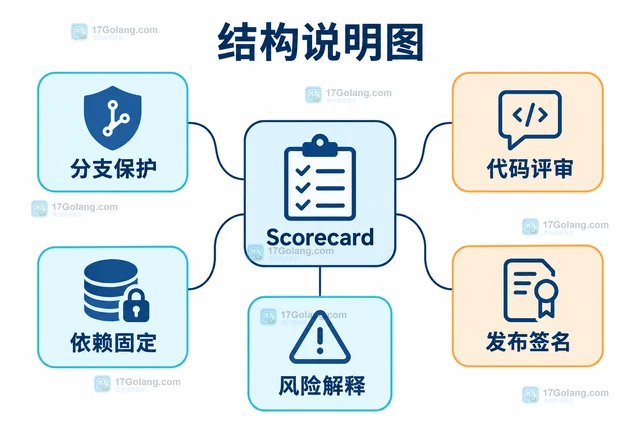
用假设依赖选型场景解释OpenSSF Scorecard安全信号的读法,关注仓库与报告时间、单项检查原因、权限导致的信息缺口及评分局限,将结果转为有条件的采用决定。
-
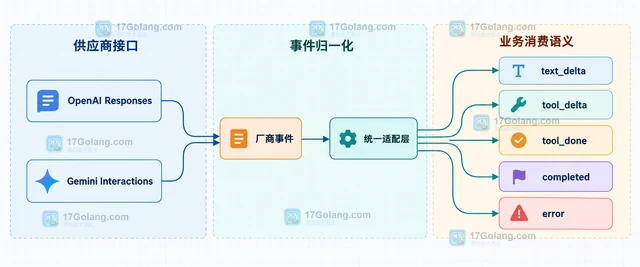
AI 流式接口会同时发送文本增量、工具调用参数和生命周期事件。本文用事件类型建立统一分流规则,说明 OpenAI Responses 与 Gemini Interactions 的差异,以及工具参数何时才适合解析。
-
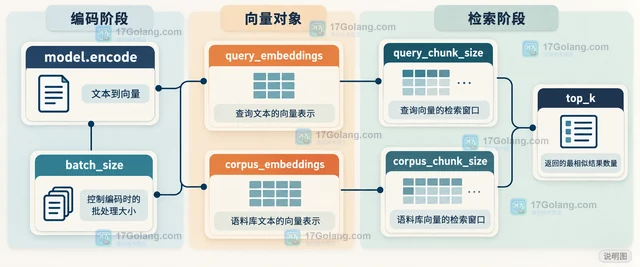
Sentence Transformers semantic_search 的分块大小由 query_chunk_size 和 corpus_chunk_size 控制。本文区分编码 batch_size、检索 chunk 与 top_k,给出按内存和耗时逐步调整的处理方法。
-
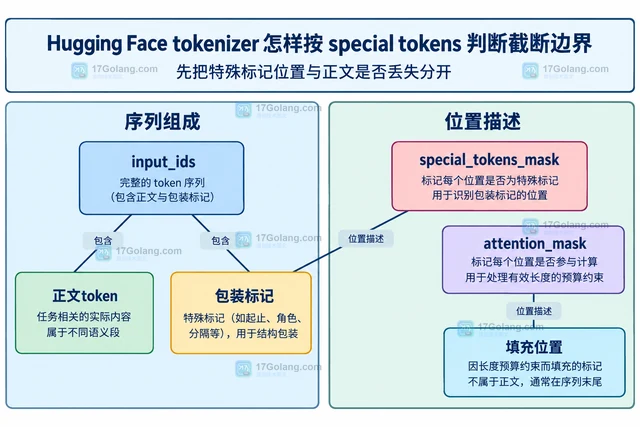
结合未截断编码、special_tokens_mask和模型包装开销,判断Hugging Face tokenizer的截断边界;解释文本对only_second、sequence_ids及SEP/EOS不能证明正文完整的原因。
-
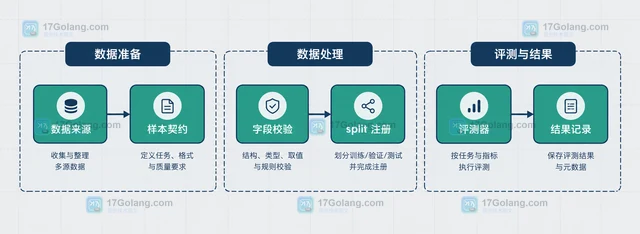
AI 模型评测实验集不能只把训练数据随机切一份。本文从样本契约、JSONL/Parquet 存储、validation 与 test 隔离、指标选择和版本记录五个方面,说明如何把评测边界固定下来,并用 Hugging Face Datasets 与 Evaluate 读取和计算结果。
-
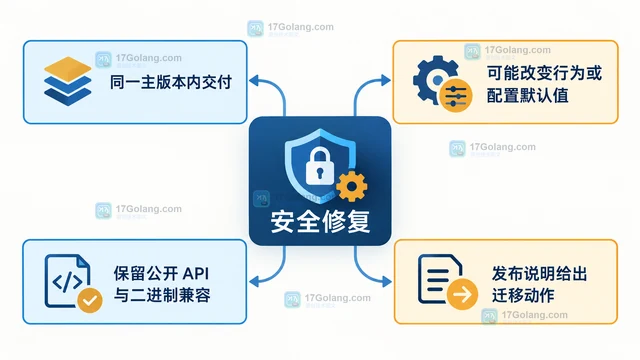
OpenTelemetry 更新了客户端版本策略,必要的安全修复可以在当前主版本内改变部分行为或配置默认值,但公开 API 和二进制兼容仍受保护。本文说明 SDK 升级时应检查的输入限制、默认值、遥测截断与初始化失败边界。
-
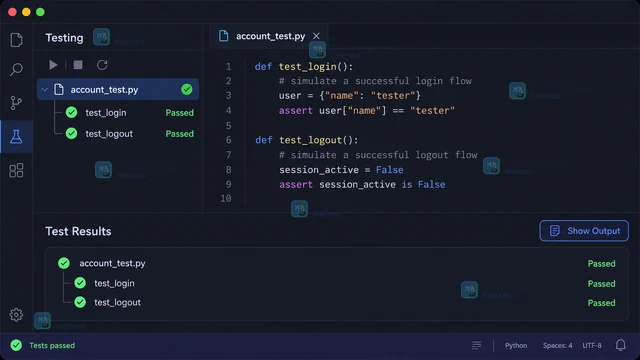
用 previous_response_id 把 OpenAI Responses API 的两轮请求串起来,讲清指令是否继承、store 与响应保留、链式输入计费,以及何时应该改用 Conversations API。
-
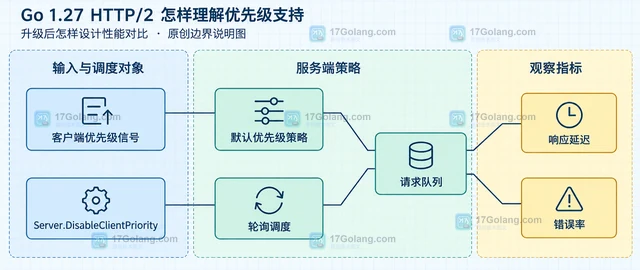
Go 1.27 的 HTTP/2 服务端开始接受 RFC 9218 客户端优先级信号,并可通过 Server.DisableClientPriority 保留旧的轮询行为。本文解释信号、调度和业务性能之间的边界,给出配置示例与升级后的回归观察项。
-
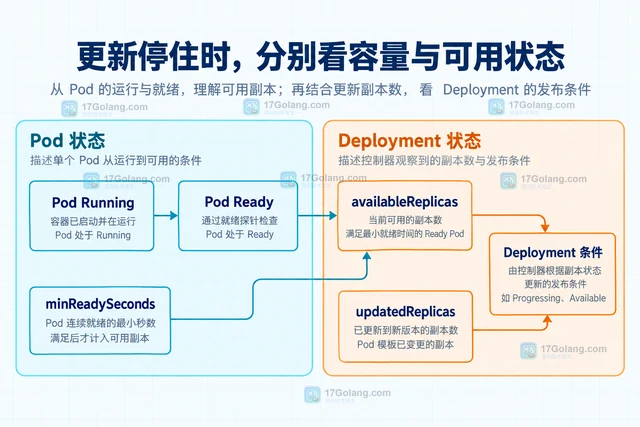
Kubernetes Deployment 的 maxUnavailable 是滚动更新可用副本预算。本文用副本计算和排查场景说明百分比舍入、maxSurge、Ready与Available,以及发布停滞的判断。
-
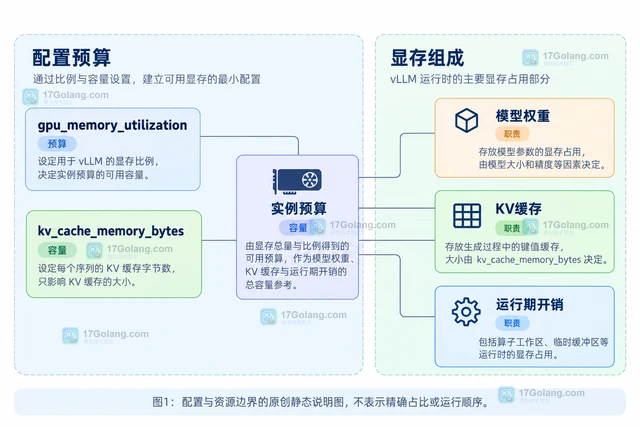
限制 vLLM 显存需区分实例比例预算、KV 缓存大小和上下文并发约束。本文给出保守启动示例,说明参数优先关系、共享GPU边界、失败回退与运行记录,不承诺固定节省比例。
-
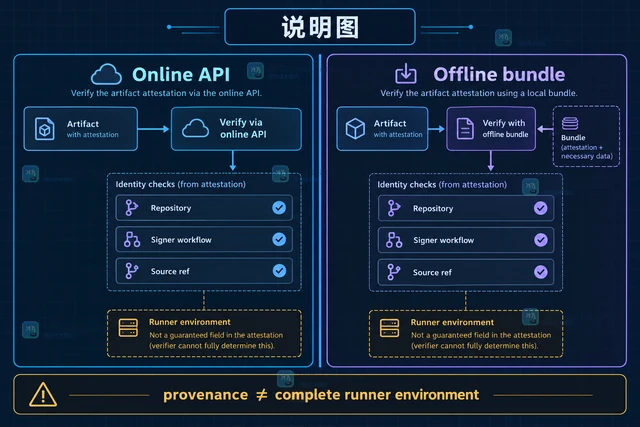
用 GitHub Actions 的 artifact attestations 为构建产物建立来源证明,再用 GitHub CLI 按仓库、签名工作流和来源提交核对;同时说明离线 bundle、trusted root 与 runner 环境的边界。
-
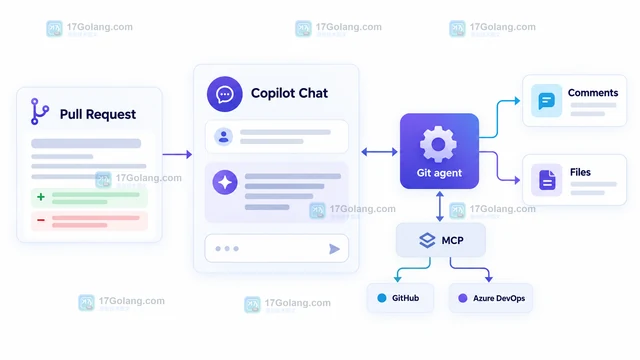
Visual Studio Copilot 的九月更新把 Pull Request 探索、BYOM 模型接入和 NuGet 漏洞修复带进更完整的 IDE 工作流。本文按真实采用顺序拆解入口、依赖与迁移风险。
-
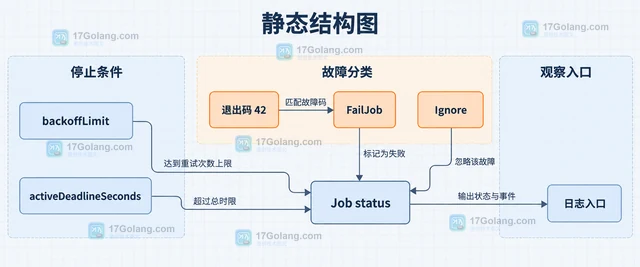
Kubernetes Job 失败后,容器重启、Pod 重建和 Job 终态并不是同一件事。本文用 backoffLimit、activeDeadlineSeconds 与 podFailurePolicy 设计可控重试,并给出发布前检查方法。
-
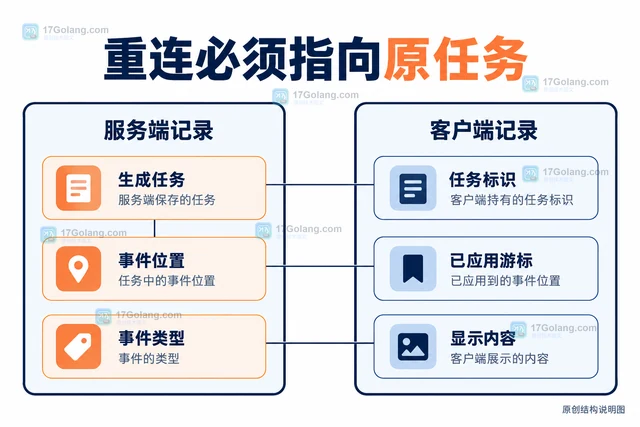
AI 流式断线恢复需区分连接重建、原任务事件重放与重新生成。本文说明 EventSource 和 fetch 的差异,给出任务标识、事件游标、去重、保留窗口与完成状态的设计方法。
-
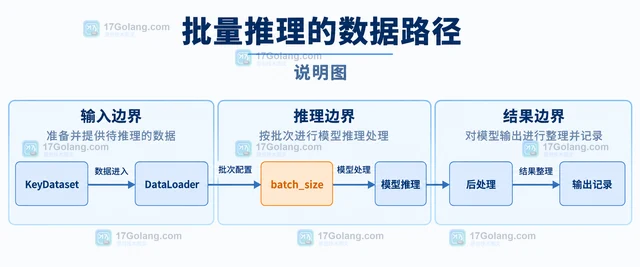
Hugging Face pipelines 的 batch_size 适合在可批处理的数据集推理中逐步调节。本文说明参数放在哪里、GPU 与 CPU 的边界、sequence_length 对显存的影响,以及如何记录吞吐、延迟和 OOM 风险。
