-
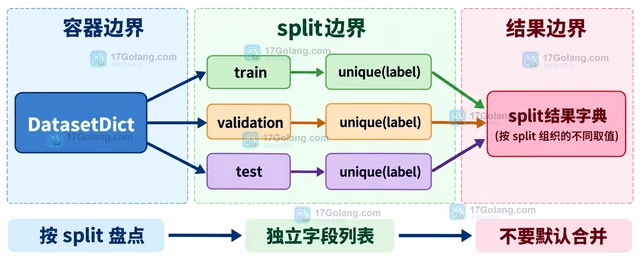
Hugging Face Datasets 的 Dataset.unique 和 DatasetDict.unique 可以直接列出字段的不同取值。本文用最小示例说明字段检查、split 结果、返回顺序以及高基数字段的内存边界。
-
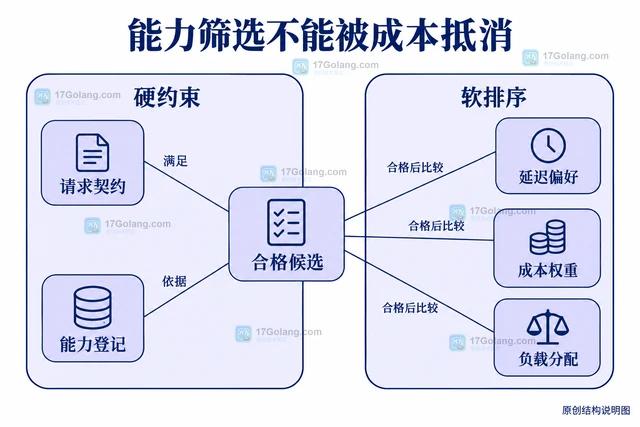
AI 网关应先按输入模态、工具、结构约束及业务允许范围过滤候选,再比较延迟和成本。本文说明端点能力登记、路由策略与故障回退边界,避免降级时丢失原请求语义。
-
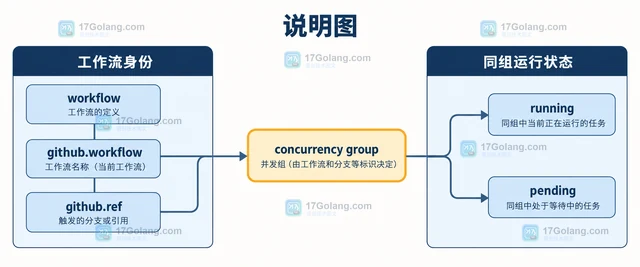
GitHub Actions 的 concurrency 可以按工作流或 job 控制同组运行。本文从 group 的边界、cancel-in-progress 的开启方式、Pull Request 回退值和发布分支保护几个场景,给出一套可直接改写到 YAML 的并发取消配置。
-
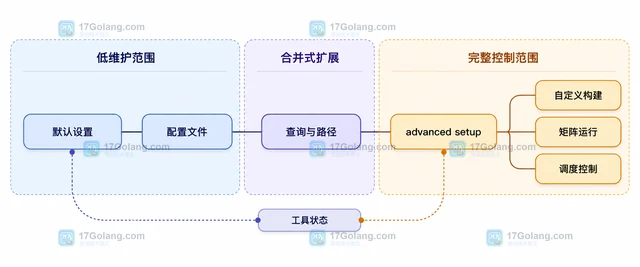
GitHub Code Scanning 默认设置适合快速启用并自动维护扫描配置;自定义配置文件适合补充查询和排除路径;只有需要自定义构建、矩阵或调度时,才应转向 advanced setup。
-
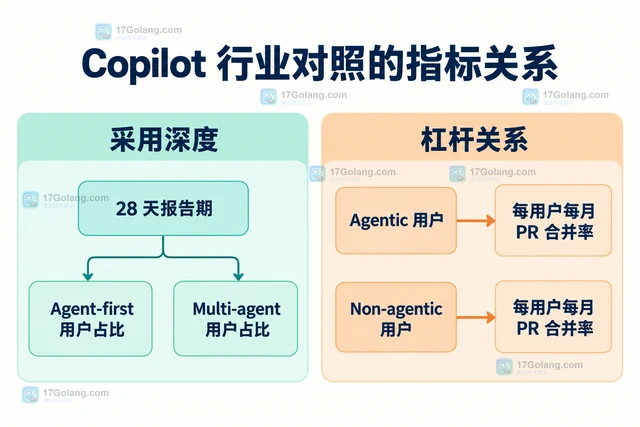
GitHub Copilot 影响面板新增行业对照后,管理员可以把 agentic adoption 和 leverage 放到同行语境中阅读。本文按入口、指标、样本、排名和退出路径说明如何避免误读。
-
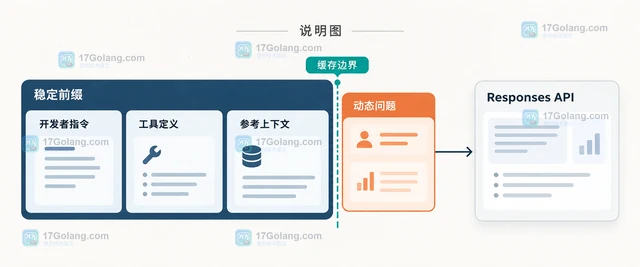
OpenAI API 在 Responses API 中加入 12 小时 prompt caching 选项。本文说明 ttl 配置、稳定前缀拆分、2.5 倍写入价格和 usage 监控方式,帮助开发者判断哪些调用适合迁移。
-
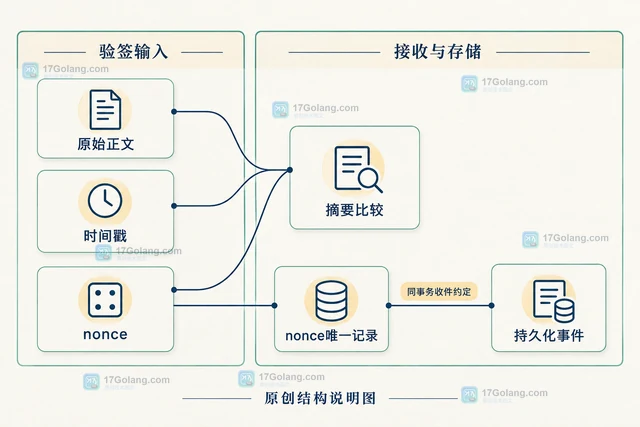
Label Studio 普通 webhook 可配置认证头,动态 HMAC 需另行实现。本文区分标注创建与任务完成,给出自建中继签名约定、原始正文校验及防重放与持久化边界。
-
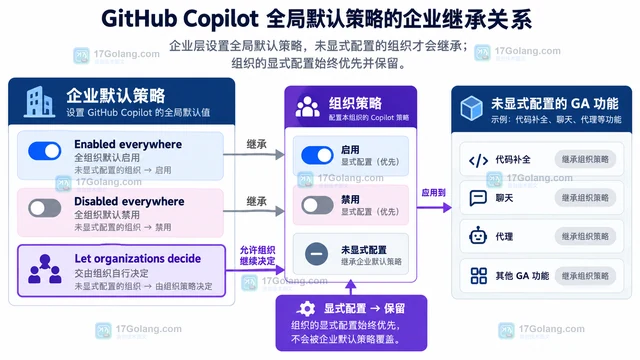
GitHub Copilot 全局默认策略从 2026 年 10 月 22 日起逐步生效。本文梳理企业与组织两级策略的继承关系,说明 GA、Preview、Unconfigured 和显式配置在 rollout 后分别会发生什么变化,并给出企业管理员的盘点清单。
-
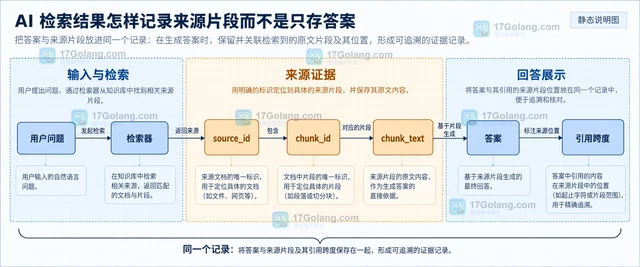
AI 应用不要只保存最终答案。本文用检索增强的常见数据模型说明如何保存 source_id、chunk_id、chunk_text、回答片段和支持关系,并结合 Gemini groundingMetadata 的 groundingChunks 与 groundingSupports 设计可追溯记录。
-
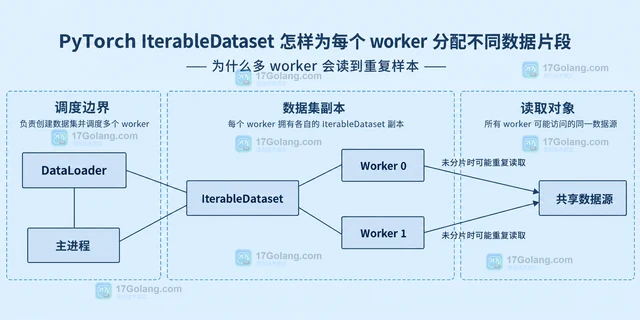
使用 PyTorch IterableDataset 配合 DataLoader 多 worker 时,数据集对象会复制到各个进程,直接迭代容易读到重复样本。本文用 get_worker_info 在 __iter__ 中计算半开区间,说明不整除、尾部数据和 drop_last 的边界。
-
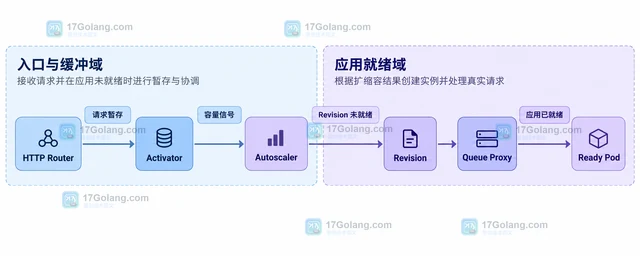
Knative 的 scale-to-zero 会把空闲成本降下来,也会把首请求等待带回设计现场。本文用一个低频报表 API 说明 Activator、Autoscaler、Revision 的请求关系,并比较 min-scale、activation-scale、scale-down-delay、stable/panic window 的职责边界。
-
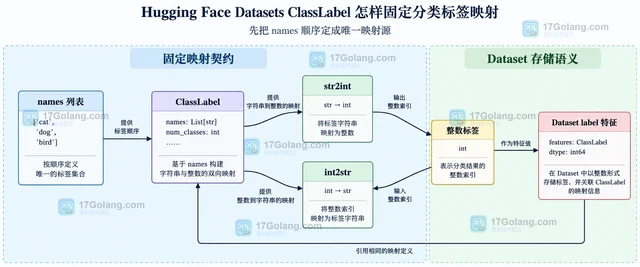
Hugging Face Datasets 的 ClassLabel 不应根据每个数据切片临时推导。本文用固定 names 顺序统一训练、验证和推理标签,并说明 map、cast_column、names_file、int2str 与 str2int 的边界。
-
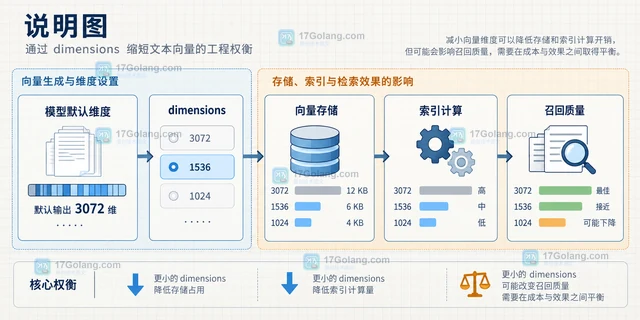
OpenAI embeddings 的 dimensions 不是越大越好。本文从默认维度、向量库限制、检索质量、存储与回滚几个方面,说明 text-embedding-3-small 和 text-embedding-3-large 怎样选择维度缩减参数。
-
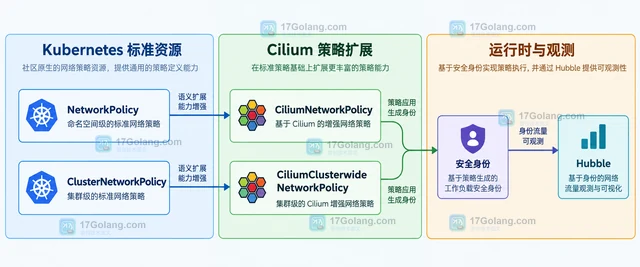
Cilium 1.20 扩展了 ClusterNetworkPolicy、Cluster Mesh 策略实体和 Gateway API 能力,但替换成本不只在 YAML 转换。本文按策略语义、身份、观测、跨集群、入口链路和回滚拆解评估方法。
-
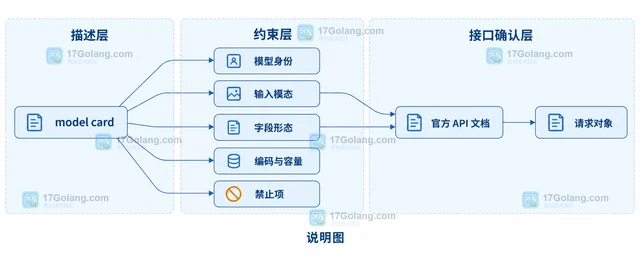
model card 更适合作为输入契约的索引,而不是可直接提交的接口 schema。本文按输入模态、字段形态、编码与容量、禁止项和已知局限拆读,再用官方 API 文档确认最终请求字段。
