-
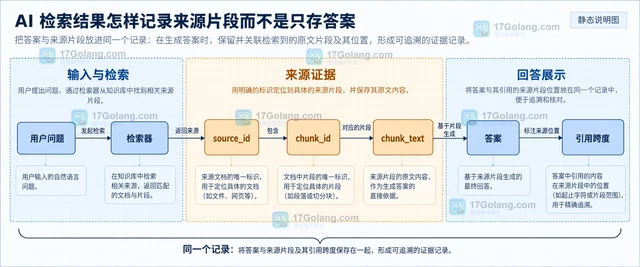
AI 应用不要只保存最终答案。本文用检索增强的常见数据模型说明如何保存 source_id、chunk_id、chunk_text、回答片段和支持关系,并结合 Gemini groundingMetadata 的 groundingChunks 与 groundingSupports 设计可追溯记录。
-
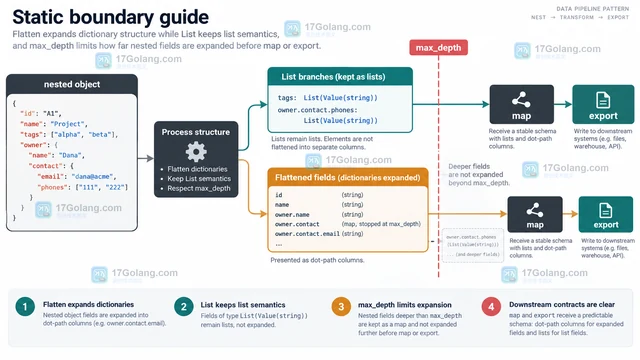
Hugging Face Datasets 的 flatten 会把嵌套字典字段展开为点号路径列,同时保留 Features 对字段类型的描述。本文用嵌套 struct、List 和 max_depth 说明如何安全接入后续 map 处理。
-
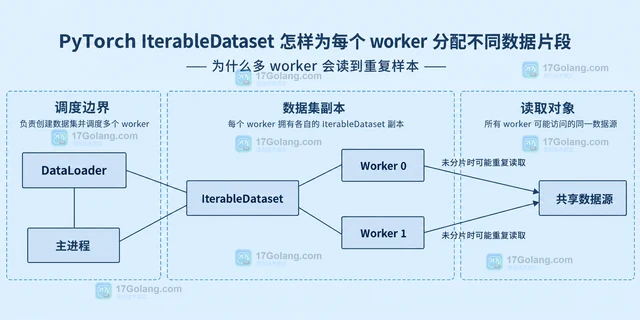
使用 PyTorch IterableDataset 配合 DataLoader 多 worker 时,数据集对象会复制到各个进程,直接迭代容易读到重复样本。本文用 get_worker_info 在 __iter__ 中计算半开区间,说明不整除、尾部数据和 drop_last 的边界。
-
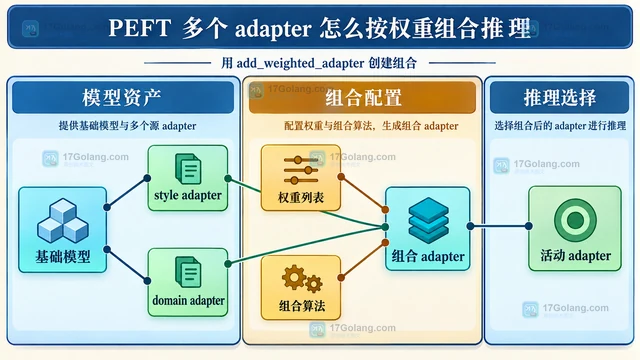
本文演示 PEFT 多个 LoRA adapter 的命名加载、加权组合与推理激活,说明 linear、cat、SVD、TIES 和 DARE 的选择边界及评测方法。
-
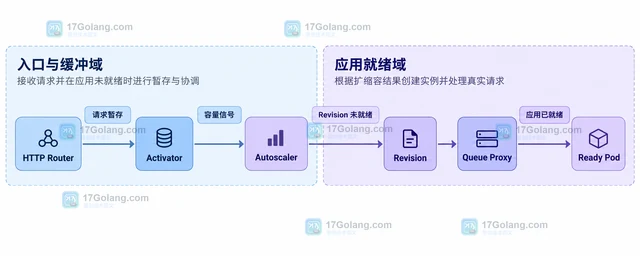
Knative 的 scale-to-zero 会把空闲成本降下来,也会把首请求等待带回设计现场。本文用一个低频报表 API 说明 Activator、Autoscaler、Revision 的请求关系,并比较 min-scale、activation-scale、scale-down-delay、stable/panic window 的职责边界。
-
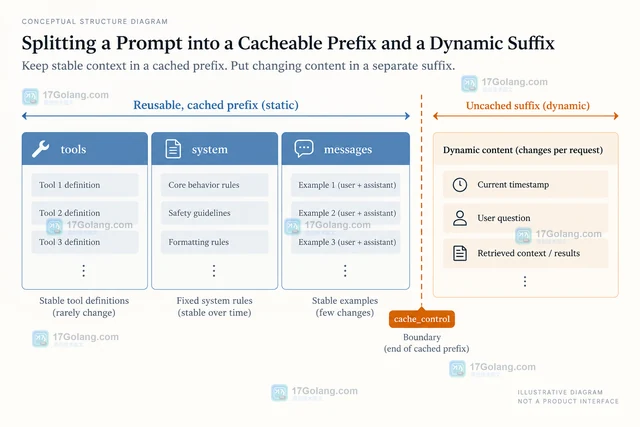
提示词缓存命中率低时,先把工具定义、系统规则和稳定上下文划为前缀,把时间戳、用户问题和检索结果留在后缀,再用 usage 字段判断断点、TTL、长度门槛和并发时序问题。
-
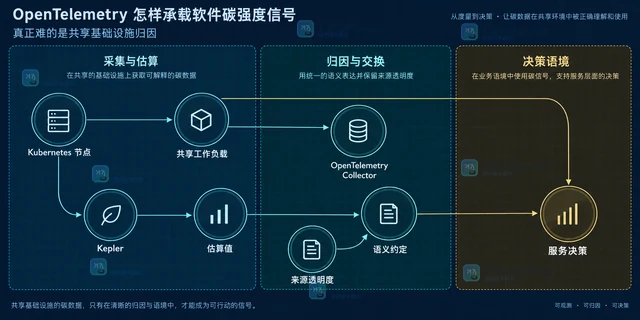
CNCF 近期讨论把 Software Carbon Intensity 与 OpenTelemetry 语义约定结合起来。本文区分 SCI 的测量对象、OpenTelemetry 的交换角色和共享基础设施归因难点,并给出当前可执行的观察路径。
-
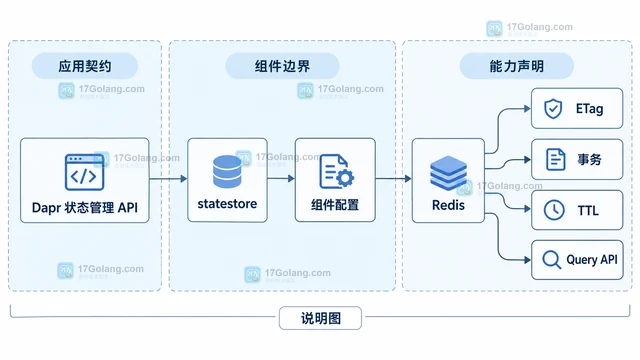
Dapr 把状态管理抽象成统一 API,但不同状态存储组件对事务、ETag、TTL 和查询能力的支持并不相同。本文从官方接口、组件配置和能力声明三层说明生态演进如何改变应用设计。
-
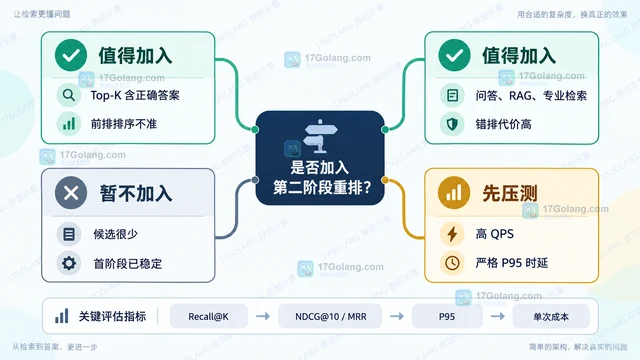
语义检索是否需要第二阶段重排,关键不在模型更强,而在第一阶段已能召回正确文档、前排仍错序且业务能承担额外时延。本文用 Recall@K、NDCG/MRR、P95 和单次成本给出决策与实现方法。
-
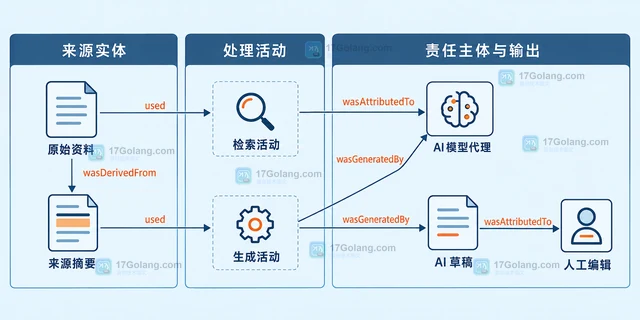
AI 生成内容要可追溯,关键不是只保存最终答案,而是把来源实体、检索与生成活动、模型和人工角色拆开记录,再用稳定 ID 串成可查询的引用链。
-
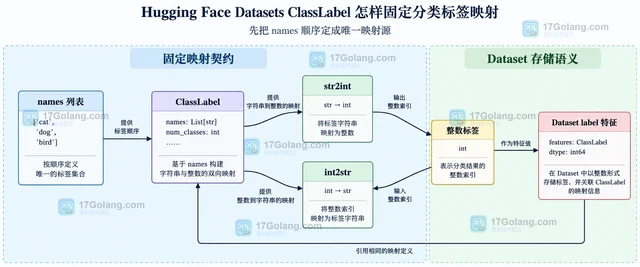
Hugging Face Datasets 的 ClassLabel 不应根据每个数据切片临时推导。本文用固定 names 顺序统一训练、验证和推理标签,并说明 map、cast_column、names_file、int2str 与 str2int 的边界。
-
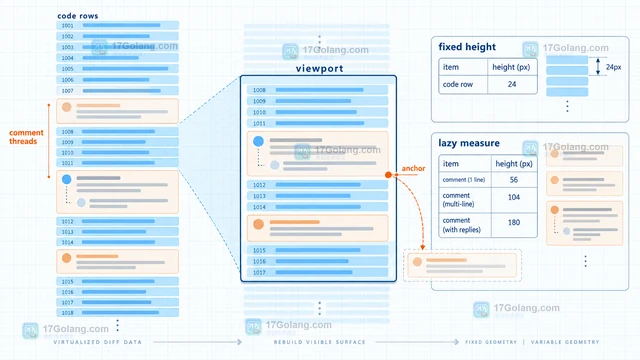
GitHub Blog 分享了 GitHub Copilot app 重建超大型拉取请求差异视图的方案:纯代码行使用虚拟化,评论线程采用延迟测量和锚定修正,数据管线按结构优先流式与视口懒构建推进,再用 headless probe 和真实桌面自动化验证滚动、评论和内存表现。
-
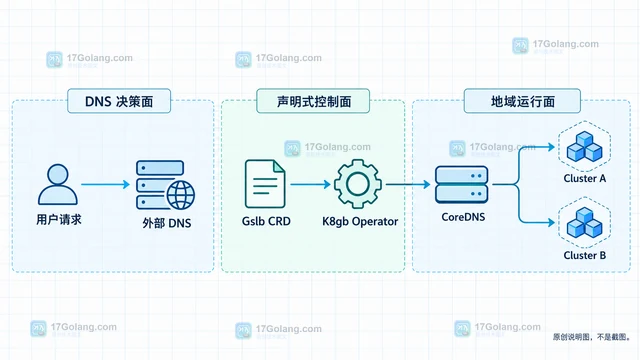
CNCF 于 2026 年 8 月宣布 K8gb 进入孵化阶段。本文从项目状态、Gslb CRD、Operator、DNS 健康检查和跨地域试点边界出发,说明它适合解决什么问题,以及采用前需要确认哪些条件。
-
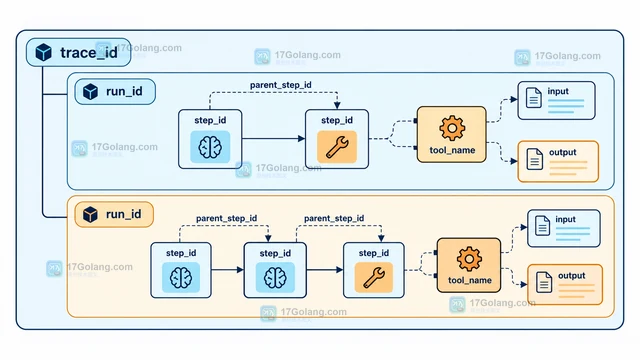
从 trace、run、step 三层标识出发,设计 AI Agent 工具调用轨迹,保存输入输出与版本上下文,并用夹具和沙箱划清安全回放边界。
-
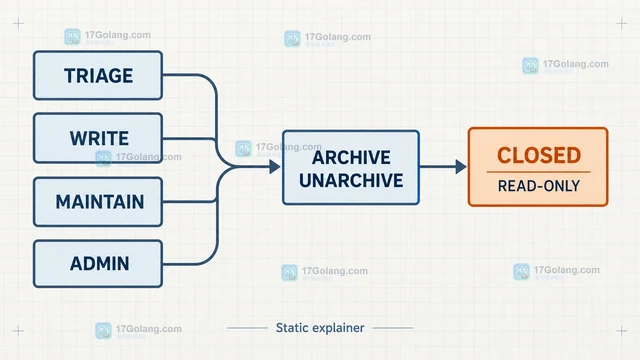
GitHub 将拉取请求归档权限扩大到 Triage、Write、Maintain 和 Admin 角色。本文说明归档后的关闭、只读、可见性和取消归档边界,帮助团队把垃圾、重复或废弃 PR 的整理工作交给合适的协作者。
