-
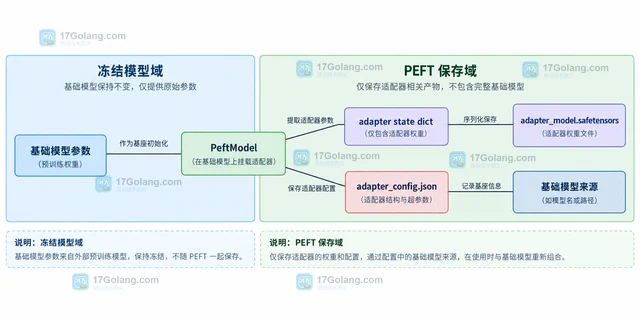
PEFT 的 save_pretrained 默认只保存 adapter 配置和增量权重,不会把冻结的基础模型一起复制。本文说明多 adapter 的 selected_adapters、embedding 层保存开关、重新加载边界,以及 Trainer checkpoint 与完整模型的区别。
-
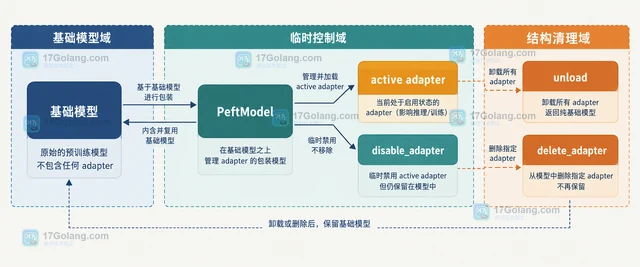
PEFT 中临时禁用 adapter、移除 LoRA 模块、删除命名 adapter 和合并权重是四种不同操作。本文用 unload 返回基础模型,说明为什么必须接住返回值,并整理多 adapter 与 Notebook 重跑时的排查边界。
-
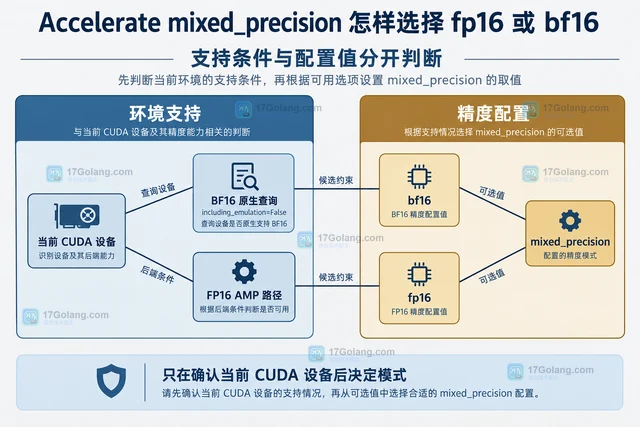
Accelerate 的 fp16 与 bf16 应按当前设备支持和模型数值行为选择。本文限定普通单卡 CUDA 场景,说明保守 BF16 查询、完整参数接入、梯度缩放与 no 模式对照,不以启动成功代替训练稳定性判断。
-
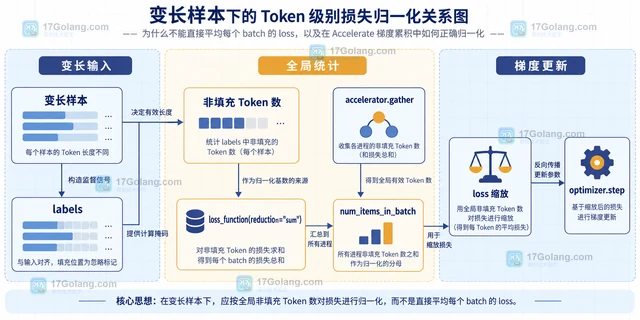
显存有限时,Accelerate 可以用 gradient_accumulation_steps 把多个 micro-batch 合成一次参数更新。本文说明 Accelerator、accumulate(model)、scheduler 与变长 token loss 归一化的配置边界。
-
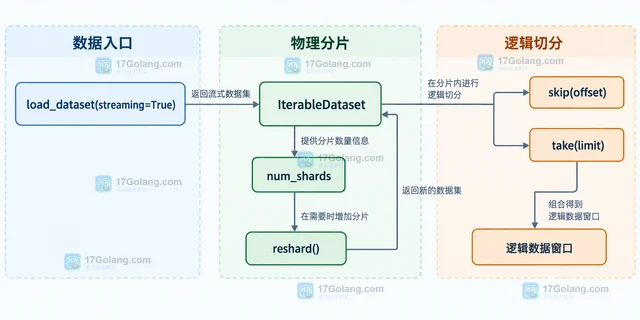
Hugging Face Datasets 的 IterableDataset 如果 reshard 后仍只有一个 shard,继续调用物理分片并不能解决切分问题。正确做法是先完成 shuffle,再用 skip 和 take 构造逻辑窗口,并明确 offset、limit、短流和重复遍历的边界。
-
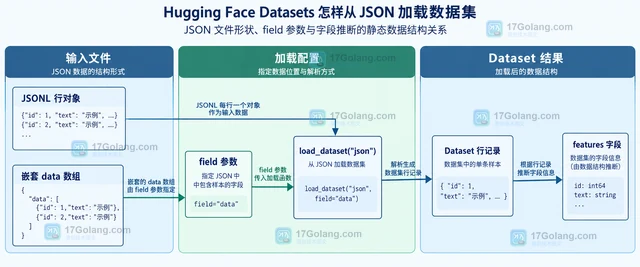
Hugging Face Datasets 读取 JSON 的关键是先判断根结构:JSONL 通常直接加载,嵌套数组要用 field 指向数据字段;多个文件则用 data_files 映射到 train、validation 等 split。本文给出最小写法、字段推断观察方式和常见排错边界。
-
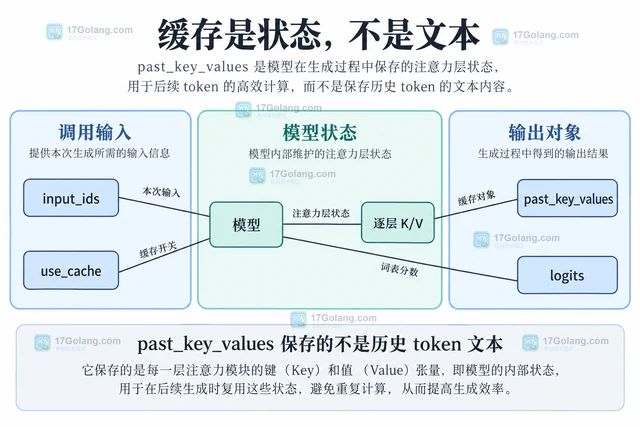
Transformers 的 past_key_values 保存已处理上下文的逐层 K/V,use_cache 控制缓存输出。本文用 GPT-2 原创示例解释新增 token、完整掩码与缓存长度的配合,并说明对象复用和内存边界。
-
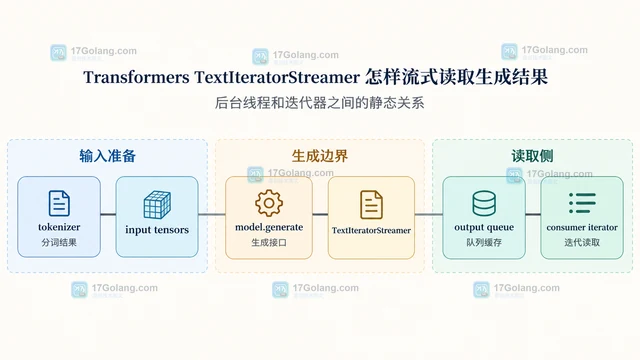
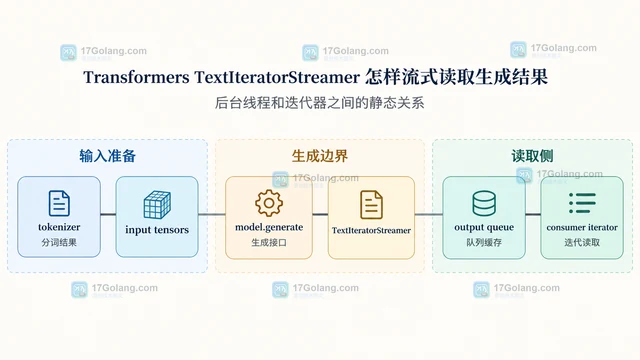
Transformers 的 TextIteratorStreamer 可以把 model.generate 放在独立线程中,再由消费端逐段迭代生成文本。本文按线程、队列、提示词、超时和异常边界说明一套可维护的写法。
-
Transformers 的 chat template 不是装饰性格式,而是模型训练时使用的控制 token 约定。本文只围绕 apply_chat_template,说明 role/content 消息结构、推理与训练参数、特殊 token 重复和不同模型模板不兼容时的处理方式。
-
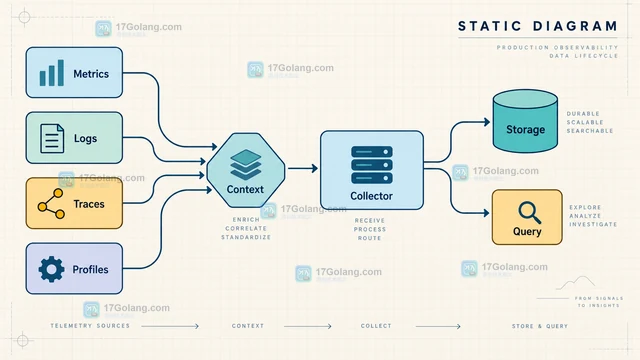
Observability Day 2026 将维护者、运营者和终端用户放在同一场景中,讨论日志、指标、追踪、数据质量、成本与事件响应如何组成生产可观测性闭环。
-
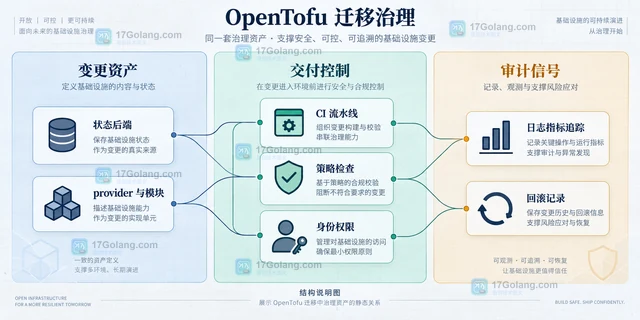
OpenTofu Day 2026 将基础设施即代码的讨论从工具选择推进到供应边界、迁移治理、生产规模化和可观测性。本文根据 CNCF 官方资料拆解会议关注的问题,并给出适合团队评估的 PoC 清单。
-
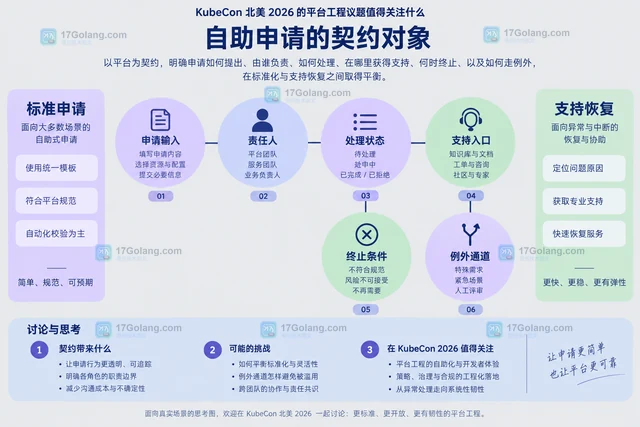
KubeCon 北美 2026 的平台工程讨论涉及自助能力、平台产品化与AI带来的责任边界。本文按平台团队、开发者和SRE整理关注点,以发布申请场景说明契约、例外和兼容策略。
-
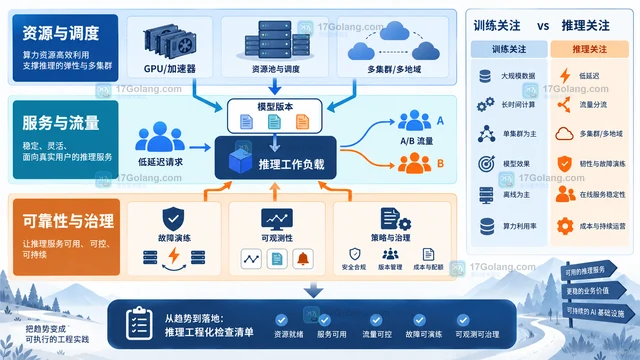
CNCF 与 SlashData 的报告把 AI 团队从数据管道、训练实验推进到生产推理。本文用一个最小推理平台清单,拆分资源调度、服务流量和可靠性治理三层,帮助工程团队判断哪些趋势值得落成基础设施工作。
-
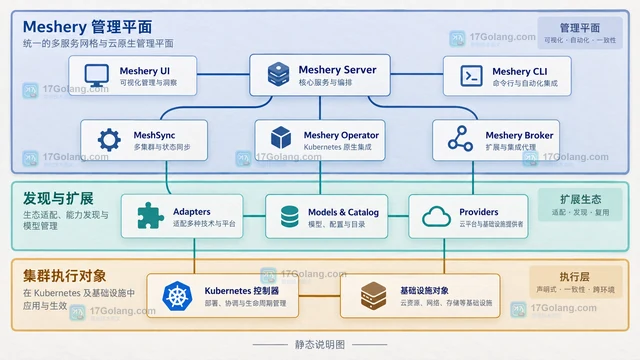
CNCF 接纳 Meshery 为孵化项目,说明它在云原生管理平面、社区治理和生态扩展上进入新的成熟度阶段,但不等于自动适合所有生产环境。本文从项目定位、接入信号、回退边界和运维复盘四个角度给出判断方法。
-
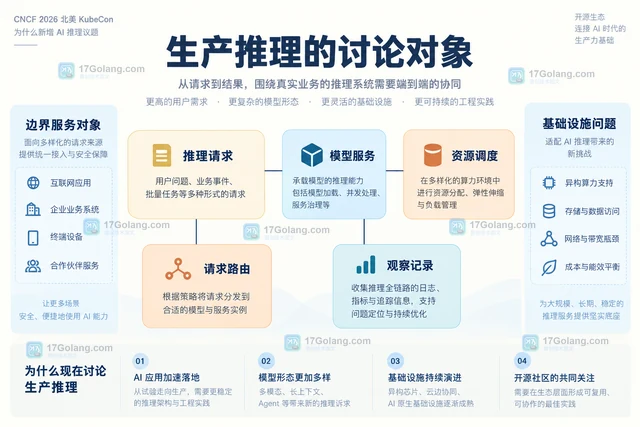
CNCF 2026 北美 KubeCon 新增 AI Inference + Agentic 专题,关注生产推理与 Agent 工作流。本文区分议程事实与工程判断,说明资源调度、请求观察和任务边界的学习重点。
