
Go语言技术文章
-
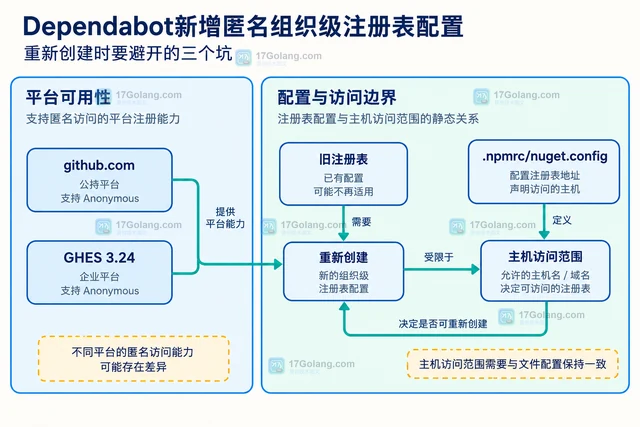 GitHub 为 Dependabot 组织级私有注册表新增 Anonymous 认证方式。本文说明它适合什么镜像、覆盖哪些仓库、如何重新创建配置,以及 github.com 与 GHES 3.24 的可用边界。189 收藏
-
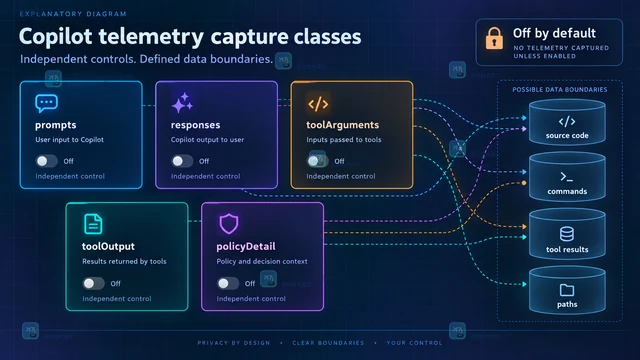 GitHub Copilot 客户端遥测新增用户归属与细粒度采集控制,身份捕获与五类内容捕获相互独立且默认关闭;本文梳理三个身份属性、五类内容边界和托管设置优先级。104 收藏
-
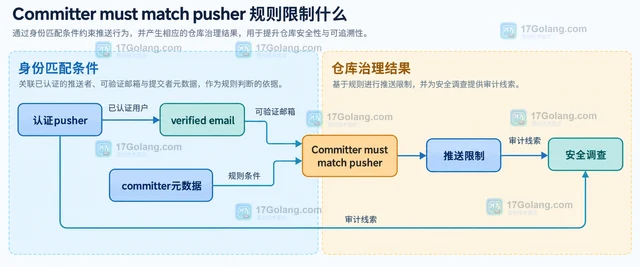 GitHub 公布推送归属 limited public preview:每个提交会附带经认证的 pusher 身份,并可用 Committer must match pusher 规则限制身份伪造。485 收藏
-
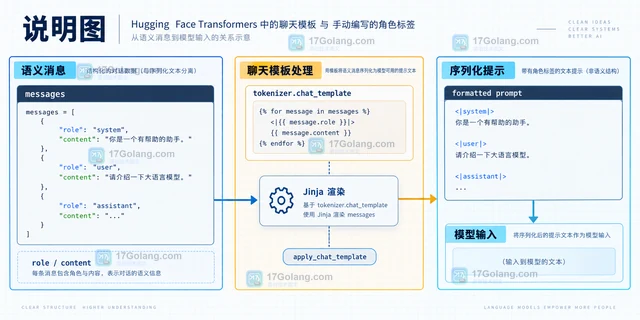 从 role/content 消息、Jinja 聊天模板、助手生成边界和特殊 token 四个方面,说明 Transformers 模板调用与手写角色标签的兼容条件。492 收藏
-
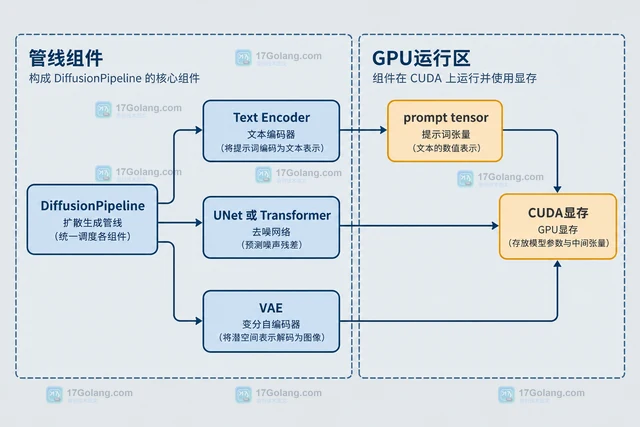 Diffusers直接放入GPU通常速度更快但显存峰值更高,CPU卸载能降低常驻显存却增加设备搬运。本文对比两种方式及model级、sequential级卸载的选择边界。338 收藏
-
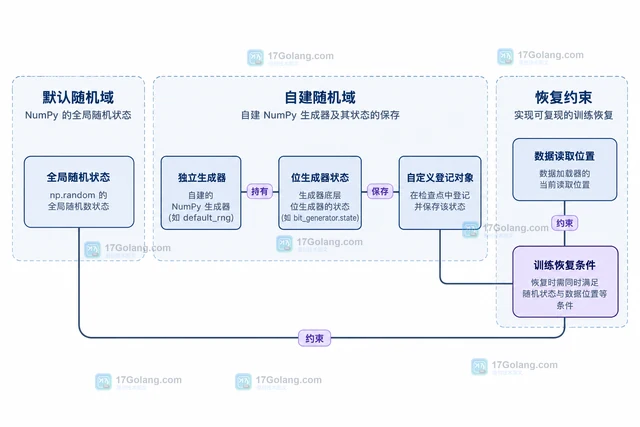 用Accelerate的save_state与load_state保存和恢复训练随机数状态,通过epoch边界示例说明加载时机、自建生成器登记和数据位置区别,避免将固定seed误当断点恢复。326 收藏
-
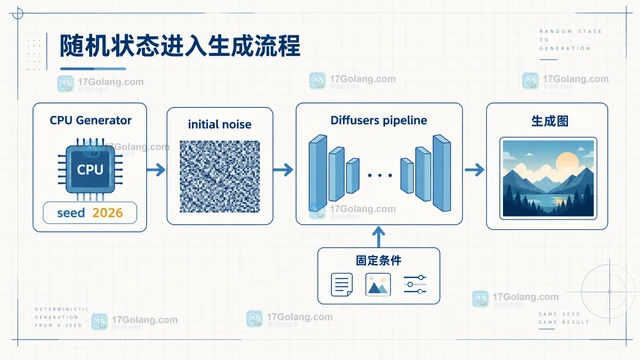 Diffusers 生成结果每次不同,通常与随机状态和采样条件有关。本文用 CPU torch.Generator 说明怎样固定初始噪声、每次重新播种,并整理模型、提示词、步数和调度器的复现清单。118 收藏
-
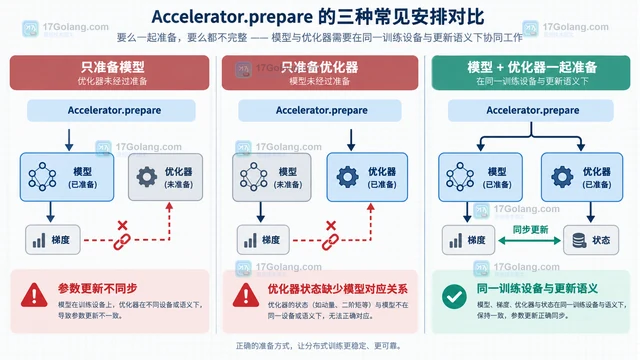 Accelerator.prepare 不只是把模型搬到设备上;训练时模型包装、参数位置、优化器参数组和状态必须保持一致,所以通常要把模型与优化器一起交给 Accelerate 准备。本文用最小训练骨架说明对象顺序、调度器和推理场景的边界。386 收藏
-
科技周边 · 人工智能 | 1天前 | 人工智能 · Hugging Face Datasets streaming IterableDataset Dataset.shuffle shuffle buffer
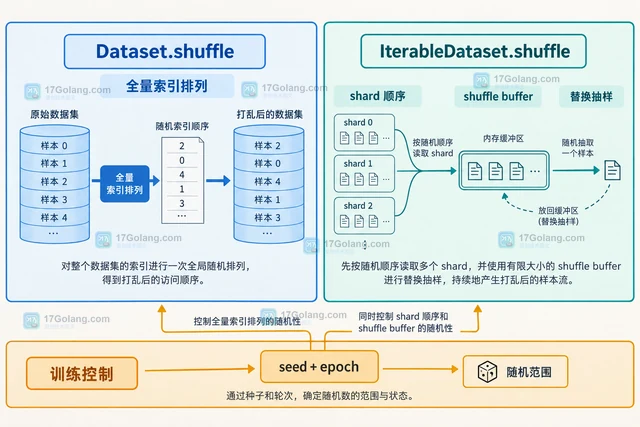 Hugging Face Datasets 的 Dataset.shuffle 会为内存数据集建立全量索引映射,IterableDataset.shuffle 则通过 shard 顺序和有限 shuffle buffer 做近似随机。本文解释两者的访问模型、随机范围、性能代价与训练参数选择。130 收藏
-
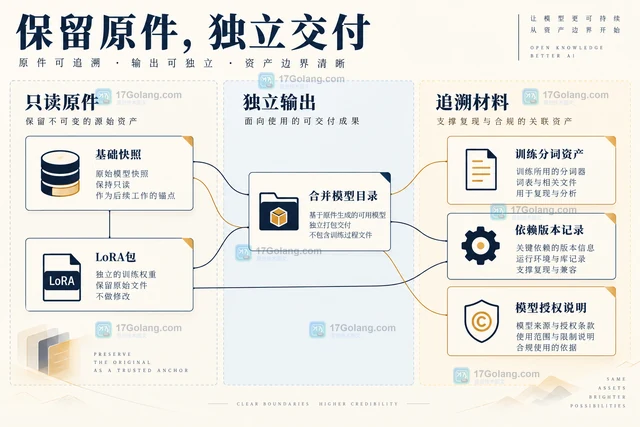 从文件职责、配置来源和参数命名区分LoRA适配器与基础模型,说明单适配器合并的适用范围、独立输出目录及回滚材料,避免把适配器误当完整模型交付。174 收藏
-
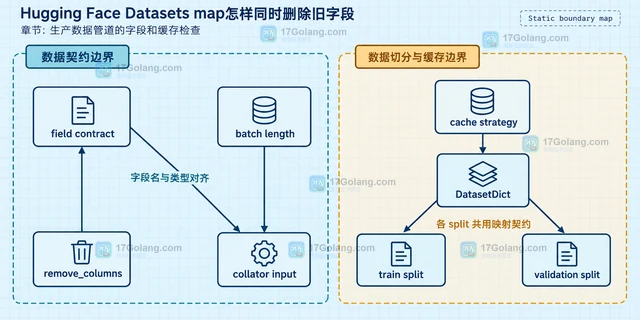 Hugging Face Datasets 用 map 转换样本时,可以通过 remove_columns 一次删除多个旧字段。本文说明单条与批量映射、同名覆盖、DatasetDict 和缓存边界。421 收藏
-
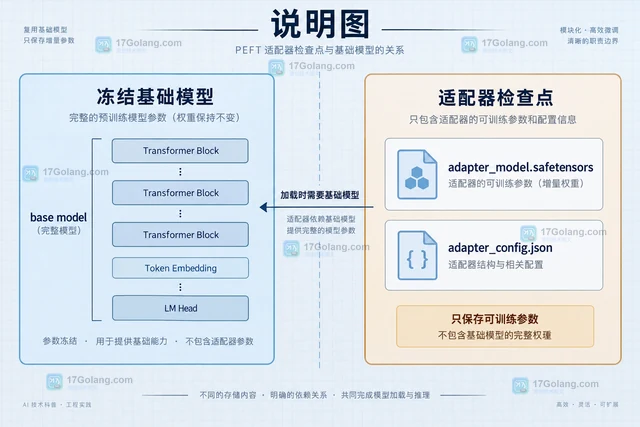 使用 Hugging Face PEFT 训练适配器后,检查点通常只包含适配器权重和配置,不会复制完整基础模型。本文从目录现象出发,说明保存设计、恢复加载、继续训练与合并导出的区别。301 收藏
-
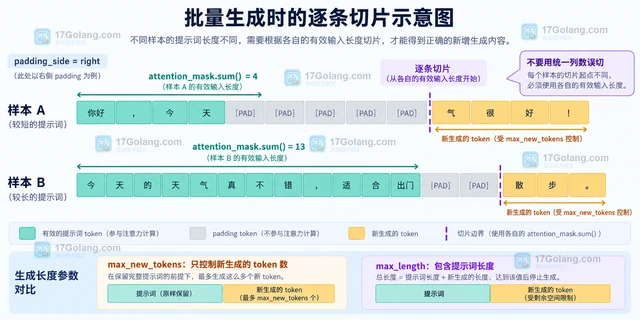 Transformers 的 generate 返回完整序列时,GPT 类 decoder-only 模型会把输入提示词和新增 token 一起返回。本文用 token 长度切片、批量 padding 和 max_new_tokens 说明如何稳定取出真正生成的文本。111 收藏
-
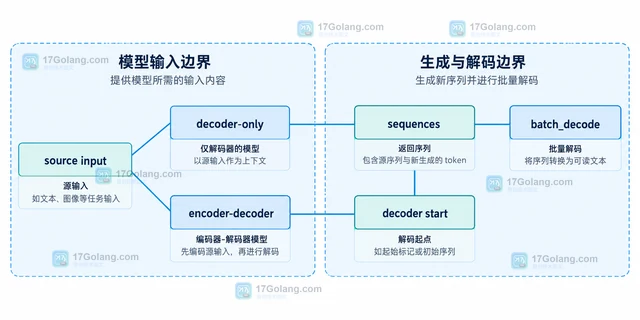 讲清 Transformers generate 返回完整序列的原因,分别处理 decoder-only 与 encoder-decoder 模型,用输入长度切出新生成 token,并给出批量解码、特殊 token 和空结果的处理方式。461 收藏
-
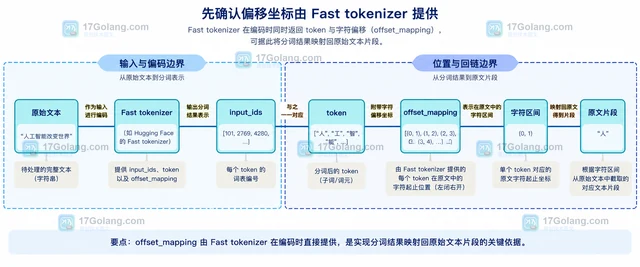 使用 Transformers Fast tokenizer 的 offset_mapping 把 token 位置还原为原始文本片段,并处理特殊 token、批量溢出、成对输入与预分词边界。330 收藏