-
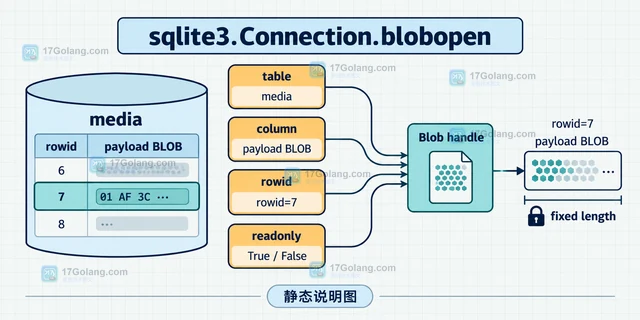
Python 的 sqlite3.Connection.blobopen 可以打开已有 SQLite BLOB,按偏移读取或写入固定长度数据。本文说明怎样用 zeroblob 预留空间,正确处理 readonly、事务提交和 Blob 句柄关闭。
-
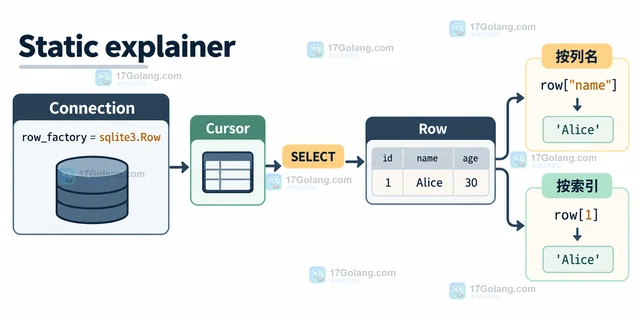
Python sqlite3 默认返回元组,按列名读取需要在连接创建游标前设置 row_factory = sqlite3.Row。本文说明 row、列别名、空结果、已有游标与重复列名的边界,并给出可迁移的读取写法。
-
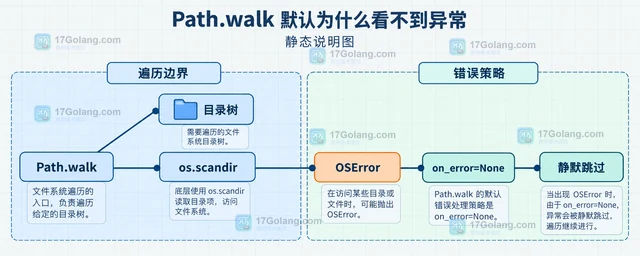
Python pathlib.Path.walk 默认会忽略目录扫描产生的 OSError。本文说明怎样用 on_error 接收异常,读取 filename,并按 PermissionError 等错误类型决定记录后继续还是重新抛出。
-
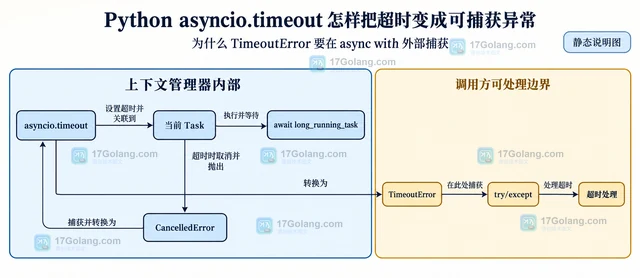
Python asyncio.timeout 的关键是捕获位置:上下文内部先取消当前任务,退出上下文后才转换为 TimeoutError。本文用运维排障视角说明正确结构、CancelledError 区分、阻塞代码边界和动态 deadline 用法。
-
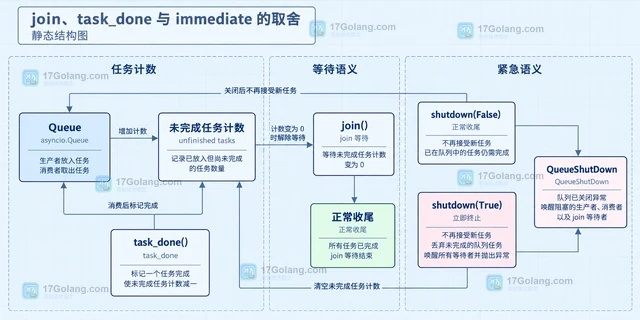
Python 3.13 新增的 asyncio.Queue.shutdown 可以让生产者停止入队、消费者处理完已有任务后退出。本文解释 shutdown(False) 与 shutdown(True) 的差异,以及 QueueShutDown、task_done 和 join 的正确配合。
-
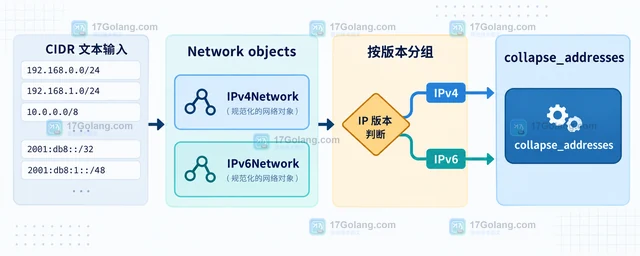
Python 标准库 ipaddress.collapse_addresses 可以把同一 IP 版本的网络对象按 CIDR 边界折叠,去掉重复和被覆盖的范围。本文从输入转换、连续网段合并、IPv4/IPv6 分组和输出物化几个步骤说明如何避免混合版本、未对齐边界与迭代器被消费的问题。
-
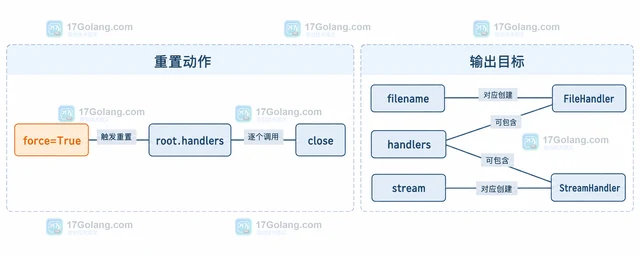
Python logging.basicConfig 在根 logger 已有 handler 时可能不再生效。本文说明 force=True 的重置范围、参数冲突和适用时机。
-
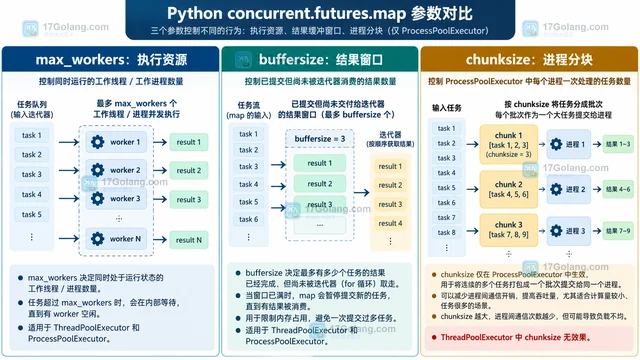
Python 3.14 为 concurrent.futures.Executor.map 增加 buffersize,用来限制已提交但尚未交付结果的任务窗口。本文结合慢任务和长输入,说明它与 max_workers、chunksize、按序消费、异常和版本兼容的区别。
-
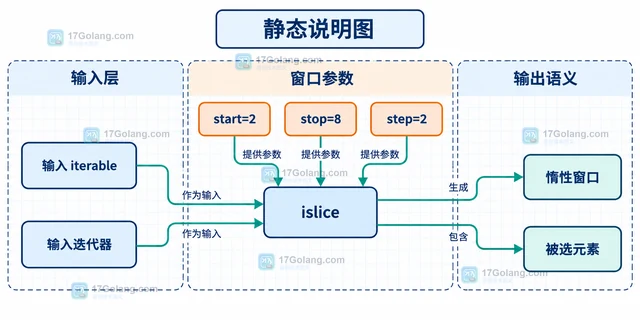
Python itertools.islice 可以像切片一样表达 start、stop、step,却不会先把整个迭代器转换成列表。本文用生成器和日志窗口说明惰性截取、参数边界、输入消费位置,以及它与列表切片的选择差异。
-
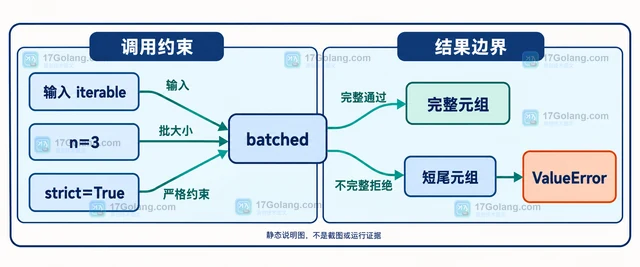
Python itertools.batched 默认会保留末尾不足 n 个元素的短元组;如果业务必须整组处理,可以使用 Python 3.13 引入的 strict=True,让不完整尾组直接抛出 ValueError。
-
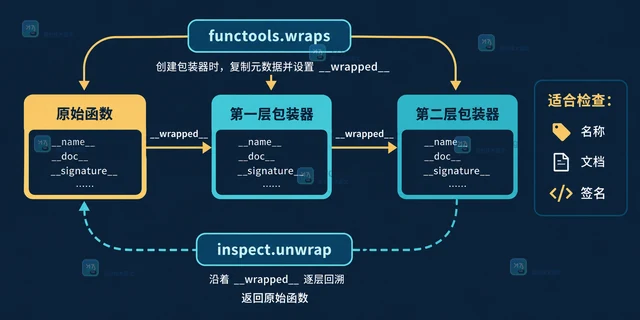
Python 装饰器直接返回 wrapper 时,函数名称、文档字符串和注解可能被包装器遮住。本文用 functools.update_wrapper 和 wraps 说明默认复制字段、自定义属性边界、__wrapped__ 链及 inspect.unwrap 的使用方式。
-
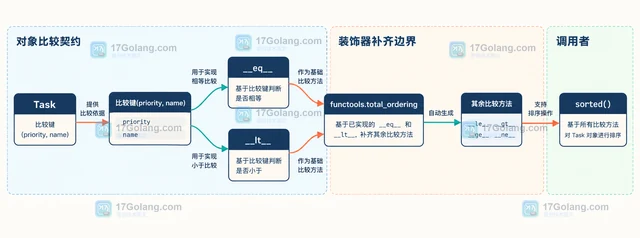
为自定义对象实现排序时,Python functools.total_ordering 可以根据 __eq__ 和一个排序比较方法补齐其余比较运算。本文用一个可排序任务对象说明比较键、NotImplemented、继承边界与性能取舍。
-
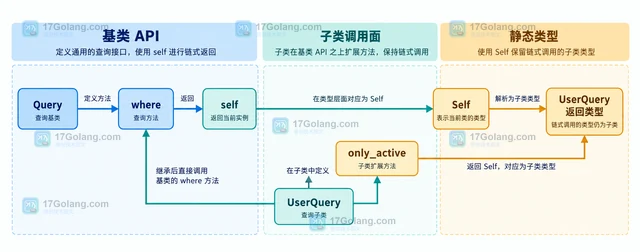
Python typing.Self 适合标注返回当前实例的链式方法,也能用于随 cls 创建同类实例的 classmethod。本文结合继承、上下文管理器和固定返回基类的反例,说明如何选择准确的返回类型。
-
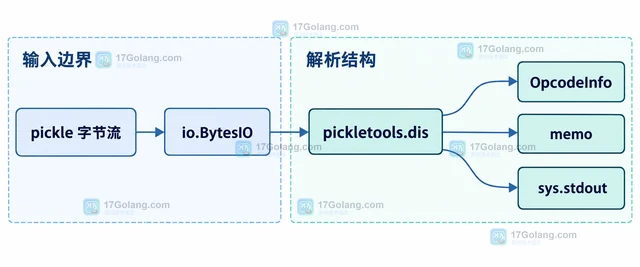
排查 pickle 文件时,pickletools.dis 可以把字节流展开成可读的协议操作码,而不需要先恢复 Python 对象。本文介绍命令行、dis、genops、memo 与输出控制,并说明不可信数据不能直接反序列化。
-
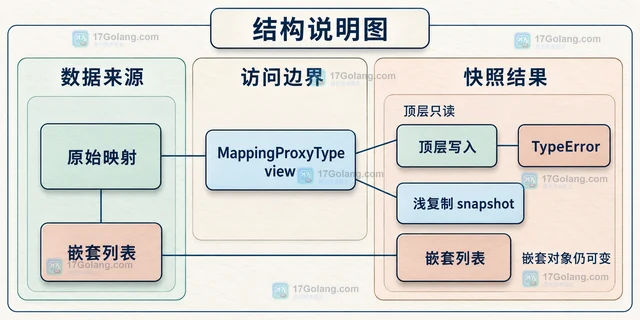
Python types.MappingProxyType 可以把已有映射包装成只读视图:调用方不能直接写入,但底层字典的合法变化仍会被视图看到。本文用配置暴露示例说明创建方式、动态可见性、浅复制区别与嵌套对象边界。
