-
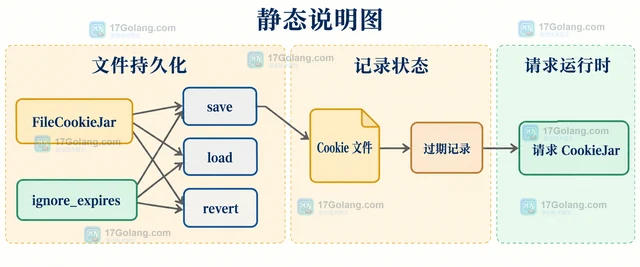
Python CookieJar 会在运行时按 Cookie 的 expires 等属性过滤过期 Cookie,而 ignore_expires 只影响 FileCookieJar 的保存、加载和恢复。本文拆开两条路径,说明如何保留过期记录用于迁移或排查,以及为什么它不会强制请求发送过期 Cookie。
-
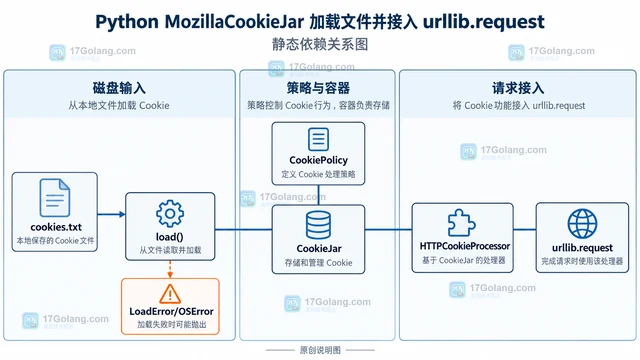
用 Python 标准库 MozillaCookieJar 把 Cookie 保存为 Mozilla cookies.txt 文件,并说明 save、load、会话 Cookie、过期 Cookie、覆盖写入和 urllib.request 接入时的边界。
-
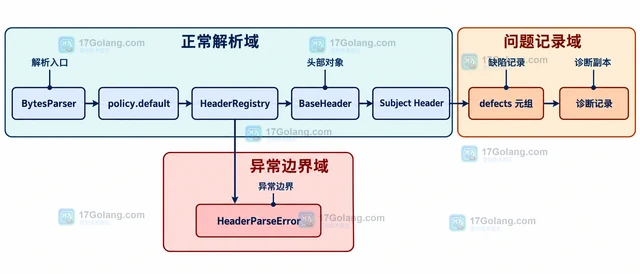
Python email.headerregistry 会把邮件头解析时发现的 RFC 合规问题放进 Header.defects。本文用 BytesParser 和 policy.default 演示如何读取字段级与消息级缺陷,转换为可落盘诊断记录,并区分缺陷与真正的 HeaderParseError。
-
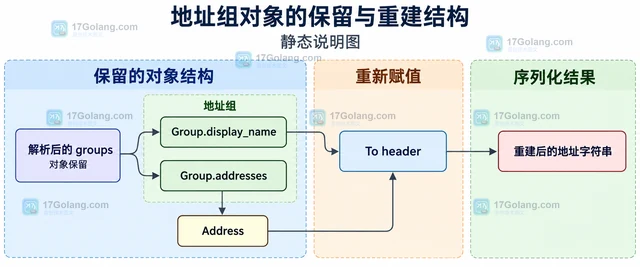
Python email.headerregistry 解析地址头时,groups 保留地址组名称与组内收件人结构,addresses 则会把地址展平。本文用 HeaderRegistry、Group 和 Address 演示如何读取、复制和重建地址组,并说明空组与单地址的边界。
-
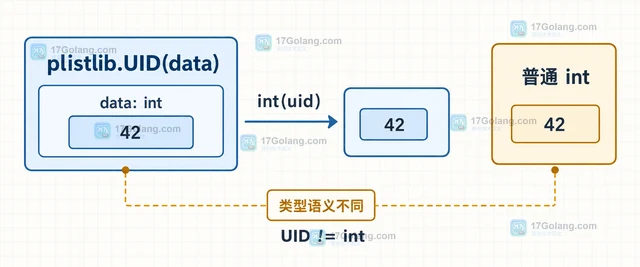
plistlib.UID 不是普通 int 的别名,而是为二进制 plist 保留 UID 类型语义的包装对象。本文用一个小工具说明类型判断、数值转换、写回格式和兼容边界。
-
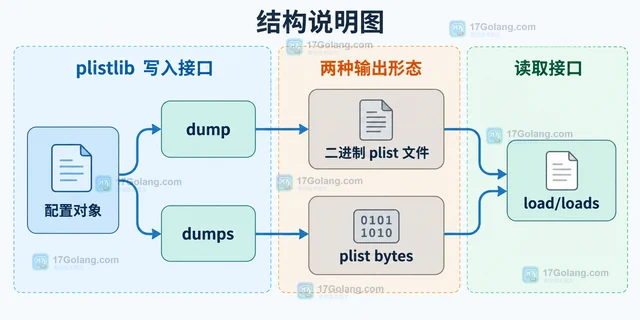
Python plistlib 默认写出 XML plist;本文说明如何使用 FMT_BINARY 生成二进制 plist,并比较 dump 与 dumps、固定字符串键、排序策略以及 TypeError 和 OverflowError 的处理边界。
-
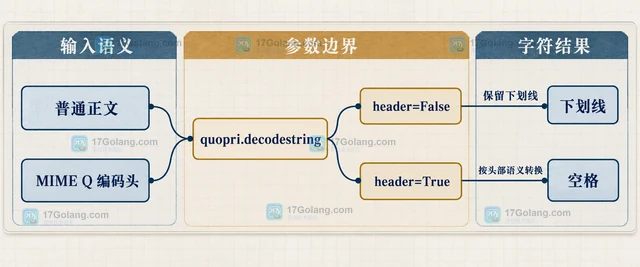
解释 Python quopri 的 header=False 与 header=True 为什么对下划线产生不同结果,并区分普通正文、MIME Q 编码头和完整邮件头的正确处理方式。
-
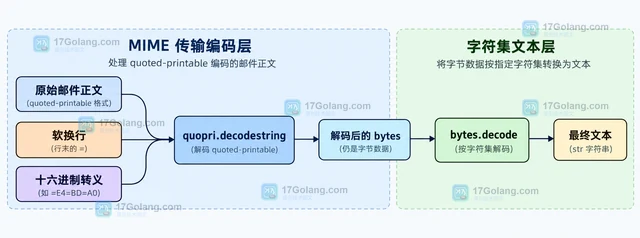
Python quopri 可以把 quoted-printable 邮件正文还原为原始字节,并自动处理等号软换行。本文区分内存解码、流式解码、字符集转换和 header 参数的使用边界。
-
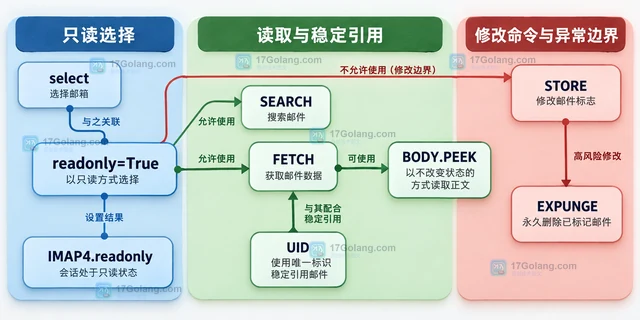
使用 Python imaplib 选择邮箱时传入 readonly=True,可以在读取邮件、搜索和统计时避免修改当前邮箱的标记与删除状态。本文还说明 TLS 连接、返回值、UID 和 readonly 异常的边界。
-
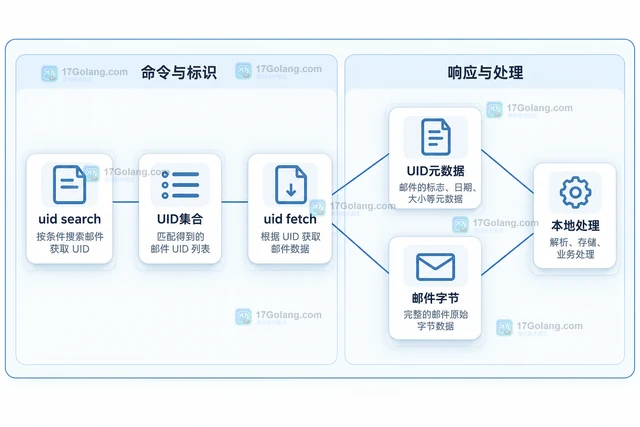
Python imaplib 获取邮件时,应同时使用 UID SEARCH 与 UID FETCH,并将账号、邮箱、UIDVALIDITY 和 UID 作为身份范围。本文给出只读示例,说明响应序号、邮件消失与批处理检查点的边界。
-
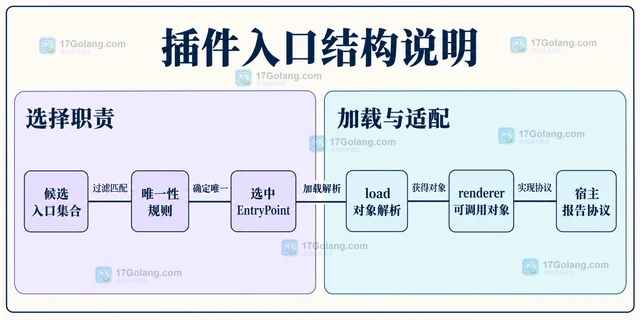
Python importlib.metadata.entry_points 可通过 group 选择插件入口,再按 name 精确筛选。本文以报告渲染器说明元数据发现、唯一候选加载、pyproject 声明,以及空结果、重名和接口错误的处理。
-
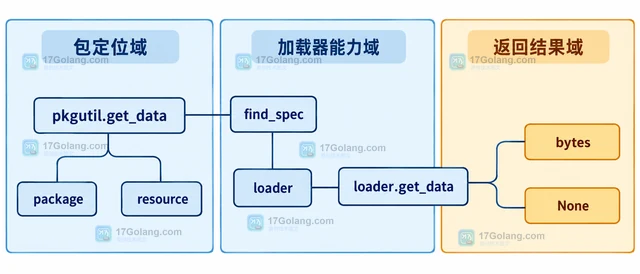
Python pkgutil.get_data 遇到不支持资源读取的加载器时返回 None,而不是空字节串。本文从包定位、loader.get_data 能力和命名空间包边界出发,说明如何处理 None,以及在不同打包方式下如何选择资源访问方案。
-
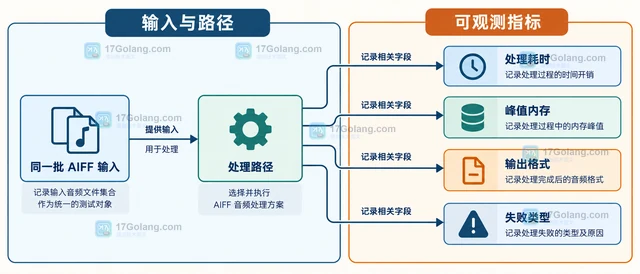
Python 3.13 起不再提供 aifc。需要读取 AIFF 并进入 NumPy 数组时选 soundfile,需要多格式转码时选 FFmpeg,需要短脚本剪切拼接时可用 pydub,但它仍依赖 FFmpeg。本文按任务边界、依赖、耗时和内存指标给出迁移选择。
-
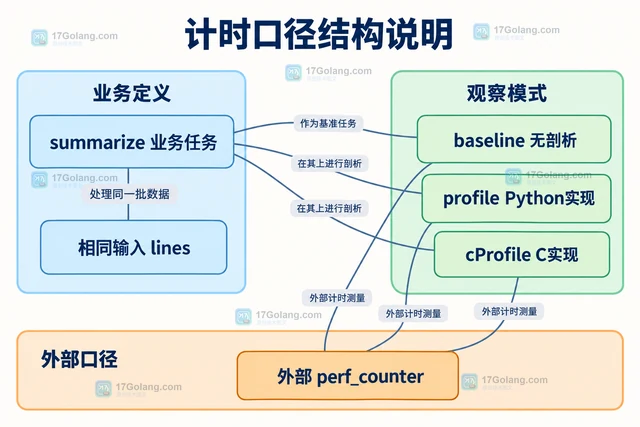
profile 的纯 Python 实现通常比 cProfile 带来更明显的剖析开销。本文以同一文本汇总任务解释外部耗时与报表统计的区别,提供三模式观察脚本和无剖析计时方法,不预设固定减速倍数。
-
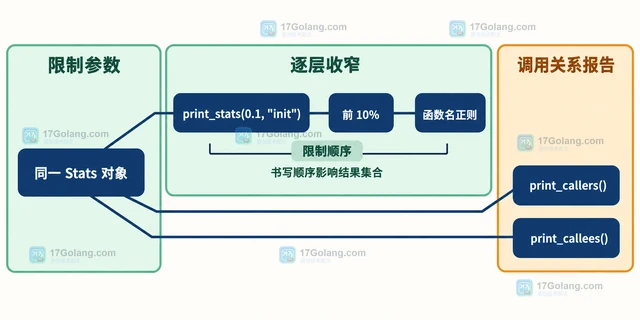
Python pstats 用 sort_stats() 决定性能报告的排序方式,再用 print_stats() 按数量、比例或函数名限制显示内容;多个限制会按书写顺序依次收窄。
