-

Redis HRANDFIELD 适合从 Hash 中抽取随机字段。本文用 redis-cli 核对单字段、COUNT、WITHVALUES、负数 COUNT、空键和重复结果,避免把随机读取误当成去重抽样。
-

Redis BITFIELD 适合把多个小整数压进一个字符串,但积分计数一旦选错位宽或溢出策略,结果可能悄悄回绕。本文用积分桶示例拆开 GET、INCRBY、OVERFLOW 的边界,并给出可重复的验收命令。
-
PSUBSCRIBE性能瓶颈源于PUBLISH时线性遍历所有pattern做glob匹配。无索引、无缓存、无短路,pattern越多越慢;大小写敏感且*不匹配空字符串,易误配;超20个pattern或100qps即引发CPU毛刺。
-

根本原因是Redis集群要求多键操作的key必须位于同一slot,而HashTag(如{user:1}:profile)通过仅哈希花括号内内容实现强制同槽,但需命令本身支持多key且全链路保留括号语义。
-

Redis和HBase可以协同工作,发挥各自优势。1)使用Redis处理实时数据和缓存,如用户行为数据。2)利用HBase存储和分析历史数据,如用户购买习惯。通过这种方式,可以实现快速访问和长久存储的平衡。
-

Redis启动后无法访问的原因主要包括配置文件问题、网络问题、防火墙设置和内存不足。解决方案如下:1.调整配置文件,确保绑定地址和端口正确;2.修复网络连接,确保Redis服务器和客户端连接正常;3.调整防火墙规则,允许Redis端口访问;4.增加内存或调整Redis配置,确保内存充足。
-

最佳实践是使用Docker部署Redis时,应注意数据持久化、配置管理、网络配置和性能优化。1.使用Docker命令启动Redis容器:dockerrun--namemy-redis-p6379:6379-dredis。2.配置数据持久化:dockerrun--namemy-redis-p6379:6379-v/path/to/host/data:/data-dredis。3.定制Redis配置:dockerrun--namemy-redis-p6379:6379-v/path/to/host/conf/
-

常用的Redis性能监控工具包括Redis自带的INFO命令、慢查询日志、RedisInsight、Prometheus和Grafana组合以及Redis-benchmark。1.INFO命令适合快速诊断问题,但数据粒度较粗。2.慢查询日志有助于优化性能,但配置需谨慎。3.RedisInsight提供直观的监控和分析功能,但需考虑资源消耗。4.Prometheus和Grafana组合适用于大规模集群监控和长期趋势分析,部署复杂。5.Redis-benchmark用于测试性能极限,需结合实际业务场景分析。
-

在灾难恢复场景下,快速重建Redis数据的最佳方案是使用RDB快照结合AOF日志的混合策略。首先,从最近的RDB快照恢复数据,然后应用AOF日志中的操作,以减少数据丢失并加快恢复速度。
-

场景设定1、我们需要将POJO存储到缓存中,该类定义如下public class TestPOJO implements Serializable {
private String testStatus;
privat
-
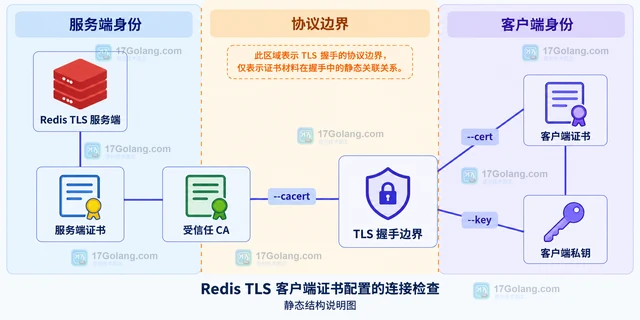
Redis 启用双向 TLS 后,客户端不只要打开 --tls,还要正确提供受信任 CA、客户端证书和对应私钥。本文从 redis-cli 到 Go tls.Config,给出一套不暴露真实凭据的连接检查方法,并按错误位置区分证书、握手和 ACL 问题。
-
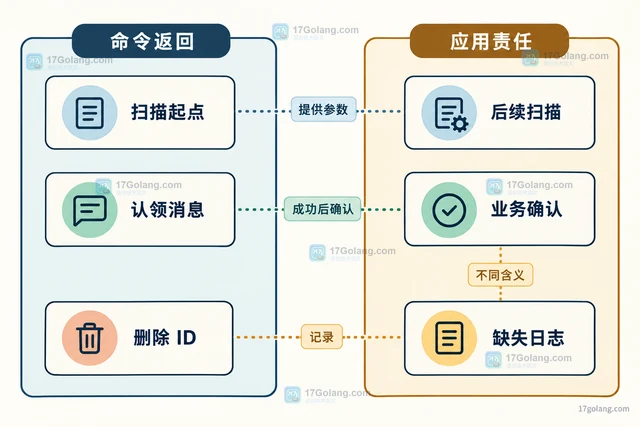
Redis 7.0 起,XAUTOCLAIM 可在扫描时清理消息体已不存在的 PEL 引用,并通过第三段返回 deleted IDs。本文说明三段返回、扫描游标、认领权限与日志分类,并提供独立测试流示例。
-

Redis SORT_RO 是 SORT 的只读变体,适合在只读副本上完成列表、集合或有序集合排序。本文用商品候选列表拆开 LIMIT、GET、ALPHA 的结果边界,解释为什么 SORT 会被导向主节点,以及如何验证查询结果和复杂度风险。
-
使用布隆过滤器防护缓存穿透是因为它能快速判断元素是否可能存在,拦截不存在的请求,保护数据库。Redis布隆过滤器通过低内存占用高效判断元素存在性,成功拦截无效请求,减轻数据库压力。尽管存在误判率,但这种误判在缓存穿透防护中是可接受的。
-

解决Redis启动时内存分配不足问题的方法包括:1.检查系统内存使用情况,必要时增加物理内存或调整Redis配置;2.修改redis.conf文件中的maxmemory参数,限制Redis内存使用;3.配置maxmemory-policy参数,选择合适的内存回收策略;4.增加swap空间或禁用Redis的swap使用;5.通过RedisCluster分散数据存储,降低单节点内存压力;6.使用MEMORYUSAGE命令查找并处理大key。
