-
Redis和MongoDB用于优化数据读写,因为它们各有优势。1)Redis适合数据缓存,其高速读写和内存存储特性适用于频繁读写的场景,如电商网站的购物车信息。2)MongoDB适用于复杂数据存储,其灵活的文档模型和查询能力适合处理大量用户生成内容,如社交媒体的帖子和评论。
-

检测和优化Redis的网络带宽瓶颈可以通过以下步骤:1.使用INFO命令监控网络流量,计算每分钟的输入输出字节数;2.使用PING命令测量延迟;3.优化方法包括启用数据压缩、使用批量操作、优化网络配置、数据分片和使用Redis协议优化。通过这些措施,可以有效提升Redis的性能。
-
对Redis配置文件进行加密保护是必要的,因为配置文件包含敏感信息,泄露可能导致严重安全问题。具体方法包括:1.使用openssl工具加密文件,如“opensslenc-aes-256-cbc-salt-inredis.conf-outredis.conf.enc”。2.将加密文件存储在受保护目录,并将解密密码存储在环境变量或密钥管理系统中。3.利用Redis5.0及以上版本的动态配置功能,在需要时解密和加载配置文件,如“opensslenc-d-aes-256-cbc-inredis.conf.enc-
-

注:陌陌争霸的数据库部分我没有参与具体设计,只是参与了一些讨论和提出一些意见。 在出现问题的时候,也都是由肥龙、晓靖、Aply 同学判断研究解决的。所以我对 Redis 的判断大多也从他
-

在并发式的项目当中,一定要考虑一个缓存穿透的情况。那么什么是缓存穿透呢?简单的说来,就是当大量请求的key根本不在缓存当中,所以导致了请求直接到了数据库上,根本没有经过缓存这
-
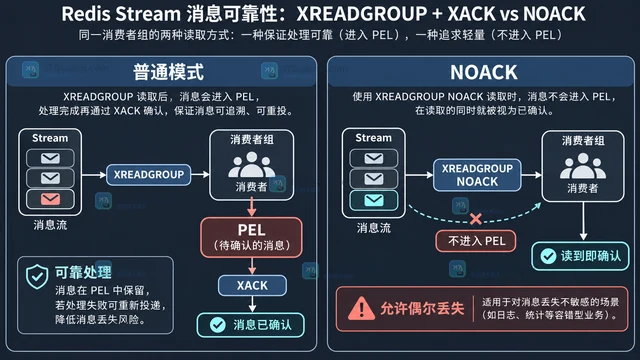
Redis XREADGROUP 的 NOACK 会让消息不进入 PEL,读取时按已确认处理。本文对比普通 XREADGROUP 加 XACK 与 NOACK 的 pending 语义,说明适用场景、可靠性边界和 XPENDING 检查方法。
-
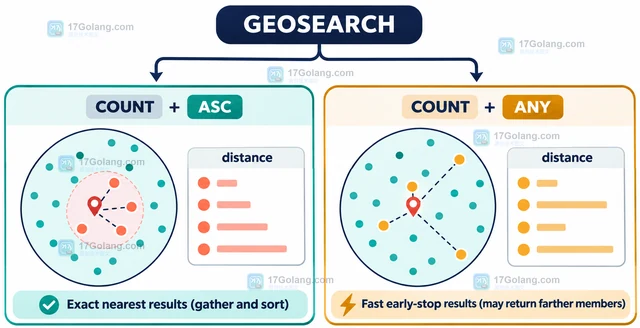
Redis GEOSEARCH 的 COUNT ANY 会在找到足够数量后提前停止,返回项可能不是距离最近的成员。本文用实际查询场景说明 ASC、COUNT、ANY、WITHDIST 的结果契约和生产选择。
-
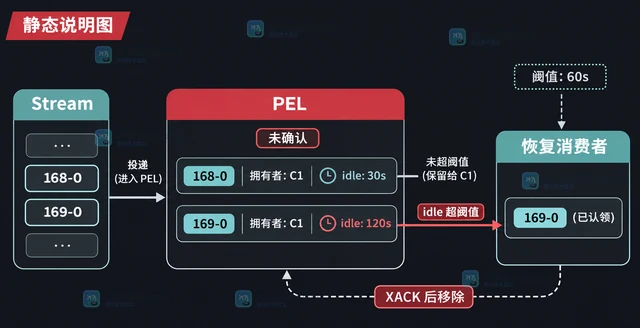
Redis Stream 消费组中的 pending 消息不能直接从新的消费位置重读。本文用 XPENDING 判断空闲消息,再用 XAUTOCLAIM 按游标转移给恢复消费者,并说明 XACK、JUSTID、0-0 和已删除消息的处理边界。
-
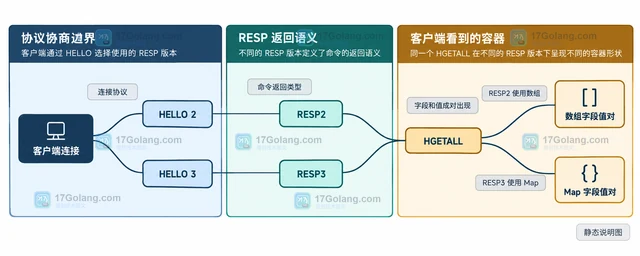
Redis RESP3 并不是把数组随机改成 map,而是协议版本决定了命令返回类型。本文用 HGETALL 说明 RESP2 与 RESP3 的原始差异、HELLO 协商方式、客户端解码边界以及不能依赖 map 顺序的兼容性注意事项。
-
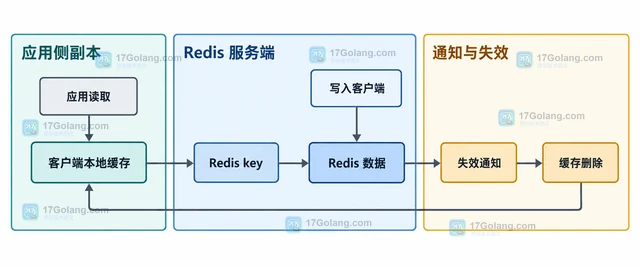
Redis 客户端缓存虽然能减少网络往返,但本地副本不会自动知道服务端数据已经改变。本文说明 tracking 如何按读取过的 key 发送失效通知,比较默认模式与广播模式,并给出断线、连接池和热点写入时的选择建议。
-
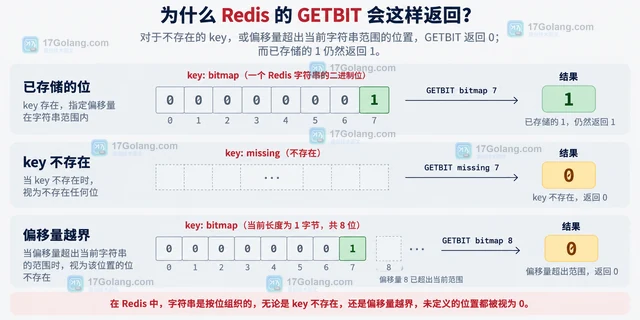
Redis GETBIT 读取不存在的 key 或超出字符串范围的 offset 时会把未定义位置视为 0,因此返回 0 不等于命令失败。本文从参数语义、正常返回、错误分支和 Go 调用示例说明如何正确处理。
-
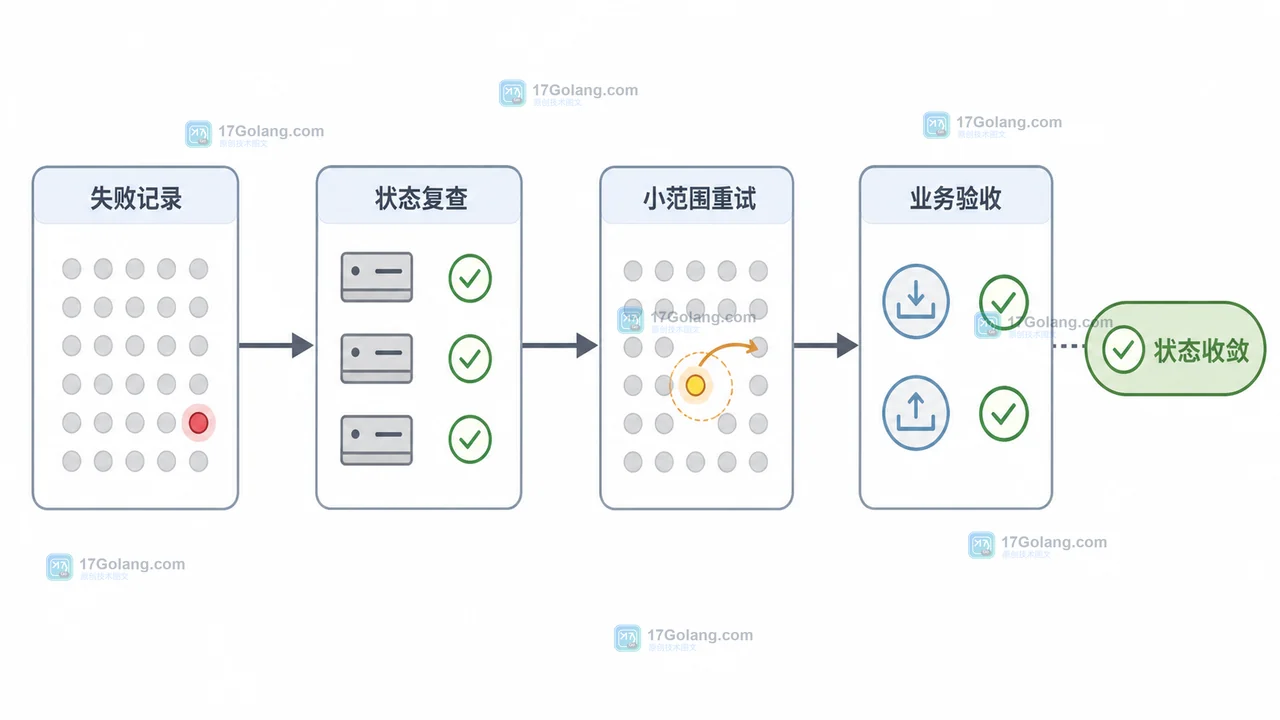
Redis Cluster 扩缩容时,业务抖动通常不是迁移命令本身造成的,而是迁移窗口、客户端重定向、热点槽位和失败收尾没有被单独核对。本文用一套可回滚的检查顺序说明如何安排迁移、观察状态并复查失败槽位。
-
appendfsyncalways会让Redis卡在磁盘上,因其每条命令都强制调用fsync()等待硬件确认落盘,使QPS被钉死在磁盘IOPS天花板;而everysec通过后台线程批量刷盘解耦主线程与I/O,大幅降低IOPS压力但引入秒级延迟毛刺。
-

确保Redis与MySQL数据一致性的方法是:1.写操作优先写入MySQL,然后异步更新Redis;2.读操作优先从Redis获取数据,若Redis无数据则从MySQL读取并更新Redis。这种方法通过消息队列实现异步更新,确保最终一致性,并提高读操作性能。
-

如何使用Redis和Java开发分布式锁功能引言分布式锁是在分布式系统中实现互斥访问共享资源的一种机制。在多个节点同时访问共享资源时,需要确保只有一个节点在访问,其他节点需要等待。Redis是一个常用的内存数据库,具备高性能和高可靠性的特点,非常适合用于实现分布式锁。Redis的setnx命令Redis的setnx命令可以用来设置一个键的值,但是只有在键不存
