
Go语言技术文章
-
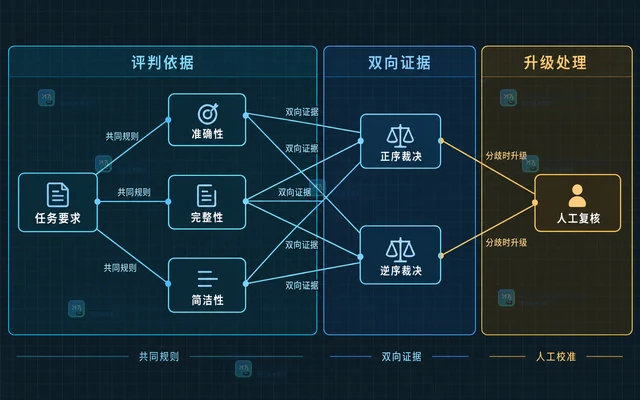 减少大模型裁判的位置偏差,不能只在提示词里要求公平,而应对同一回答对同时运行 A-B 与 B-A 两种顺序,统一还原答案身份,只合并一致判定,并把翻转样本升级为不确定或人工复核。314 收藏
-
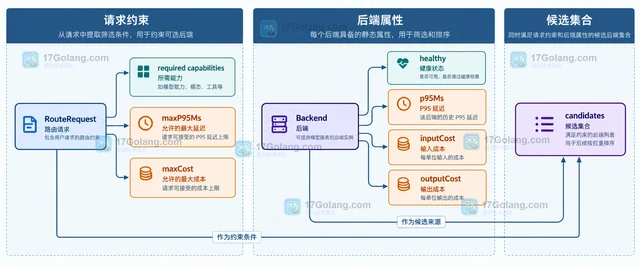 模型路由不应该只看一次调用的速度或单价。把延迟、成本、能力、健康状态和回退边界拆开,先用硬约束筛选,再按业务权重排序,才能让后端选择稳定可解释。314 收藏
-
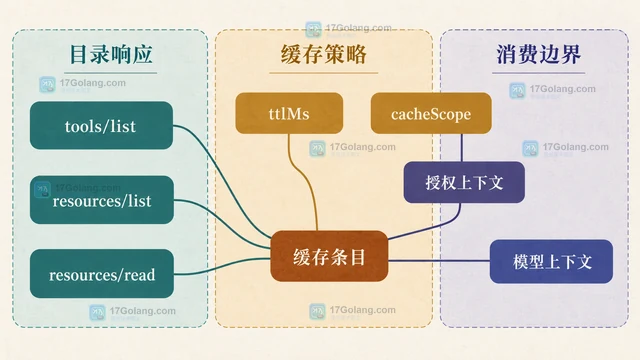 MCP 客户端不应只靠固定 TTL 缓存工具描述和资源。本文按 tools/list、resources/list、resources/read 拆分缓存键,结合 ttlMs、cacheScope 与变更通知设计可恢复的一致性策略。313 收藏
-
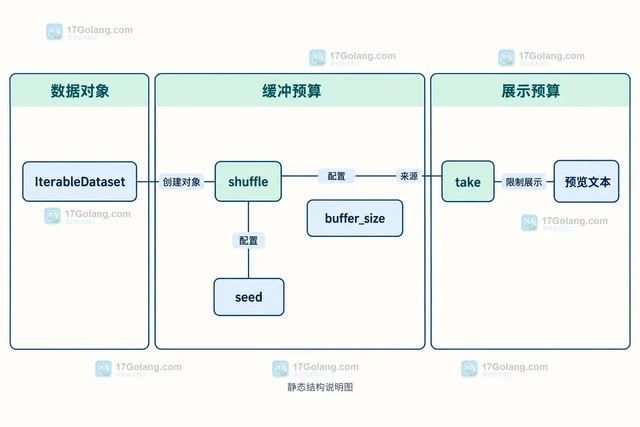 Datasets streaming 大数据集读取教程:使用 JSONL 和 IterableDataset 做有界预览,配置 shuffle 缓冲区,处理空数据与字段错误,避免全量累积内存。313 收藏
-
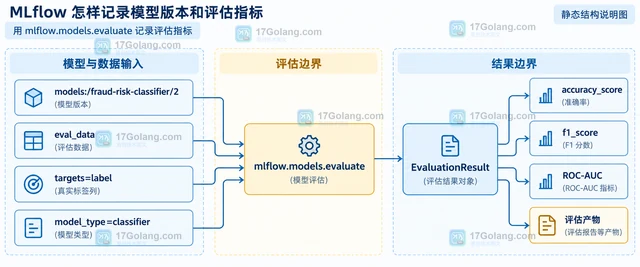 用一个完整的 MLflow Run 串起参数、手工指标、模型制品、注册模型版本和测试集评估结果:先固定实验与注册模型名,再用 registered_model_name 生成版本,最后通过 mlflow.models.evaluate 读取 accuracy、F1 等指标。313 收藏
-
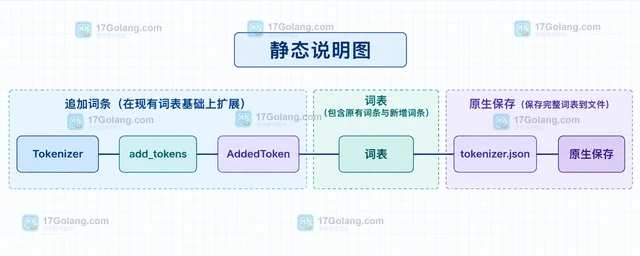 用 Hugging Face Tokenizers 添加领域词条后,如何保存并重新加载自定义词表?本文区分追加词条与重新训练词表,分别说明 save()、from_file() 与 save_pretrained() 的使用边界。311 收藏
-
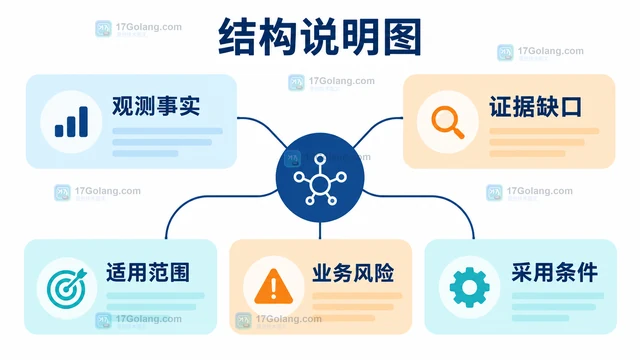 从 SPIFFE 规范与 SPIRE 实现的职责边界出发,说明 registration entry、selector、节点证明、工作负载证明、SVID 和 Workload API 怎样共同完成工作负载身份链。310 收藏
-
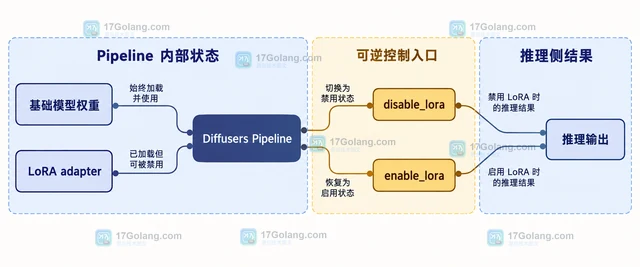 Diffusers 临时禁用 LoRA 不需要卸载权重,调用 disable_lora() 可回到基础模型推理,随后用 enable_lora() 恢复;本文同时区分卸载、删除和多适配器场景。309 收藏
-
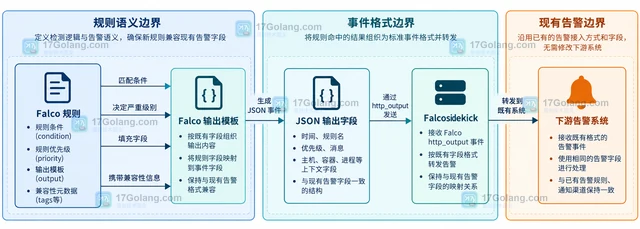 Falco 规则更新不必改造整条告警链。本文用独立规则文件、结构化 JSON 输出和 Falcosidekick HTTP 转发,说明如何让新规则接入既有告警系统,并按 rule、priority、tags 与 output_fields 做更新后的复查。309 收藏
-
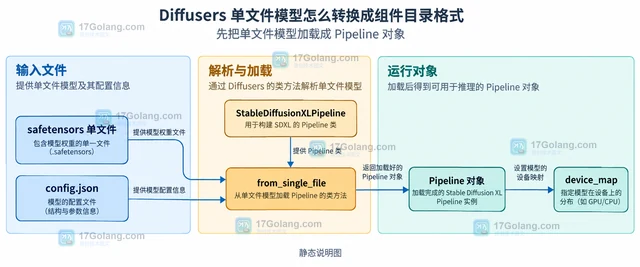 Diffusers 单文件模型不能靠改后缀变成组件目录。正确做法是用匹配的 Pipeline.from_single_file() 读取权重,再用 save_pretrained() 保存配置、组件子目录和权重文件;配置推断失败时显式提供 config。308 收藏
-
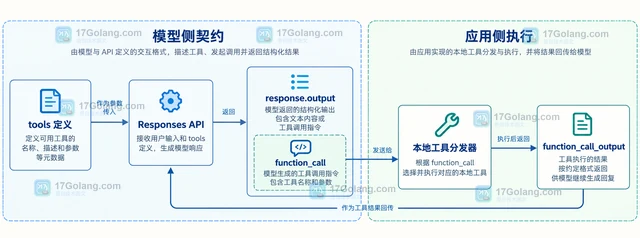 Responses API 不会替应用执行自定义函数。正确做法是读取 function_call,执行本地工具,再用同一个 call_id 回传 function_call_output,让模型继续处理下一次工具调用或生成最终答复。307 收藏
-
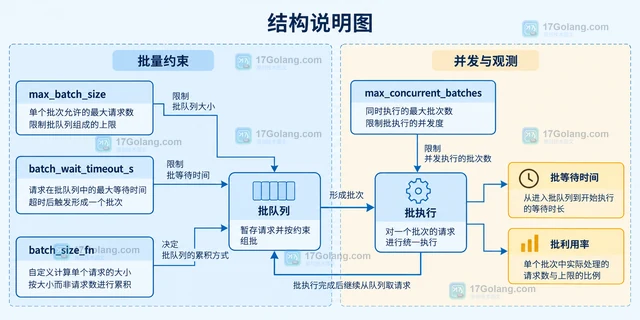 本文围绕 Ray Serve DeploymentHandle 的异步批处理,说明 DeploymentResponse 的提交与等待方式、@serve.batch 的参数边界、等长结果约束,以及如何用批等待和利用率指标判断参数是否合适。307 收藏
-
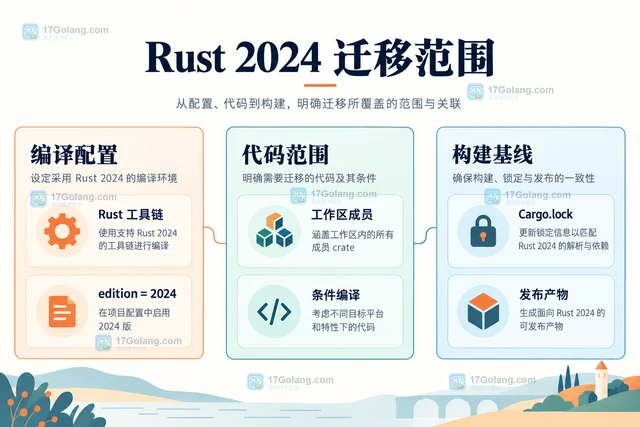 Rust 2024 Edition 迁移应先保留构建基线,在旧 Edition 下应用兼容修复,再修改清单并覆盖项目配置。本文说明依赖更新、条件编译、unsafe 人工责任和回退资料的准备方法。307 收藏
-
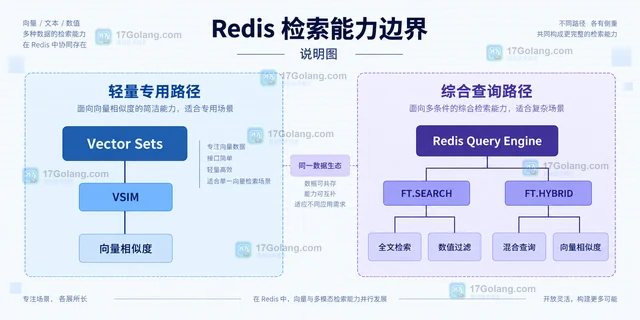 Redis 当前文档已将 Vector Sets 列入数据类型体系。本文从数据模型、命令体验和 Query Engine 分工三方面,解释这一变化对 AI 检索架构意味着什么。306 收藏
-
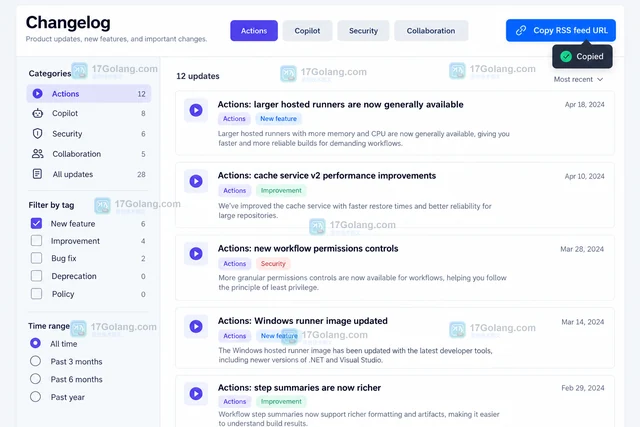 GitHub Changelog 的 RSS 是全量入口,真正减少团队噪音要靠主题关键词、阅读器规则和 GitHub Notifications 的仓库级过滤配合。本文给出一套可以直接落地的订阅分流方法。306 收藏