-
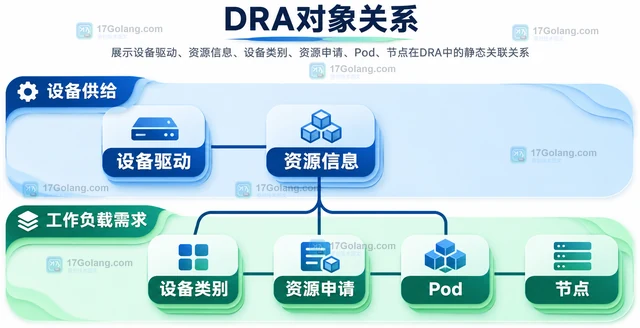
结合 CNCF 公告与 Kubernetes 文档,解释 DRA 如何连接设备类别、资源申请和 Pod,并用 AI 任务规划示例说明采用职责、等待处理与适用范围。
-
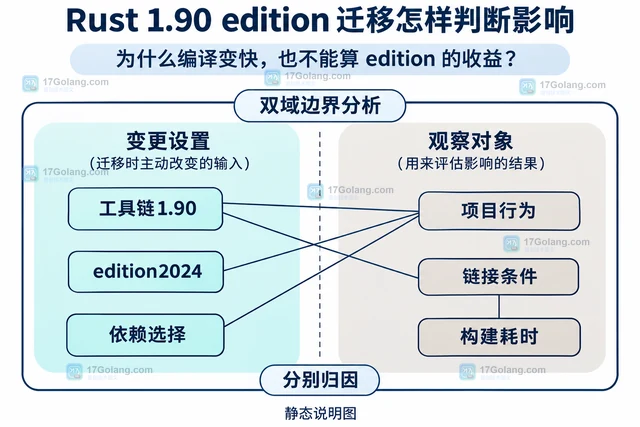
Rust 1.90 工具链升级与 edition 2024 切换应分开判断。以三组对照记录说明迁移顺序、cargo fix 覆盖范围、临时值行为及构建性能归因,避免把链接器收益算作 edition 效果。
-
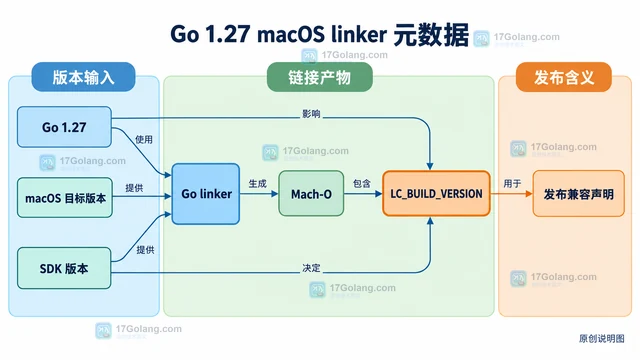
Go 1.27 的 macOS linker 新增 -macos 与 -macsdk 选项,用于控制 Mach-O 的 LC_BUILD_VERSION 元数据。本文解释两个参数的作用、默认值、内部链接边界和 go build 的使用方式。
-
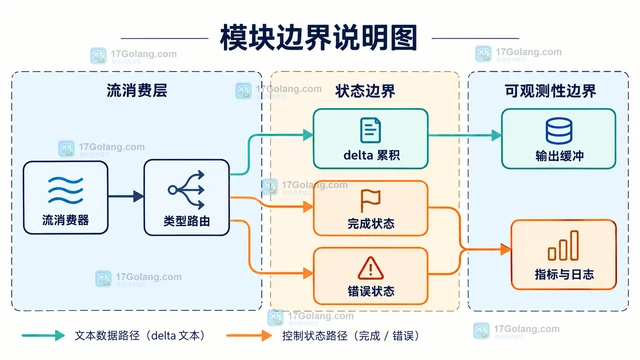
OpenAI API 的 Responses 流由带类型的语义事件组成。本文说明如何只提取 response.output_text.delta 文本增量,并分别处理 response.completed 与 error,避免控制事件混入回答。
-
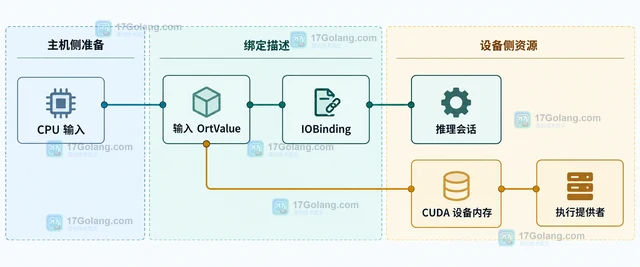
ONNX Runtime 普通 run 路径可能让输入输出在 CPU 与加速设备之间来回搬运。本文以 Python IOBinding 为主线,说明如何准备设备 OrtValue、预分配固定形状输出、调用 run_with_iobinding,并区分动态输出、CPU 回读和内存生命周期边界。
-
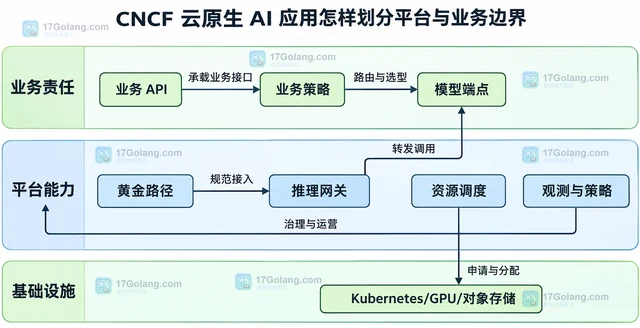
云原生 AI 应用不应把业务规则、模型运行和 GPU 集群揉成一个平台。本文用三层边界说明业务团队、AI 平台团队与基础设施团队各自负责什么,并给出模型生命周期、反例和落地判断清单。
-
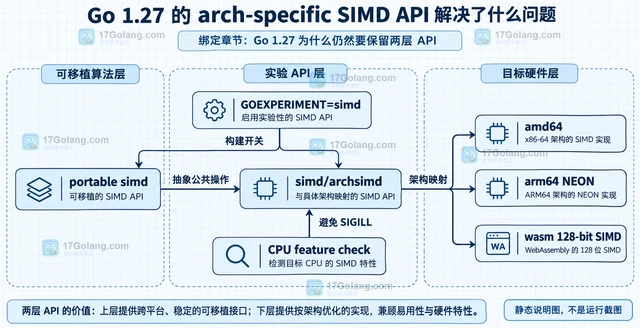
Go 1.27 的 simd/archsimd 继续以实验性 API 提供架构专用 SIMD 能力,新增 arm64 NEON 与 WebAssembly 128 位支持。本文解释它如何减少手写汇编摩擦、为什么仍要区分 portable simd,以及启用开关、CPU 特性和回退路径带来的采用边界。
-
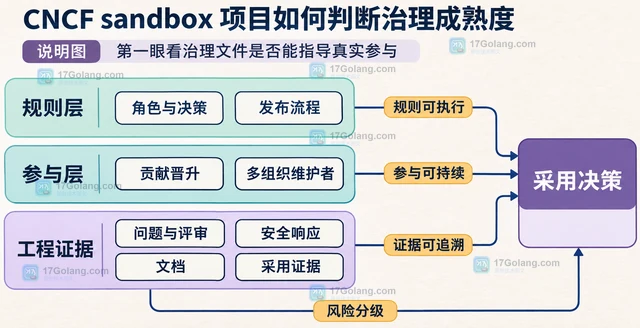
CNCF Sandbox 是早期项目的生态培育阶段,不等同于生产稳定性背书。本文从生命周期定位、治理规则、多组织参与、技术文档与安全证据四个方面,说明如何判断项目是否适合试验、内部试点或生产关键路径。
-
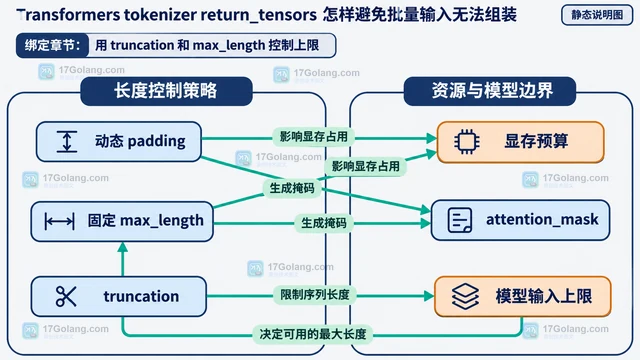
Transformers tokenizer 的 return_tensors 只负责把编码结果转换成张量,不会自动解决批量文本长度不同的问题。本文从批量输入无法组装的现象出发,说明 padding、truncation、max_length 和 attention_mask 如何配合,并给出动态长度与固定长度的选择方法。
-
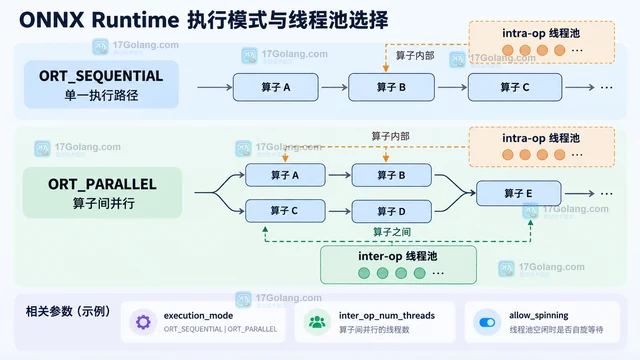
ONNX Runtime 的线程数不是只改一个参数:intra_op_num_threads 控制算子内部并行,inter_op_num_threads 只在 ORT_PARALLEL 下控制算子之间并行。本文用 Python SessionOptions 说明两类线程池、等待策略和多会话场景的配置边界。
-
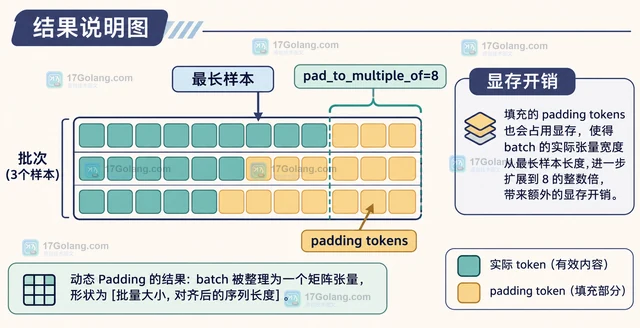
用 Transformers DataCollatorWithPadding 在 batch 内按最长序列动态补齐,区分 truncation、padding、max_length 和 pad_to_multiple_of,减少无效 token 并排查显存异常。
-
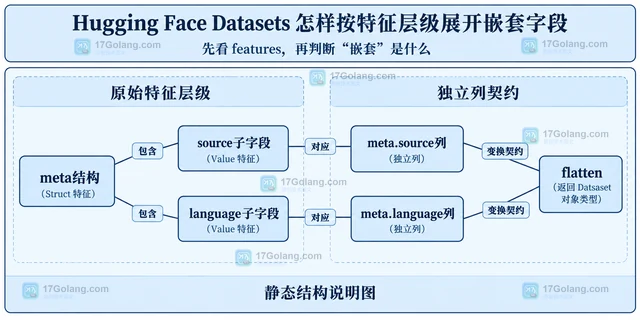
Hugging Face Datasets可用flatten把struct子字段展开成带层级前缀的独立列。本文通过原创样本区分Dataset与Features展开、列表拆行和索引整理,并说明下游列名契约。
-
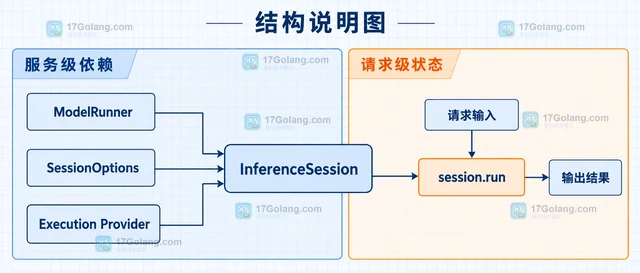
ONNX Runtime 服务中应按模型和会话配置创建一次 InferenceSession,再复用 session.run;并发数仍需按执行提供程序、输入状态和资源预算限制。本文用架构模式说明单会话、信号量、请求级输入与 DirectML 边界。
-
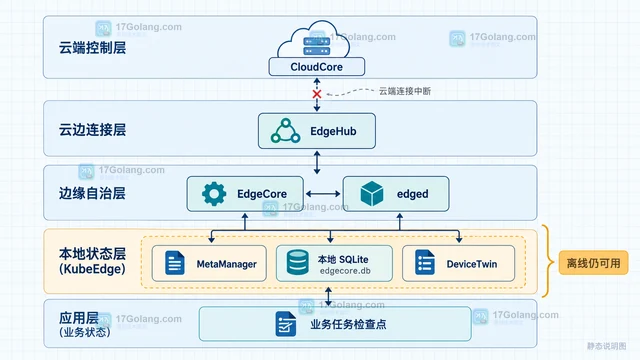
KubeEdge 断云时可以依靠 EdgeCore 的本地元数据和设备状态继续自治,但业务任务进度仍应由应用自己持久化。本文按前置条件、检查点、部署和断连恢复步骤,拆开这两层状态并给出可执行的设计方法。
-
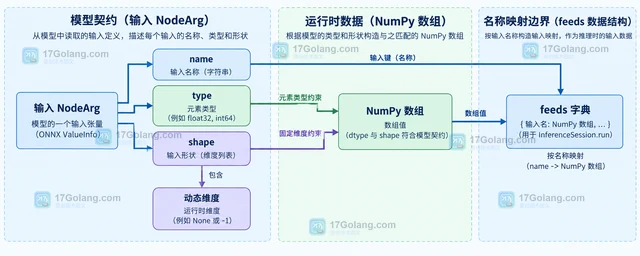
ONNX Runtime 加载模型后,可以通过 InferenceSession.get_inputs() 读取每个输入 NodeArg 的名称、类型和形状。本文说明如何识别动态维度,并按真实输入名构造 feeds 映射。
