-
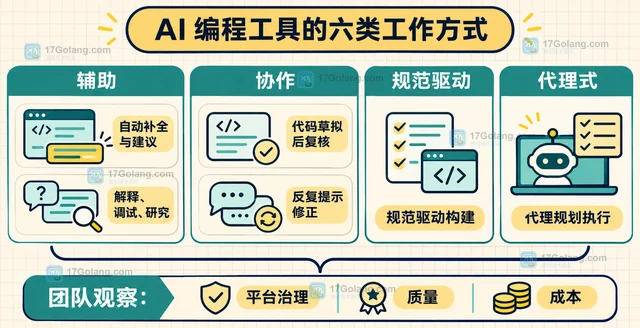
CNCF 与 SlashData 的 Q3 2026 云原生开发者调查显示,75% 的云原生开发者使用 AI 编程工具,非云原生开发者为 55%。本文拆开调查口径、使用方式和平台工程信号,说明哪些是事实、哪些只是合理推断,以及团队可以怎样继续观察。
-
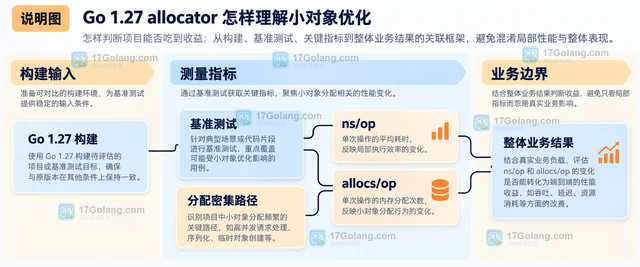
Go 1.27 为不超过 80 字节的部分分配引入尺寸专用路径,局部分配最高可快约 20%~30%。本文说明它如何工作、怎样用基准判断收益,以及为什么不能把它理解成所有内存都会减少。
-
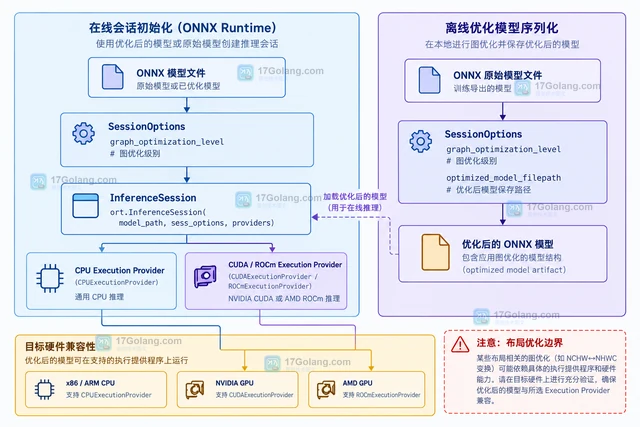
ONNX Runtime 的图优化等级绑定在 SessionOptions 上,EXTENDED 会包含 basic,ALL 还包括 layout。本文给出指定 InferenceSession 的 Python 配置、在线与离线优化的边界,以及按 Execution Provider 和目标硬件做基准、回退的实用方法。
-
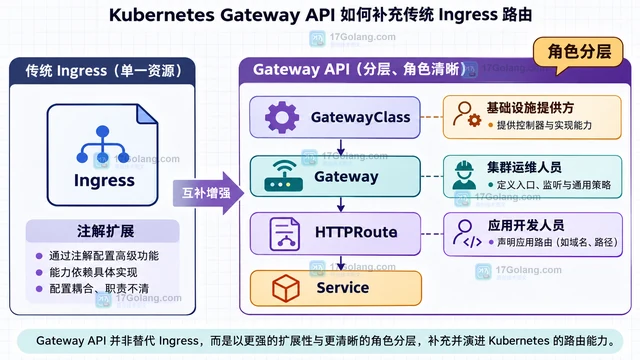
Kubernetes Ingress API 已冻结,Gateway API 通过 GatewayClass、Gateway、HTTPRoute 的角色分层,把主机、路径、请求头、权重和跨命名空间绑定等路由能力表达为更清晰、可移植的资源关系。
-
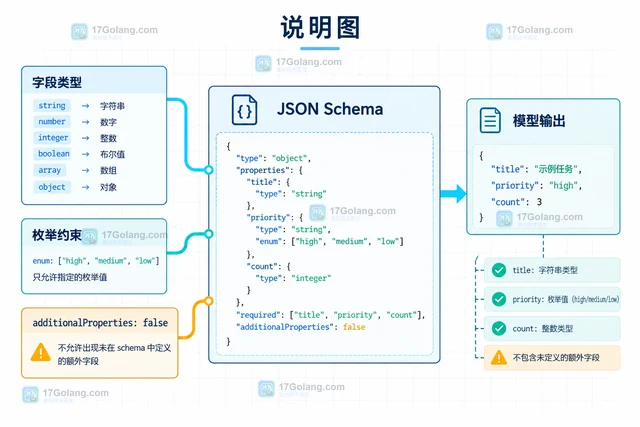
OpenAI API 需要固定输出格式时,应优先使用 Structured Outputs,在 Responses API 的 text.format 中声明 JSON Schema,并处理拒答、截断和旧版参数迁移边界。
-
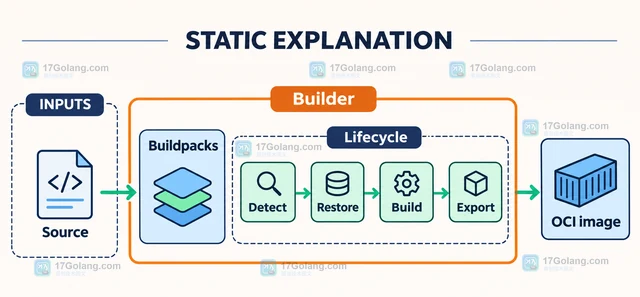
Cloud Native Buildpacks 通过 builder、buildpacks 和 lifecycle 把应用源码转换为 OCI 镜像。本文说明如何固定 builder、选择 pack build 导出目标、理解缓存与运行基镜像边界,并给出稳定交付检查清单。
-
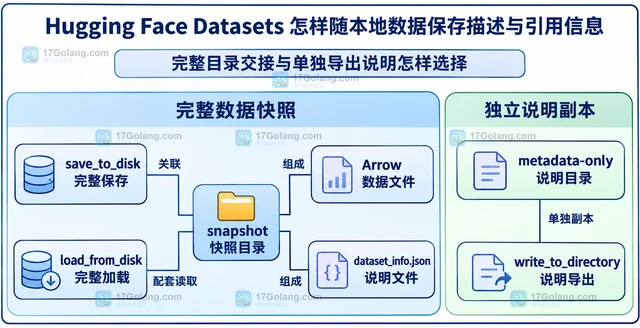
Hugging Face Datasets 可通过 DatasetInfo 绑定描述与引用,再用 save_to_disk 随本地快照保存。本文给出人工演示数据的完整写法,区分配套加载、单独导出说明及交付目录的使用边界。
-
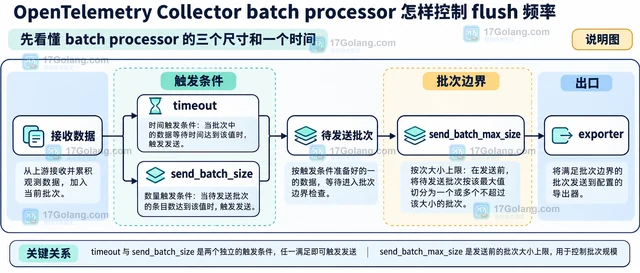
OpenTelemetry Collector 的 batch processor 同时受时间和数量触发。本文说明 timeout、send_batch_size、send_batch_max_size 如何共同影响 flush 频率,并补充 memory_limiter、metadata 分片和 exporter-level batching 的迁移边界。
-
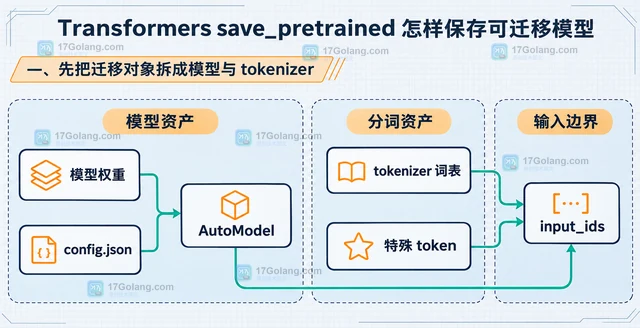
用 Transformers 的 save_pretrained 分别保存模型和 tokenizer,整理权重、配置与词表的目录关系,并说明如何在新环境中恢复。
-
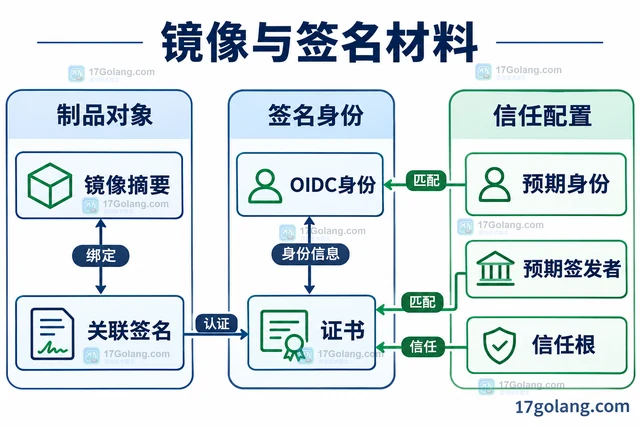
围绕 OCI 镜像摘要、Cosign 签名材料与身份策略,说明签名和独立发布验证的职责、跨注册表复制及多平台边界,以及失败和回滚时应保留的发布记录。
-
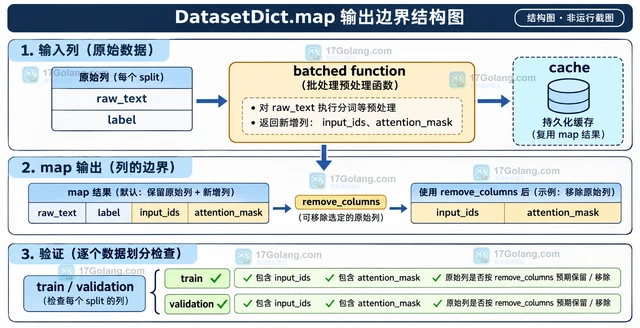
DatasetDict.map 会把同一个预处理函数应用到 train、validation 等分片,返回的仍是 DatasetDict。本文用 batched 函数、remove_columns 和逐分片检查,说明统一预处理的写法、缓存边界与常见误区。
-
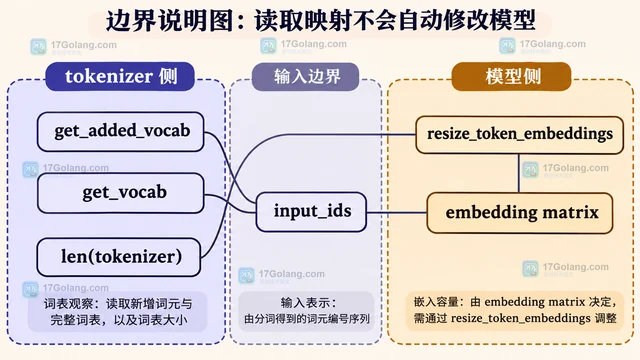
用 Transformers 的 get_added_vocab 读取新增词元到 token id 的映射,并区分 get_vocab、add_tokens 返回值与模型嵌入矩阵之间的边界。
-
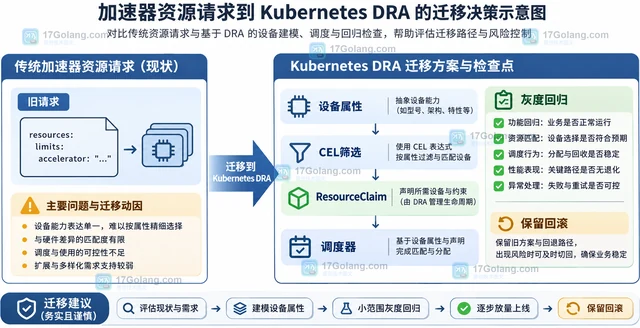
CNCF 2026 年公告把 Kubernetes 动态资源分配和异构加速器能力放到 AI 基础设施演进中。本文结合 Kubernetes 官方 DRA 文档,拆解能力边界、对象关系、升级风险和分阶段迁移清单。
-
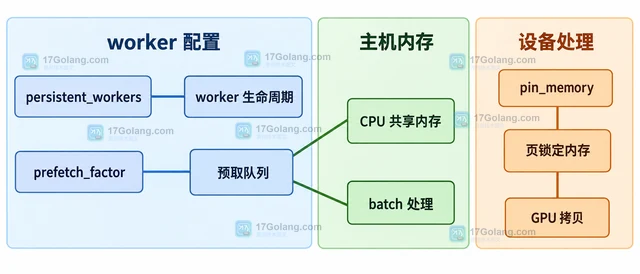
PyTorch DataLoader 的多进程预取会同时受到 num_workers、prefetch_factor 和 batch_size 影响。本文给出按共享内存预算限制预取批次的配置方法,并区分 worker 生命周期、pin_memory 与真实内存瓶颈。
-
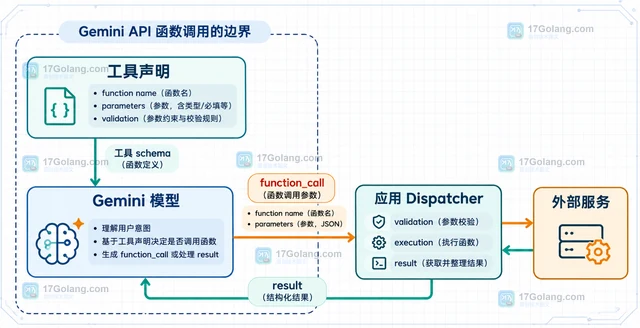
用 Gemini API 串联多个工具时,关键是把工具声明、模型决策、本地执行和结果回传拆开,并用依赖顺序控制调用链。
