-
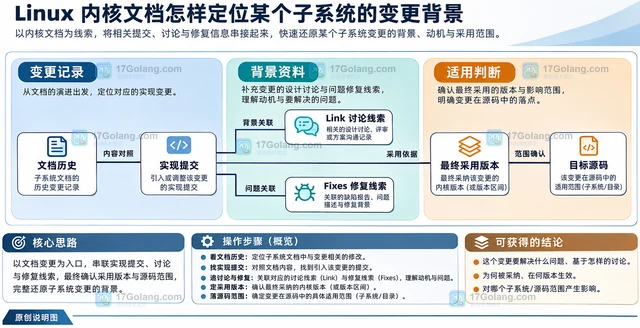
从内核来源与版本出发,利用子系统设计文档、源码位置、维护者索引及提交讨论追溯变化背景,并区分上游提交、补丁提案和下游实际包含的变更。
-
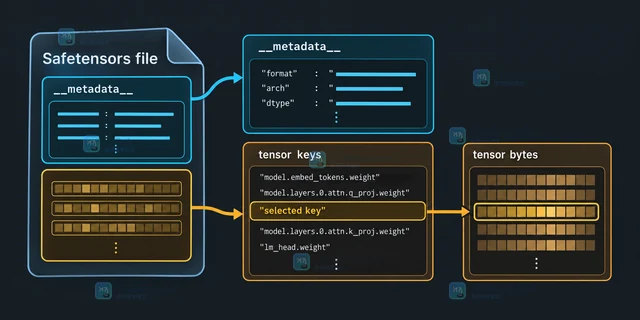
Safetensors 文件可以先通过 safe_open 查看权重键和文件级元数据,再按目标键读取单个张量。本文说明 get_tensor、get_slice、metadata 的分工,并处理缺键、空元数据和分片模型边界。
-
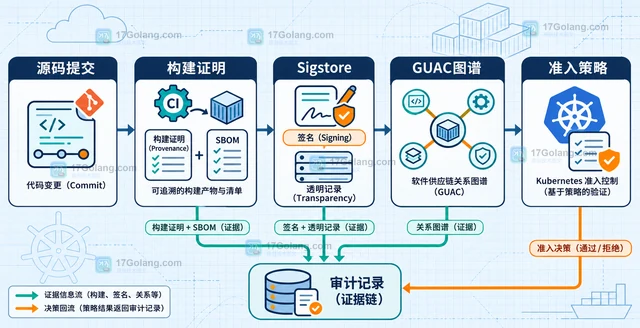
SLSA、in-toto、Sigstore、GUAC 与 Tekton Chains 解决的不是同一个问题。本文按证据产生、签发、汇总和准入四层拆开它们的职责,给出一条可落地的最小组合路径。
-
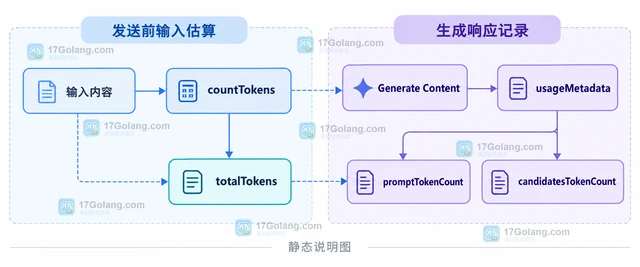
Gemini API 的 countTokens 只用于发送前估算输入规模,生成响应中的 usage metadata 才记录本次请求的实际输入、输出、缓存、工具调用与思考 token。本文用 Python 区分两类数字及其使用场景。
-
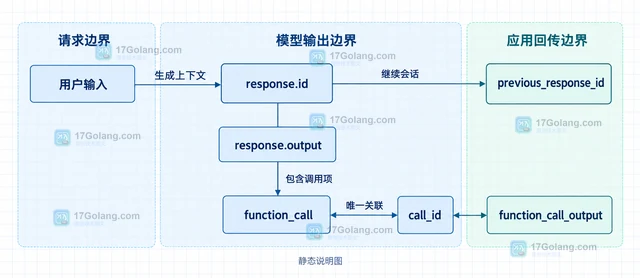
Responses API 的 tool call 不是把一段文本塞回对话,而是用 response.output、function_call、call_id 与 function_call_output 维持调用关联。本文从安全边界、回传控制和审计记录说明状态怎样串联。
-
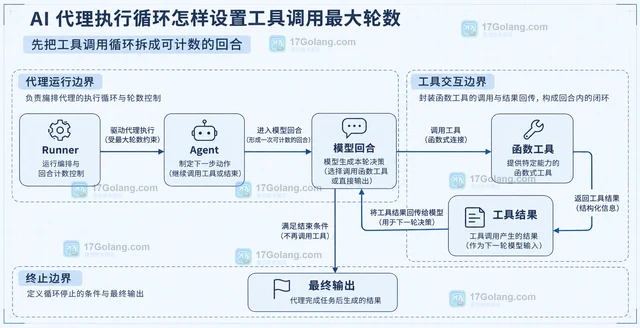
AI 代理的工具调用循环应把 max_turns 当作模型回合硬上限,再分别观测工具错误率、延迟与成本。本文用 OpenAI Agents SDK 的 Runner 示例说明上限触发、受控退出、并发工具和嵌套代理的预算边界。
-
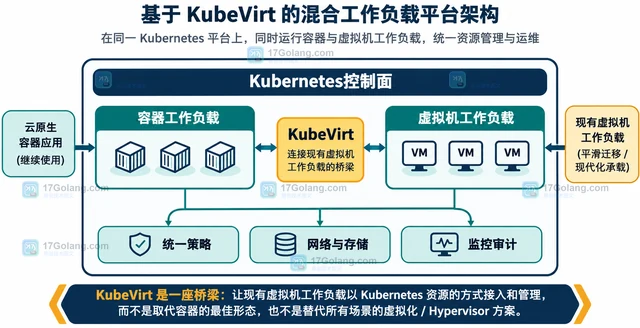
KubeVirt 的价值不在于替代所有容器或传统虚拟化,而在于把难以容器化的虚拟机纳入 Kubernetes 的资源、权限、网络、存储和审计体系。本文从混合工作负载定位出发,整理一份生产落地边界清单。
-
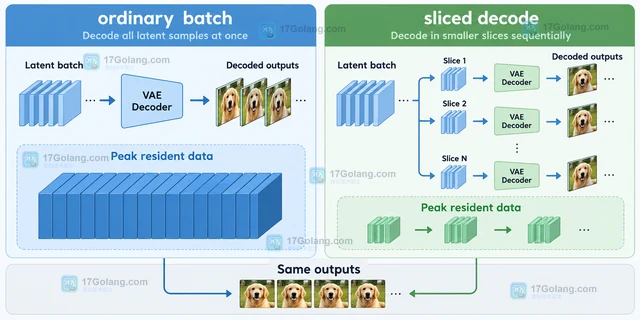
本文围绕 Diffusers enable_vae_slicing,说明多图 VAE 解码的显存峰值来源、管线级启用方式、受控测量方法和速度与显存之间的取舍。
-
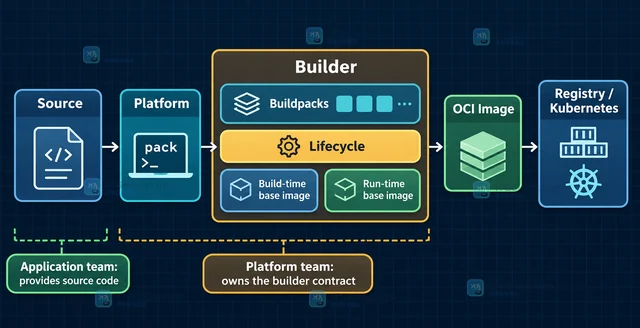
Cloud Native Buildpacks进入CNCF毕业项目阶段后,变化不只是项目名片更成熟,更重要的是交付链开始有机会把构建责任从分散的Dockerfile维护转向可治理的builder契约。本文拆解这一信号对平台团队、应用团队和CI流程的实际影响,并给出渐进式采用与回退清单。
-
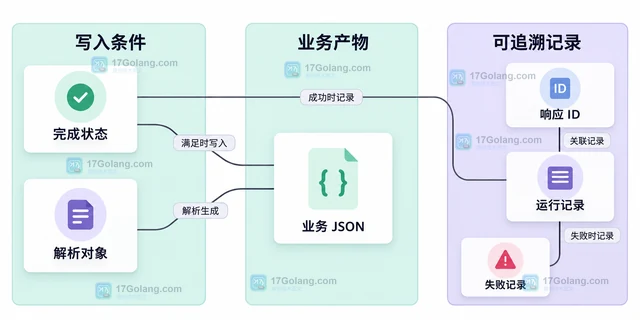
本文用 Python 说明 Responses API 如何按结构化 Schema 取得解析对象,并把业务字段、响应状态和运行记录分开保存为 JSON。
-
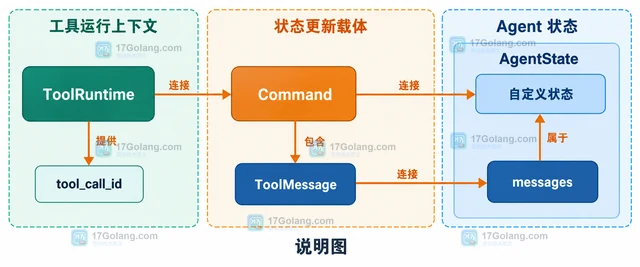
LangChain 的工具调用不是把返回值自动塞进任意列表,而是要用 AIMessage 中的调用记录和匹配的 ToolMessage 组成连续消息历史;工具还需要改状态时,再通过 Command 同时写回 messages 和自定义状态。
-
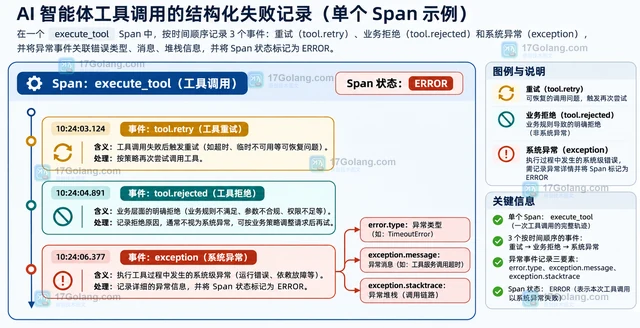
用 OpenTelemetry 把 AI 代理、模型、工具和下游依赖串成一棵 Trace 树,并用结构化事件记录重试、业务拒绝和异常原因。
-
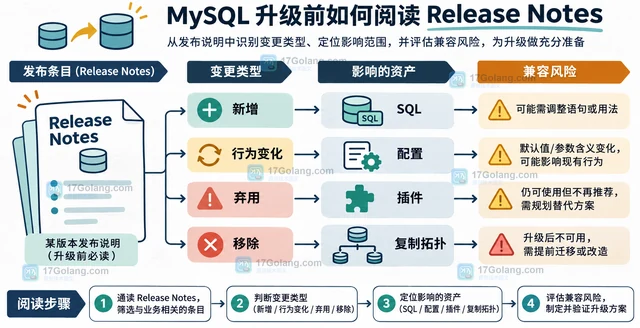
MySQL 升级前不能只看新增功能,要把 Release Notes 中的行为变化、弃用和移除项映射到 SQL、配置、插件、认证与复制拓扑,再结合 Upgrade Checker、预升级检查和目标环境回归形成兼容矩阵。
-
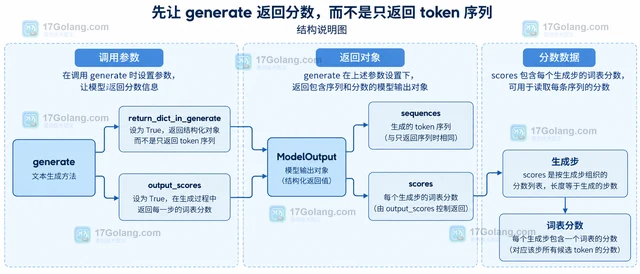
Transformers generate 默认主要返回生成序列。本文说明如何打开 return_dict_in_generate 与 output_scores,使用 compute_transition_scores 对齐每个生成 token 的分数,并区分 decoder-only、encoder-decoder 与 beam search 的边界。
-
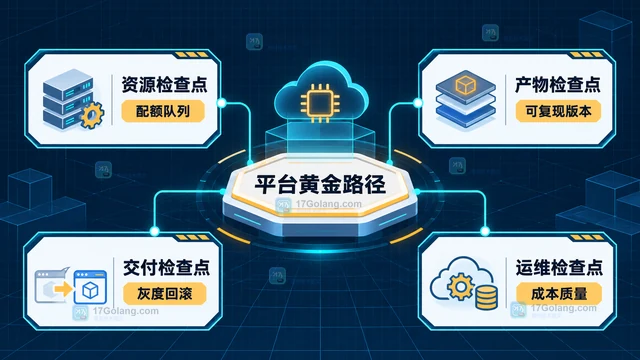
云原生平台强调端到端 AI 工作流,不是要让 Kubernetes 取代模型框架,而是把数据、训练、模型制品、推理交付、观测与治理连接成可追踪的工程路径。本文结合 CNCF 近期资料,拆解平台化需求的来源、评估检查点和渐进式落地顺序。
